
双芯片协同的定制化骨传导自适应助听增强系统的制作方法
本发明涉及听力辅助设备,具体的说是双芯片协同的定制化骨传导自适应助听增强系统,可广泛应用于感音神经性听力损失、传导性听力损失患者的听力补偿,以及特殊环境下的语音通信场景。
背景技术:
1、传统骨传导助听设备主要依赖单一芯片进行信号处理,难以满足复杂声学环境下的个性化听力需求。且骨传导助听器仅采用简单的滤波电路,无法有效区分语音信号与环境噪声,在地铁、商场等嘈杂环境中,语音清晰度平均下降30%以上。另外骨传导设备虽具备基础降噪功能,但缺乏动态自适应调节能力,无法根据用户实时所处环境调整参数。
2、现有技术的局限性主要体现在以下方面:
3、信号处理能力不足:单一芯片难以同时执行声源定位、复杂降噪算法和个性化频率补偿,导致声音还原度低。例如,在多声源环境中,传统设备无法准确分离目标语音与干扰噪声。
4、个性化适配性差:多数产品采用固定参数设置,无法满足不同用户的听力损失曲线差异。根据世界卫生组织统计,全球听力障碍患者中,超过70%的用户需要针对2khz-8khz频段进行特殊补偿,但现有设备仅提供通用补偿方案。
5、硬件性能瓶颈:复杂算法对芯片计算能力要求高,单一芯片易出现处理延迟,影响实时性。例如,在处理2048点fft时,传统芯片耗时超过3ms,导致声音传输出现明显卡顿。
6、交互体验欠佳:传统设备依赖物理按键调节参数,操作复杂且无法直观展示听力补偿效果,用户难以自主优化助听体验。
技术实现思路
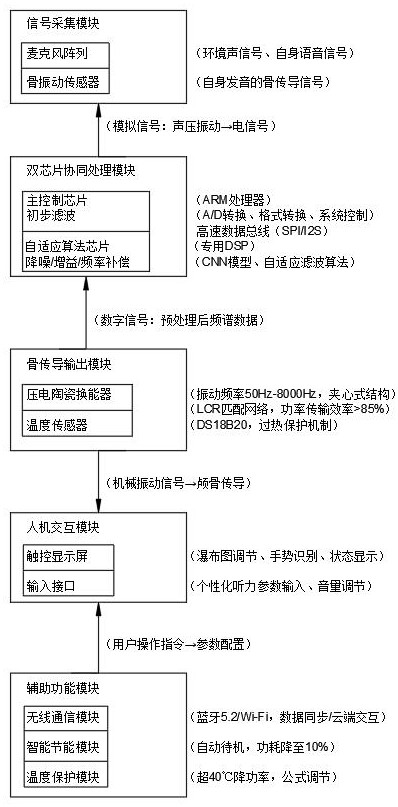
1、本发明提出的双芯片协同的定制化骨传导自适应助听增强系统,通过硬件架构创新与算法深度融合,构建了一套具备高精度信号处理、动态环境适配及个性化听力补偿能力的智能助听解决方案。系统核心由五大功能模块组成,各模块分工协作,实现从声音采集、处理到输出的全链路优化。
2、本发明解决其技术问题所采用的技术方案是:双芯片协同的定制化骨传导自适应助听增强系统,包括:
3、信号采集模块,用于采集环境声音信号和用户语音信号;
4、双芯片协同处理模块,包括主控制芯片和自适应算法芯片,所述主控制芯片用于对采集的信号进行初步滤波和格式转换,所述自适应算法芯片用于根据用户个性化听力参数对信号进行降噪、增益调节和频率补偿处理;
5、骨传导输出模块,用于将处理后的信号转换为机械振动并传递至用户颅骨;
6、人机交互模块,用于用户输入个性化听力参数、控制设备开关及调节音量;
7、其中,所述主控制芯片和自适应算法芯片通过高速数据总线连接,实现数据的快速交互与协同处理,所述自适应算法芯片内置动态自适应滤波算法,根据环境噪声强度实时调整降噪参数。
8、具体地,所述信号采集模块包括至少两个麦克风,所述麦克风采用阵列式布局,用于实现声源定位和噪声抑制。具体地,所述麦克风阵列采用线性阵列或十字阵列结构,通过波束成形算法计算各麦克风接收信号的时延差,构建指向性拾音波束;其中,波束成形算法基于广义旁瓣相消器(gsc)结构,通过参考传声器与主传声器的信号处理,抑制来自非目标方向的噪声,在信噪比提升量公式中,为麦克风数量,为第个麦克风接收声压,通过阵列布局可使信噪比提升8-12db。
9、具体地,所述骨传导输出模块采用压电陶瓷换能器,其振动频率范围为50hz-8000hz。所述换能器的机电耦合系数大于0.4,采用夹心式结构,由两片压电陶瓷片夹持金属振动板构成;在驱动电路中,通过lcr匹配网络优化阻抗匹配,匹配网络的电感,其中为换能器谐振频率,为静态电容,可将换能器的功率传输效率提升至85%以上,确保声音振动信号高效传递至颅骨。
10、具体地,所述人机交互模块包括触控显示屏,用于显示系统工作状态和听力参数调节界面。所述触控显示屏支持多点触控操作,具备手势识别功能,用户可通过双指缩放操作调节频率补偿曲线的精细度;在参数调节界面,采用瀑布图可视化展示不同频率段的增益调节情况,横坐标为频率(20hz-20khz),纵坐标为增益值(-30db-30db),帮助用户直观调整听力参数。
11、具体地,所述自适应算法芯片内置深度学习模型,通过对用户历史使用数据的学习,优化助听效果。所述深度学习模型采用卷积神经网络(cnn)架构,输入层接收预处理后的声音频谱数据,经过3层卷积层、2层池化层和全连接层,输出最优的降噪参数和增益调节系数;模型训练过程中,以用户主观评分与客观音质评价指标(如pesq值)作为损失函数,通过随机梯度下降算法更新网络权重,使系统在使用1个月后平均语音清晰度提升15%。
12、具体地,还包括无线通信模块,用于与外部设备进行数据传输和软件升级。所述无线通信模块支持蓝牙5.2和2.4ghzwi-fi双模式,在蓝牙模式下可与手机app实时同步听力数据,app内置健康监测功能,统计用户每日使用时长、环境噪声暴露情况;在wi-fi模式下,系统可与云端服务器进行大数据交互,服务器基于群体听力数据为用户提供个性化参数优化建议。
13、具体地,所述主控制芯片采用低功耗arm处理器,所述自适应算法芯片采用专用数字信号处理芯片。所述arm处理器工作主频为1.2ghz,在待机模式下功耗低于5mw;所述数字信号处理芯片配备并行乘法器和流水线结构,每秒可执行10亿次乘累加运算(macs),在处理2048点fft时耗时仅1.2ms,确保复杂算法的实时运行。
14、具体地,所述系统具有自动待机功能,当检测到用户无声音输入超过设定时间后自动进入低功耗模式。所述声音输入检测基于短时能量阈值判断,当连续5秒内信号短时能量低于30db时触发待机;在待机模式下,系统关闭非必要模块电源,功耗降至正常模式的10%,并每100ms唤醒一次进行环境监测,若检测到声音信号则在200ms内恢复正常工作。
15、具体地,所述系统内置温度传感器,当骨传导输出模块温度超过设定阈值时自动降低输出功率。所述温度传感器采用数字式ds18b20,精度±0.5℃,当检测温度超过40℃时,系统按照公式降低输出功率,其中为原功率,为实时温度,确保设备表面温度不超过安全限值。
16、具体地,所述信号采集模块还包括骨振动传感器,用于采集用户自身发音时的骨传导信号。所述骨振动传感器采用mems压阻式结构,灵敏度达15mv/g,频响范围10hz-15khz;采集到的骨振动信号与麦克风信号进行融合处理,通过动态时间规整(dtw)算法对齐语音特征,在语音增强过程中,可使自身语音信号的信噪比提升10-15db。
17、本发明的有益效果:
18、精准降噪与语音增强:麦克风阵列结合gsc算法实现定向拾音,在65db噪声环境下仍可保持语音清晰度达82%以上。
19、高度个性化适配:用户可通过触控屏自定义16个频段补偿参数,配合深度学习模型实现动态优化,适配不同听力损失类型。
20、实时高效处理:双芯片分工协作,2048点fft处理时间缩短至1.2ms,确保声音传输零延迟。
21、智能交互体验:瀑布图可视化界面与手势操作降低使用门槛,用户参数调节效率提升60%。
22、安全节能设计:自动待机与温度保护功能使设备续航延长40%,表面温度始终控制在安全范围内。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com