
一种数字人长视频AI配音口型与情绪联动生成方法与流程
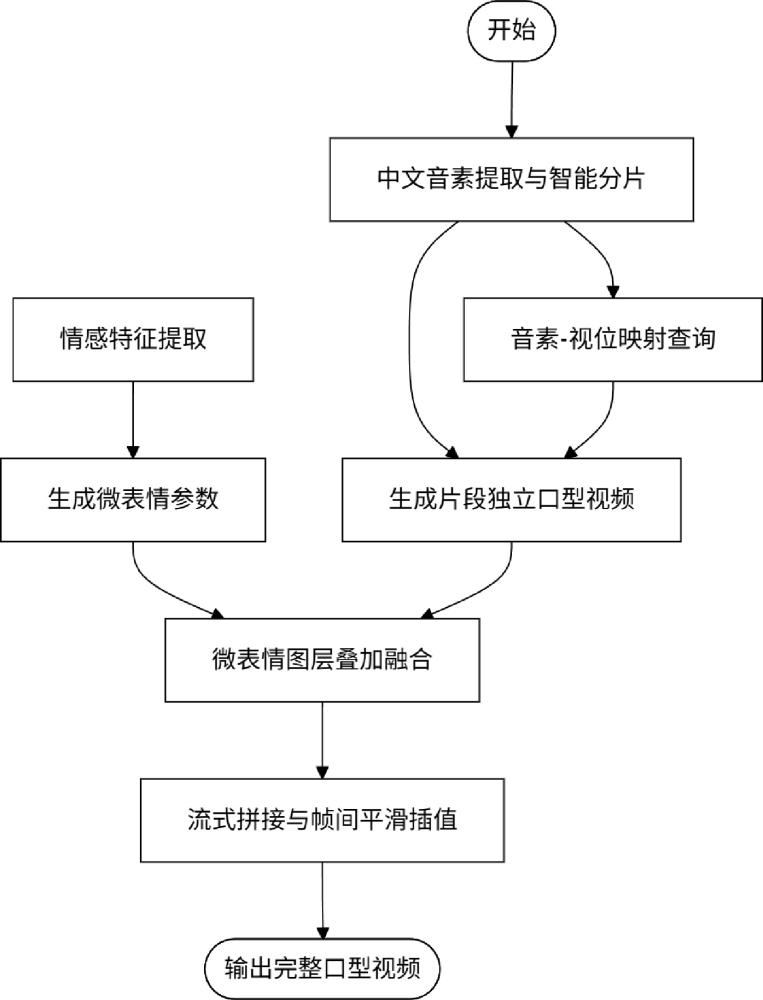
本发明涉及人工智能视频生成,尤其涉及一种数字人长视频ai配音口型与情绪联动生成方法。
背景技术:
1、在现有的aigc(artificial intelligence generated content)视频生成领域,数字人/虚拟形象配音对口型技术主要有两类实现方案:第一类是基于传统音视频特征提取的形变方法,如wav2lip等,通过神经网络学习音频频谱与面部关键点的映射关系;第二类是基于3d人脸重建的渲染方案,如nerf、3dmm等。
2、随着精讲长音频在文创平台(如文旅解说、数字人直播、知识付费等)的应用需求爆发,现有技术方案普遍存在以下局限性:
3、1、中文发音匹配度差:现有模型大多基于英文语音数据训练,在生成中文声母(如zh、ch、sh)、韵母(如ong、iong)等发音时,口型闭合度、唇形收拢程度常常出现偏差。例如一种数字人语音唇形同步方法(公开号cn119400207b)和数字人驱动方法、模型训练方法、装置及电子设备(公开号cn120219578a),虽然尝试解决中文唇形同步,但均未同时兼顾情绪和长视频稳定性。
4、2、长视频生成出现帧间抖动与面部崩坏:时长超过2分钟的长视频在生成时,帧间误差累积导致下巴抽搐、面部扭曲,存在分钟级长视频的时序一致性问题。
5、3、音画情绪割裂:现有对口型技术仅停留在让“嘴动”,缺乏对面部微表情的调动。
技术实现思路
1、为了解决以上问题,本发明提供一种数字人长视频ai配音口型与情绪联动生成方法,解决中文发音口型与视位坐标的精准映射问题、长音频驱动下数字人视频的帧间抖动问题、以及音频情感特征与面部微表情的细粒度联动问题,最终实现文创数字人视频的“一键生成、免修片、高拟真”。
2、本发明提供一种数字人长视频ai配音口型与情绪联动生成方法,包括以下步骤:
3、步骤s1:接收用户输入的精讲长音频,获取目标数字人的基准图像或视频模板;提取精讲长音频的音素与情感特征向量;
4、步骤s2:将精讲长音频以逗号、句号为标志进行智能分片,拆分为若干短句片段;对每个短句片段,根据视位字典查询各音素对应的面部关键点位移向量,计算口型关键点位置,并生成对应短句片段的口型视频;所述视位字典包含汉语拼音23个声母和24个韵母的音素对应的三维面部关键点位移向量;
5、步骤s3:基于情感特征向量,通过动作单元au映射与lstm时序建模生成微表情;
6、步骤s4:通过layer blending策略将短句片段的口型视频与微表情进行图层叠加融合,生成口型视频融合特征;
7、步骤s5:结合口型视频融合特征,根据帧间光流运动估计与三次样条插值,对口型视频进行平滑处理;
8、步骤s6:输出最终视频;
9、将所有短句片段按时间序列拼接,输出完整的数字人视频文件。
10、进一步地,所述步骤s1中提取精讲长音频的音素包括:
11、利用基于ctc的强制对齐算法,将精讲长音频波形映射到音素级别时间轴,输出“声母-韵母”音素流,ctc损失函数定义为:
12、;
13、其中,为帧数t从1到t的所有条件概率值进行连乘运算,t为精讲长音频特征序列x的总帧数,为精讲长音频特征序列,为音素标签序列,为对齐路径,为多对一映射函数,为第帧输出符号的条件概率,为第t帧输出的音素条件概率。
14、进一步地,所述步骤s1中提取情感特征向量包括,提取精讲长音频包含12维mfcc、基频f0、短时能量、过零率的多维情感特征,组合为情感特征向量,计算方式如下:
15、;
16、其中为第n维mfcc 系数,为第t帧的基频,为短时能量,为过零率,r为实数域。
17、进一步地,所述步骤s2还包括:通过采集中文母语者的面部动作捕捉数据构建视位字典,涵盖汉语拼音全部23个声母和24个韵母的音素;每个音素对应一组三维面部关键点的位移向量:
18、;
19、其中为第个面部关键点的三维位移向量,为标准面部关键点数量;
20、第t帧的口型关键点位置,计算公式如下:
21、;
22、其中为基准面部关键点坐标,为第t帧对应的音素数量,为第i个音素在t帧的激活权重。
23、进一步地,所述步骤s3还包括:将情感特征通过非线性映射函数转换为ekman面部动作编码系统中的动作单元au强度参数,包括眉头内侧上扬au1、眉头外侧上扬au2、脸颊上扬au6、嘴角上扬au12;
24、采用lstm网络对情感特征进行建模,输出隐藏状态;对隐藏状态进行线性变换生成微表情参数,计算公式如下:
25、;
26、其中为第t帧的微表情参数向量,为微表情线性变换的权重矩阵,偏置向量。
27、进一步地,所述步骤s4还包括:将口型视频作为基底图层,微表情参数作为叠加图层,通过layer blending策略进行融合,生成短句片段口型视频融合特征,融合公式如下:
28、;
29、其中为第t帧的口型视频的向量特征,为第t帧微表情参数线性变换后对应的微表情特征,为融合权重。
30、进一步地,所述步骤s5还包括:通过光流计算帧间运动矢量,基于lucas-kanade方法的光流方程为:
31、;
32、其中为像素的运动矢量,、、分别为口型视频的连续帧图像在x、y、t方向的偏导数;
33、结合人脸各关键点随时间变化的空间坐标序列构成的时序一致性约束,利用三次样条插值生成中间过渡帧:
34、;
35、其中,a为三次样条插值的常数项系数,对应过渡起始帧t=0时的面部关键点位置;b为一次项系数,控制关键点运动的线性速;c为二次项系数,控制运动过程中的加速度变化;d为三次项系数,控制运动曲线的高阶曲率变化;
36、边界条件为:
37、s(0)=,表示为片段a末尾帧的关键点位置;
38、s(t)=,表示为片段b开头帧的关键点位置;
39、s'(0)=,表示为片段a末尾帧的运动速度;
40、s'(t)=,表示为片段b开头帧的运动速度;
41、以确保拼接处位置和速度均连续;
42、时序平滑约束项:
43、;
44、其中、、分别为第 t、t+1、t-1帧的人脸关键点坐标,该约束最小化相邻帧的加速度,确保运动轨迹平滑。
45、进一步地,还包括通过时序判别器对平滑处理后的口型视频进行全局一致性校验,时序判别器的对抗损失函数为:
46、;
47、;
48、其中为判别器损失函数,为生成器损失函数,为真实视频序列,为生成口型视频序列,log为对数函数;
49、若,则判定该短句片段存在抖动,对该短句片段进行局部重新生成或帧级修正。与现有技术相比,本发明至少具有以下有益效果:
50、1、本发明采用中文音素与口型视位坐标的一一映射机制,通过内置中文发音视位字典,直接对口型进行强制坐标约束,采用“规则+数据”双驱动的精确映射策略,区别于传统端到端模糊映射方法。
51、2、本发明采用长音频流式分片合成与无缝相位平滑插值算法。将长音频智能分片、独立生成、平滑拼接的三段式处理流程,配合基于光流的运动矢量估计与三次样条插值,配合时序判别器全局校验,彻底解决长视频画面抽搐痛点。
52、3、本发明通过设计音频情感特征与面部微表情的联动控制算法,将音频多维度情感特征映射为au强度参数,通过lstm时序建模捕捉情感动态变化,实现微表情级别的细粒度联动。
53、4、本发明设置时序一致性判别与全局优化机制,引入时序判别器进行全局时序一致性校验,结合人脸关键点时序平滑约束,从生成模型层面抑制抖动。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com