
用于视频编解码系统中具有多个变换集的低频非可分离变换的方法和装置与流程
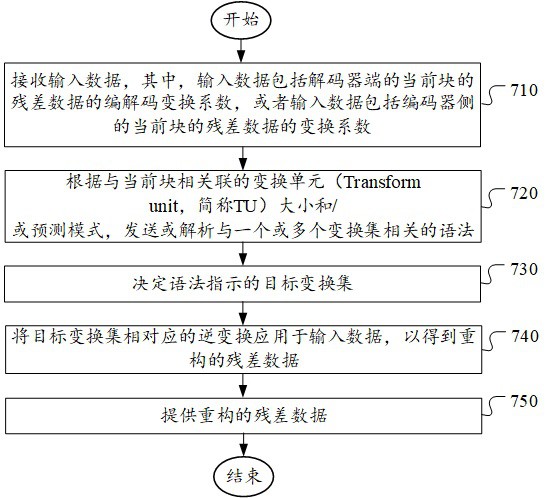
本发明涉及视频编解码系统。具体而言,本发明涉及发送多组lfnst/nspt的变换集相关语法或确定不同颜色分量的mts变换和/或lfnst和/或nspt集。
背景技术:
1、多功能视频编解码(versatile video coding,简称 vvc)是由国际电信联盟-电信标准化部门(international telecommunication union telecommunicationstandardization sector,简称itu-t)视频编解码专家组(video coding experts group,简称 vceg)和国际标准化组织/国际电工委员会(international organization forstandardization/international electrotechnical commission,简称iso/iec)动态图片专家组(moving picture experts group,简称 mpeg)的联合视频专家组(joint videoexperts team,简称 jvet)开发的最新国际视频编解码标准。该标准已作为 iso 标准于2021 年 2 月发布:iso/iec 23090-3:2021,信息技术 - 沉浸式媒体的编解码表示 - 第3部分:多功能视频编解码。vvc 是在其前身高效视频编解码(high efficiency videocoding,简称hevc)的基础上开发的,通过添加更多的编解码工具来提高编解码效率,以及处理包含三维(three dimensional,简称3d)视频信号在内的各种类型的视频源。
2、图1a示出包含环路处理的示例性适应性帧间/帧内视频编码系统。对于帧内预测,预测数据基于当前图片中先前编解码的图片视频数据导出。对于帧间预测112,运动估计(motion estimation,me)在编码器端进行,以及基于me的结果进行运动补偿(motioncompensation,mc),以提供从其他图片和运动数据导出的预测数据。开关114选择帧内预测110或帧间帧间预测112,并将选择的预测数据提供给加法器116以形成预测误差,也称为残差。然后对预测误差进行变换(transform,简称t)118处理,随后是量化(quantization,简称q)120。变换和量化的残差随后由熵编码器122编码,以包含在对应于压缩视频数据的视频比特流中。与变换系数相关的比特流随后与次要信息(与帧内预测和帧间预测相关的运动和编解码模式等)以及与应用于底层影像区域的环路滤波器相关的参数等其他信息一起打包。如图1a所示,与帧内预测110、帧间预测112和环路滤波器130相关的次要信息,被提供给熵编码器122。当帧间预测模式被使用时,一个或多个参考图片也必须在编码器端重构。因此,变换和量化的残差由逆量化(inverse quantization,简称iq)124和逆变换(inversetransformation,简称it)126处理以恢复残差。然后残差被添加回预测数据136,在重构(reconstruction,简称rec)128处重构视频数据。重构的视频数据可以存储在参考图片缓冲器134中,并用于其他帧的预测。
3、如图1a所示,传入的视频数据在编码系统中经历一系列处理。来自 rec 128 的重构视频数据可能会因一系列处理而受到各种损害。因此,在将重构的视频数据存储在参考图片缓冲器134中之前,通常会对重构的视频数据应用环路滤波器130,以提高视频质量。例如,可以使用去块效应滤波器(deblocking filter,df)、样本适应性偏移(sampleadaptive offset,sao)和适应性环路滤波器(adaptive loop filter,alf)。可能需要将环路滤波器信息纳入比特流,以便解码器能够正确恢复所需信息。因此,环路滤波器信息也提供给熵编码器122,以纳入比特流。在图1a中,环路滤波器130应用于重构的视频,然后将重构的样本存储在参考图片缓冲器134中。图1a中的系统旨在示出典型视频编码器的示例性结构。它可以对应于高效率视频编解码(high efficiency video coding,简称hevc)系统、vp8、vp9、h.264或vvc。
4、如图1b所示,除了变换118和量化120之外,解码器可以使用与编码器相同或部分相同的功能块,因为解码器只需要逆量化124和逆变换126。解码器使用熵解码器140代替熵编码器122,将视频比特流解码为量化变换系数和所需的编解码信息(例如 ilpf 信息、帧内预测信息和帧间预测信息)。解码器端的帧内预测150不需要进行模式搜索。相反,解码器只需要根据从熵解码器140接收的帧内预测信息生成帧内预测。此外,对于帧间预测,解码器只需要根据从熵解码器140接收的帧间预测信息进行运动补偿(mc 152),而不需要运动估计。
5、i.1 低频不可分离变换 (low-frequency non-separable transform,简称lfnst)
6、在vvc中,lfnst应用于正向主变换和量化之间(在编码器端)以及逆量化和逆主变换之间(在解码器端),如图2所示。如图2所示,在正向主变换210之后,正向低频不可分离变换lfnst 220应用于正向主变换输出的左上区域222,例如,4x4正向lfnst的系数为16个,和/或8x8正向lfnst的系数为64个。在lfnst中,根据块大小应用4x4不可分离变换或8x8不可分离变换。例如,4x4 lfnst应用于小块(即,最小(宽度,高度)<8),8x8 lfnst应用于较大块(即,最小(宽度,高度)>4)。lfnst之后,变换系数由量化230量化。为了重构输入信号,量化后的变换系数使用逆量化240进行逆量化,以获得逆量化后的变换系数。逆lfnst 250应用于左上区域252(4x4逆lfnst为8个系数,8x8逆lfnst为16个系数)。逆lfnst之后,逆主变换260被用来恢复输入信号。
7、以下以输入为例,描述lfnst中使用的不可分离变换的应用。要应用4x4 lfnst,4x4输入块x首先表示为向量,
8、(1)
9、
10、不可分离变换的计算公式为,其中表示变换系数向量,t是16x16变换矩阵。16x1系数向量随后按照该块的扫描顺序(水平、垂直或对角线)重新组织为4x4块。索引较小的系数将放置在4x4系数块中扫描索引较小的位置。
11、i.1.1 简化的不可分离变换
12、lfnst基于直接矩阵乘法方法来应用不可分离变换,因此它可在一次传递中实现而无需多次迭代。然而,不可分离变换矩阵维度可以被减少以最小化计算复杂度和用于存储变换系数的内存空间。因此,简化的不可分离变换(或rst)方法用于lfnst中。简化的不可分离变换的主要思想是将n(对于8x8 nsst,n通常等于64)维向量映射到不同空间中的r维向量,其中n/r(r 13、 14、其中变换的r行是n维空间的r个基准。 15、rt的逆变换矩阵是其正变换的转置。对于8x8 lfnst,简化因子4被应用,以及64x64直接矩阵(常规8x8不可分离变换矩阵大小)被简化为16x48直接矩阵。因此,在解码器端,48x16逆rst矩阵被用来生成8x8左上区域中的核心(主要)变换系数。当具有相同变换集配置的16x48矩阵被用来代替16x64矩阵时,每个矩阵从左上8x8块(不包括右下4x4块)中的三个4x4块获取48个输入数据。借助简化的维度,用于存储所有lfnst矩阵的内存使用量从10kb减少到 8kb,同时性能下降合理。为了降低复杂度,lfnst被限制为仅当第一系数子组之外的所有系数都非显著时才适用。因此,当lfnst被应用时,所有仅主变换系数都必须为零。这允许在最后显著位置上调节lfnst索引发送,从而避免当前lfnst设计中的额外系数扫描,这仅在特定位置检查显著系数时才需要。 16、lfnst的最坏情况处理(就每像素乘法而言)将4x4和8x8块的不可分离变换分别限制为8x16和8x48变换。在这些情况下,当lfnst被应用时,最后有效扫描位置必须小于8,对于其他尺寸则最后有效扫描位置小于16。对于形状为4xn和nx4且n>8的块,所提出的限制意味着lfnst现在仅应用一次,以及且仅应用于左上角的4x4区域。由于当lfnst被应用时所有仅主系数均为零,因此在这种情况下主变换所需的操作数会减少。从编码器的角度来看,当lfnst变换被测试时,系数的量化会被显著简化。必须对前16个系数(按扫描顺序)进行最大率失真优化量化,其余系数强制为零。 17、i.1.2 lfnst变换选择 18、lfnst中使用4个变换集,每个变换集总共使用2个不可分离变换矩阵(内核)。从帧内预测模式到变换集的映像是预定的,如表1所示。如果当前块使用三种cclm模式(intra_lt_cclm、intra_t_cclm或intra_l_cclm)之一(即,81<= predmodeintra<= 83),则变换集0被选择用于当前色度块。对于每个变换集,所选的不可分离次变换候选由显式发送的lfnst索引进一步指定。在变换系数之后,每个帧内cu在比特流中发送该索引一次。 19、表1. 变换选择表 20、 21、 22、i.1.3 lfnst索引发送及与其他工具的交互 23、由于lfnst被限制为仅当第一系数子组之外的所有系数都非显著时才适用,因此lfnst索引编解码取决于最后一个显著系数的位置。此外,lfnst索引经由上下文编解码,但不依赖于帧内预测模式,以及只有第一码元(bin)经由上下文编解码。此外,lfnst适用于帧内和帧间片段中的帧内cu,以及亮度和色度。如果双树被启用,则亮度和色度的lfnst索引被分别发送。对于帧间片段(双树被禁用),单个lfnst索引被发送,以及被用于亮度和色度。 24、考虑到由于现有最大变换尺寸限制(64x64),大于64x64的大cu被隐式拆分(tu平铺tiling),lfnst索引搜索可能会将一定数量的解码流水线阶段的数据缓冲增加四倍。因此,lfnst允许的最大尺寸限制为64x64。请注意,lfnst仅在dct2中启用。lfnst索引发送位于多变换选择(multiple transform selection,简称mts)索引发送之前。 25、使用缩放矩阵进行感知量化(perceptual quantization)的效果并不明显,指定用于主矩阵的缩放矩阵可以对lfnst系数有用。因此,不允许将缩放矩阵用于lfnst系数。对于单树分区模式,色度lfnst不被应用。 26、i.1.4 次变换:大内核的lfnst扩展 27、vvc中的lfnst设计扩展如下: 28、lfnst集(s)和候选集(c)的数量扩展为s=35和c=3,给定帧内模式(predmodeintra)的lfnst集(lfnsttrsetidx)根据以下公式得出: 29、对于predmodeintra<2,lfnsttrsetidx等于2 30、对于[0,34]中的predmodeintra,lfnsttrsetidx = predmodeintra 31、对于[35,66]中的predmodeintra,lfnsttrsetidx=68 – predmodeintra 32、三个不同的内核lfnst4、lfnst8和lfnst16被定义以指示lfnst内核集,它们分别应用于4xn/nx4(n≥4)、8xn/nx8(n≥8)和mxn(m,其中,n≥16) 33、内核维度由以下公式指定: 34、(lfsnt4, lfnst8*, lfnst16*)=(16x16, 32x64, 32x96)。 35、前向lfnst应用于左上角的低频区域,该区域称为感兴趣区域(region-of-interest,简称roi)。当lfnst被应用时,存在于roi以外的区域中的主变换系数将被清零,这与vvc标准没有变化。 36、图3a中示出lfnst16的roi。它由六个4x4子块组成,这些子块按扫描顺序连续。由于输入样本数为96,因此前向lfnst16的变换矩阵可以是rx96。在这种情况下,r被选择为32,因此从前向lfnst16生成32个系数(两个4x4子块),这些系数按照系数扫描顺序放置。 37、图3b显示lfnst8的roi。前向lfnst8矩阵可以是rx64,以及r被选择为32。生成的系数的定位方式与lfnst16相同。 38、表2示出了从帧内预测模式到这些集合的映像。 39、表2. 帧内预测模式到lfnst集索引的映像 40、 41、i.2 用于帧内编解码的不可分离主变换(non-separable primary transform,简称nspt) 42、对于块形状4x4、4x8、8x4和8x8、4x16、16x4、8x16和16x8,可分离的dct-ii加lfnst变换组合被nspt取代。 43、图4总结了受影响的块大小。 44、所有nspt均由35个集合和3个候选组成(与当前lfnst类似)。nspt的核具有以下形状: 45、nspt4x4: 16x16 46、nspt4x8/nspt8x4: 32x20 47、nspt8x8: 64x32 48、nspt4x16/nspt16x4: 64x24 49、nspt8x16/nspt16x8: 128x40 50、nspt4x32/nspt32x4: 128x20 51、nspt8x32/nspt32x8: 256x24。 52、因此,分别使用nspt4x8/nspt8x4、nspt8x8、nspt4x16/nspt16x4和nspt8x16/nspt16x8将12、32、40和88个系数清零。对于nspt4x32/nspt32x4和nspt8x32/nspt32x8,每个变换块中剩余的108个和232个位置分别清零。 53、i.3 lfnst/nspt用于帧间编解码 54、对于帧间编解码块,首先根据帧间预测块导出帧内预测模式,以及对预测应用类似dimd的处理。然后使用导出的帧内预测模式选择lfnst/nspt变换集,以及使用所选的lfnst/nspt内核对变换进行处理,就像在帧内编解码处理中一样。 55、帧间lfnst/nspt索引的发送与帧内lfnst/nspt索引的发送不同。帧内lfnst/nspt索引二进制化对每个符号采用两个上下文编解码的位(bin),而帧间lfnst/nspt索引编解码采用具有不同上下文模型的截断一元码。在sbt的情况下禁止lfnst/nspt索引发送,其索引值推断为0。 56、诸如帧间mts之类的编码快速算法被用来减少编码时间。 57、i.4 基于模板的帧内模式推导(template-based intra mode derivation,简称timd)融合 58、对于mpm中的每个帧内预测模式以及广角模式(如果右上和/或左下参考样本可用),模板的预测样本和重构样本之间的satd被计算。具有最小satd的前两个帧内预测模式和一个具有最低satd成本的非角度帧内预测模式(即dc或planar)被选择作为timd模式。在应用pdpc处理后,这三个timd模式与权重被融合,以及这种加权帧内预测被用来对当前cu进行编解码。位置相关帧内预测组合(position dependent intra predictioncombination,简称pdpc)包含在timd模式的推导中。 59、以下条件被检查来确定融合中是否使用非角度帧内预测模式: 60、非角度帧内预测模式与所选的两种帧内预测模式不同。 61、costmode3<1.5*costmode1,其中costmode3是非角度帧内预测模式的satd成本,costmode1是第一帧内预测模式的satd成本。 62、如果两个条件都为真,则三种帧内预测模式被用来生成预测。每种帧内预测模式的权重都根据satd成本计算得出: 63、 64、否则,不使用非角度帧内预测模式进行预测。将两个选定模式的成本与阈值进行比较,在测试中应用成本因子2,如下所示: 65、costmode2<2*costmode1. 66、如果该条件为真,则融合被应用,否则仅使用模式1。 67、模式的权重根据其satd成本计算如下: 68、weight1 = costmode2 /(costmode1+ costmode2) 69、weight2 = 1 - weight1. 70、使用与cclm所用的相同的基于查找表(lookup table,简称lut)的整数化方案来进行除法运算。 71、此外,dimd融合处理中使用的位置相关基于样本的融合用于timd融合,但应用于所选预测因子幅度的位置相关标准被基于satd成本的标准取代。位置相关标准根据在上方和左侧模板区域中计算的所选timd预测因子的归一化satd的比率来确定。 72、i.5 解码器端帧内模式推导(decoder-side intra mode derivation,简称dimd) 73、当dimd被应用时,从重构的相邻样本中导出最多五种帧内模式,以及将这五个预测子与非定向预测子(基于平面或块向量的预测子)组合,其中权重从梯度直方图导出,如jvet-o0449中所述。根据模板成本来确定非定向模式。具体而言,所有相邻和非相邻合并候选(以intratmp或ibc编解码)的块向量与重构模板上的平面预测进行比较。模板成本(template cost,简称satd)用于从中选择最佳预测子。 74、权重推导中的除法运算利用与cclm相同的基于查找表(lookup table,简称lut)的整数化方案来执行。例如,方向计算中的除法运算: 75、, 76、通过以下基于lut的方案计算: 77、x = floor( log2( gx ) ) 78、normdiff = ( ( gx<<4 )>>x )&15 79、x +=( 3 + ( normdiff != 0 ) ? 1 : 0 ) 80、orient = (gy* ( divsigtable[ normdiff ] | 8 ) + ( 1<<( x-1 ) ))>>x. 81、其中 82、divsigtable[16] = { 0, 7, 6, 5 ,5, 4, 4, 3, 3, 2, 2, 1, 1, 1, 1, 0 }。 83、对于大小为w×h的块,如果上方或左侧直方图幅度比另一个大两倍,则修改五个导出模式中的每一个的权重。在这种情况下,权重与位置有关,以及按如下方式计算。 84、如果上方的直方图是左侧的两倍,则: 85、, 86、如果左侧的直方图是上方的两倍,则 87、, 88、其中是jvet-o0449中选择的dimd的未修改的统一权重,是预定的以及被设置为10。 89、导出的帧内模式包含在帧内最可能模式(most probable mode,简称mpm) 的主列表中,因此在构建mpm列表之前执行dimd处理。dimd块的主要导出帧内模式与块一起存储,以及用于相邻块的mpm列表构建。 90、最后,请注意,与jvet-o0449方法相比,用于计算梯度直方图的相邻重构样本的区域有所修改,具体取决于重构样本的可用性。如果可用,则当前wxh亮度cb的解码参考样本的区域向右上方扩展,最多可增加w个额外列。如果可用,则向左下方扩展,最多可增加h个额外行。 91、i.6 基于矩阵的帧内预测取代传统的帧内模式 92、对块形状和帧内模式定义的权重矩阵被引入。这些权重与相邻参考模板相乘,以得出预测样本,从而取代传统的帧内预测。如图5所示,权重被应用于l形因果相邻模板的参考样本。 93、因果邻域中的参考样本表示为r,f(x,y)是权重矩阵。然后,可以推导出预测p(x,y)如下: 94、, 95、其中,k表示模板中参考样本的索引。 96、在测试中,模板大小被设置为4(即,t1 = t2 = 4),模板维度保持为2*w和2*h。该模式仅对w<=16和h<=16的块大小以及模式0、1和(2+4*k)(其中 k = {0、1、2、...、16})(即,每4个模式)启用。启用后,此模式将取代传统的帧内预测模式,因此无需额外信令传输。 97、i.7 jvet-ah0056中提出的lfnst/nspt多变换集选择 (multiple transform setselection,简称mtss) 98、第一候选变换集保持与当前ecm相同。 99、为了导出第二候选: 100、对于timd,如果应用融合,则首先考虑第二timd ipm; 101、对于sgpm,首先考虑sgpm使用的2个ipm; 102、对于mip和eip,首先考虑planar; 103、第一和第二候选应为不同的变换集。如果第二候选尚未通过上述处理确定,则其由相邻重构像素的hog得出。 104、为了减少编码时间,mtss使用cu大小限制。cu大小以cu内的像素数量来衡量。mtss可应用于大小等于或大于阈值的cu。 105、i.8 jvet-ah0307中提出的用于帧内mts的多变换集选择 106、对于dimd、timd、intratmp和eip模式,在显式帧内mts中使用可选变换集。对于这些模式,初始变换集保持不变,以及可选变换集对应于查找表中的平面变换集。 107、可选变换集中候选的数量取决于初始变换集中候选的数量。 108、如果在初始变换集中使用了1个候选,则在可选变换集中使用1个候选。 109、如果在初始变换集中使用了4个候选,则在可选变换集中使用2个候选。 110、如果在初始变换集中使用了6个候选,则在可选变换集中使用3个候选。 111、可选变换集的使用通过cu级标志向解码器发送。如果编码器选择了可选变换集,则该标志被设置为1。 112、i.9 增强型mts帧内编解码 113、在当前的vvc设计中,对于mts,仅使用dst7和dct8变换内核进行帧内和帧间编解码。 114、包括dct5、dst4、dst1和恒等变换(identity transform,简称idt)在内的额外主变换被采用。此外,mts集取决于tu大小和帧内模式信息。对于通过intratmp预测的块,dimd处理被用在预测块以导出用于变换选择的帧内模式。具体而言,对每个预测样本计算水平梯度和垂直梯度以构建hog。然后,具有最大直方图幅度值的帧内预测模式被用来选择mts变换集。 115、总体而言,考虑16种不同的tu大小。对于每个tu大小,根据帧内模式信息考虑5个不同的类别。对于每个类别,考虑1、4或6个不同的变换对。根据变换系数的绝对值之和适应性地选择帧内mts候选数(在1、4和6个mts候选数之间)。将该总和与两个固定阈值进行比较以确定允许的mts候选数的总和: 116、1 候选: 总和<= th0 117、4 候选: th0<总和<= th1 118、6 候选: 总和>th1 119、注意,虽然总共考虑80个不同的类别,但其中一些不同的类别通常共享完全相同的变换集。因此,结果lut中有58个(少于80个)唯一条目。 120、对于角度模式,考虑tu形状和帧内预测的联合对称性。因此,tu形状为a×b的模式i(i>34)将被映射到与tu形状为b×a的模式j=(68-i)相对应的同一类。但是,对于每个变换对,水平和垂直变换内核的顺序被交换。例如,具有模式18(即,水平预测)的16×4块和具有模式50(即,垂直预测)的4×16块被映射到同一类。但是,垂直和水平变换内核被交换。对于广角模式,最接近的常规角度模式用于变换集确定。例如,模式2用于-2和-14之间的所有模式。类似地,模式66用于模式67至模式80。 121、i.10 帧间mts优化 122、对于由帧间编解码cu的mts,每个cu使用四个候选:{(dst7,dst7),(dst7,dct8),(dct8,dst7),(dct8,dct8)}。对于较大分辨率序列(例如宽度>1080),帧间-mts使用的最大cu大小设置为32(即,帧间-mts 用于宽度<=32且高度<=32的cu)。对于其余序列(即,较小分辨率),帧间-mts使用的最大cu大小被设置为16。对于4点(point,简称pt)、8pt和16pt变换,当前的amt变换核心(即,dst-7和dct-8)被可分离的klt取代,如jvet-j0021中提出的。 123、i.11 符号预测 124、jvet-d0031和jvet-j0021中的系数符号预测方法的基本思想是计算适用变换系数的负符号和正符号组合的重构残差,以及选择最小化成本函数的假设。 125、为了导出最佳符号,成本函式被定义为图6所示的交叉块边界的不连续性测量。对所有假设进行测量,以及具有最小成本的假设被选择作为系数符号的预测子。 126、成本函式被定义为上方行和左侧列的残差域中的绝对二阶导数之和,如下所示: 127、, 128、其中r是重构的邻居,p是当前块的预测,r是残差假设。项(-r-1+2r0-p1)只对每个块计算一次,以及只有残差假设被减去。 129、左上角4x4区域中具有最大k个qidx值的变换系数被选择。qidx值是在补偿dq中的多个量化器的影响后的变换系数级别。较大的qidx值将产生较大的逆量化变换系数级别。qidx得出如下 130、qidx =(abs(level)<<1)-(state&1); 131、其中level是从比特流解析出来的变换系数级别,state是dq中编码器和解码器维护的变量。 132、符号预测区域最大扩展至32x32。预测左上mxn块的符号。m和n的值计算如下: 133、, 134、, 135、其中,w和h是变换块的宽度和高度。符号预测的最大区域并不总是设置为32x32。编码器根据配置、序列类别和qp设置最大区域(maxw、maxh),以及在sps中发送该区域。 136、预测符号的最大数量保持不变。符号预测也适用于lfnst块。对于lfnst块,左上4x4区域中的最大4个系数被允许进行符号预测。 137、在本发明中,用于lfnst/nspt的变换相关语法的条件确定方案被公开。 技术实现思路 1、一种视频编解码方法和装置。根据一种方法,输入数据被接收,其中,输入数据包括解码器端的当前块的残差数据的编解码变换系数,或者输入数据包括编码器侧的当前块的残差数据的变换系数。根据与当前块相关联的变换单元(transform unit,简称tu)大小和/或预测模式,与一个或多个变换集相关的语法被发送或解析。语法指示的目标变换集被确定。与目标变换集相对应的逆变换被应用于输入数据以导出重构的残差数据。重构的残差数据被提供。 2、在一个实施例中,所述一个或多个变换集包括一个或多个低频不可分离变换(low-frequency non-separable transform,简称lfnst)变换集和/或一个或多个不可分离主变换(non-separable primary transform,简称nspt)变换集。 3、在一个实施例中,用于块内的所述一个或多个变换集的第一数量与用于块间的所述一个或多个变换集的第二数量不同。 4、在一个实施例中,开/关控制标志被发送或解析,以指示与当前块相关联的根据tu大小和/或预测模式的一个或多个变换集相关的发送或解析语法是否应用于当前块。在一个实施例中,开/关控制标志在编解码单元(coding unit,简称cu)级别、片段级别、图片级别、序列级别或其组合被发送或解析。 5、根据另一种方法,输入数据被接收,其中,输入数据包括解码器端的当前块的残差数据的编解码变换系数,或者输入数据包括编码器侧的当前块的残差数据的变换系数,其中,当前块包括第一颜色分量和第二颜色分量。目标变换集从一个或多个多变换选择(multiple transform selection,简称mts)变换集、一个或多个低频不可分离变换(low-frequency non-separable transform,简称lfnst)变换集、一个或多个不可分离主变换(non-separable primary transform,简称nspt)变换集或其组合中确定,其中所述确定目标变换集是基于第一颜色分量和第二颜色分量的一个或多个不同预测模式。语法指示的目标变换集被确定。与目标变换集相对应的逆变换被应用于输入数据以得到重构的残差数据。重构的残差数据被提供。 6、在一个实施例中,所述确定目标变换集是基于当前块对第一颜色分量的帧内模式、虚拟帧内预测模式或dimd模式。 7、在一个实施例中,所述确定目标变换集是基于当前块对第二颜色分量的timd模式或基于矩阵的帧内预测(matrix-based intra prediction,简称mip)模式。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com