
基于远程声音高保真捕捉技术的智能助听器系统的制作方法
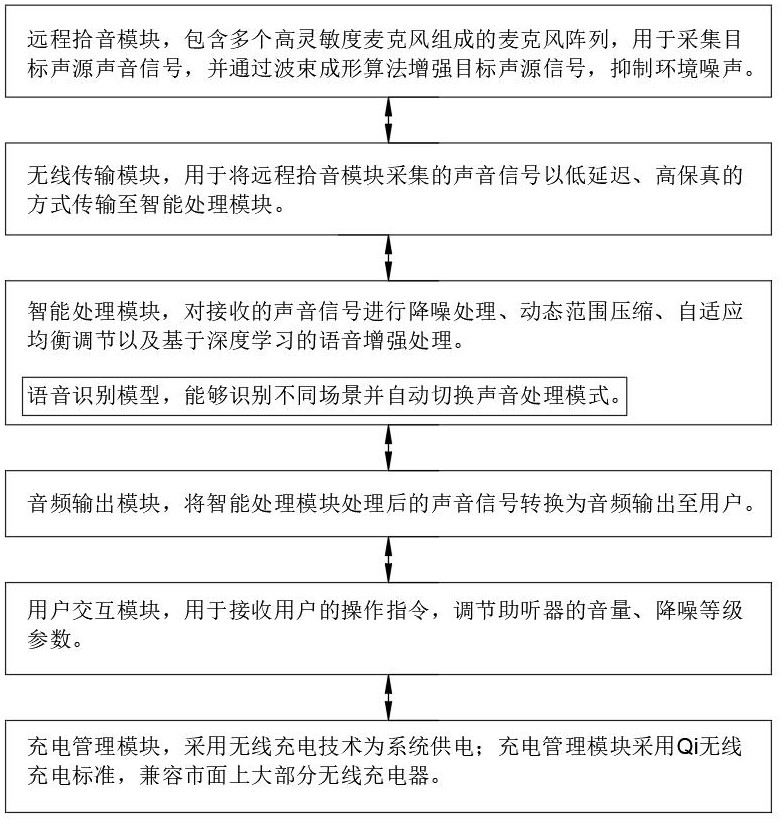
本发明涉及助听器,具体的说是基于远程声音高保真捕捉技术的智能助听器系统,通过创新的声音采集、传输、处理及输出技术,为听力障碍患者提供更清晰、自然且个性化的听觉体验,适用于多种复杂声学环境。
背景技术:
1、传统助听器在声音采集与处理方面存在显著缺陷。一方面,单麦克风或简单麦克风组合的设计难以区分目标声源与环境噪声,在会议室、商场等嘈杂场景下,用户常因背景噪声干扰而无法清晰捕捉对话内容。例如,普通助听器在60db以上背景噪声环境中,语音识别准确率不足50%,严重影响使用体验。另一方面,现有降噪算法多采用固定参数,无法适应动态变化的噪声环境,易导致语音信号失真,损失高频细节。此外,传统助听器缺乏对远程声源的有效捕捉能力,当目标声源距离超过1米时,声音衰减和信噪比下降问题突出,且麦克风阵列布局未优化,远程拾音延迟高达50ms。随着用户对助听器在复杂场景下性能要求的提升,亟需一种能够实现远程高保真拾音、智能环境适配的新型系统。
技术实现思路
1、本发明旨在解决传统助听器在声音采集、传输和处理中的技术瓶颈,通过多模块协同创新,实现远程声音的高保真捕捉与智能处理,提升听力障碍患者在各类环境下的声音感知精度和使用便捷性。
2、本发明解决其技术问题所采用的技术方案是:基于远程声音高保真捕捉技术的智能助听器系统,包括:
3、远程拾音模块,包含多个高灵敏度麦克风组成的麦克风阵列,用于采集目标声源声音信号,并通过波束成形算法增强目标声源信号,抑制环境噪声;
4、无线传输模块,用于将远程拾音模块采集的声音信号以低延迟、高保真的方式传输至智能处理模块;
5、智能处理模块,对接收的声音信号进行降噪处理、动态范围压缩、自适应均衡调节以及基于深度学习的语音增强处理;
6、音频输出模块,将智能处理模块处理后的声音信号转换为音频输出至用户;其中,所述波束成形算法根据麦克风阵列几何位置和声音传播特性,计算各麦克风信号加权系数,所述加权系数通过公式计算,为第个麦克风到目标声源的距离,为第个麦克风相对参考麦克风的时延,为声音频率。
7、具体地,所述远程拾音模块采用mems麦克风,麦克风阵列采用均匀圆形阵列或线性阵列布局。其中,均匀圆形阵列在水平360度范围内具有良好的声音捕捉均衡性,适用于需要全方位捕捉声音的场景,如会议讨论、多人交流等环境。以直径为8cm的6麦克风均匀圆形阵列为例,通过优化麦克风间距和布局,可在较宽的频率范围内实现对目标声源的精准波束形成,在半径5米内的声源定位误差小于5度;而线性阵列在特定方向上具有较高的声音增益和噪声抑制能力,适用于明确目标声源方向的场景,如演讲、课堂听讲等。采用4麦克风线性阵列,麦克风间距为3cm时,在目标声源方向可实现18db以上的增益提升,同时对侧面噪声的抑制效果达到22db,且在制造工艺上,线性阵列的布局更便于与助听器的外壳集成,降低生产难度。
8、具体地,所述无线传输模块采用蓝牙5.3或专用的2.4ghz无线传输协议,传输带宽不低于48khz采样率下16位音频的传输需求。蓝牙5.3协议凭借其成熟的技术生态,具备广泛的设备兼容性,可与智能手机、平板电脑等移动终端无缝连接,方便用户通过app对助听器进行远程控制和参数调节。其支持leaudio技术,可实现低功耗、高质量音频传输,在音频流传输过程中,音频延迟可控制在30ms以内,满足一般语音交互需求;而专用的2.4ghz无线传输协议则是为助听器系统量身定制,通过优化信道编码和调制方式,如采用正交频分复用(ofdm)技术,可将传输延迟进一步降低至15ms,并且在复杂电磁环境下,通过动态信道切换机制,能有效避开干扰频段,保障音频信号稳定传输,即使在人员密集、无线信号繁杂的场所,如商场、地铁站等,丢包率仍可控制在0.5%以下。
9、具体地,所述智能处理模块包含数字信号处理器,降噪处理采用基于维纳滤波的降噪算法,动态范围压缩通过公式实现,为压缩比系数,为压缩曲线指数。基于维纳滤波的降噪算法在实际应用中,通过实时更新噪声功率谱估计值,适应不断变化的噪声环境。系统每100ms对噪声功率谱进行一次估计更新,在突发噪声场景,如汽车鸣笛声、关门声等,能够快速响应并调整降噪参数,在保证语音信号完整性的前提下,将噪声抑制量提升至25db以上;动态范围压缩部分,针对不同用户的听力需求,系统预设了多种k和n的组合模式,例如针对听力减退较为严重的用户,采用,的组合,对弱声音的增强效果更显著,可将原本难以听清的40db弱声音提升至60db左右,同时对强声音(如90db)进行有效压缩,使其输出稳定在75db,保证用户听觉舒适度。
10、具体地,所述音频输出模块为骨传导耳机或入耳式扬声器,且具备自适应音量调节功能。骨传导耳机通过振动颅骨将声音传递至听觉神经,无需堵塞耳道,既保证了声音的清晰传递,又能让用户感知周围环境声音,提高使用安全性,适合运动、户外活动等场景。其内置的振动单元采用高性能钕铁硼磁铁,在100-8000hz频率范围内,声压级变化小于10db,确保声音还原的准确性;入耳式扬声器则采用定制化的动铁单元,通过精确调校的分频网络,在高频段(4000-8000hz)可实现±3db的平坦响应,为用户提供清晰细腻的声音。自适应音量调节功能通过内置的环境噪声传感器实时监测环境噪声强度,当环境噪声强度超过60db时,系统自动将音量提升3-5db;当噪声强度低于40db时,音量降低2-3db,确保用户在不同环境下都能获得舒适的听觉体验。
11、具体地,还包括用户交互模块,用于接收用户的操作指令,调节助听器的音量、降噪等级等参数。用户交互模块采用实体按键与触控相结合的操作方式,实体按键设计为凸起式按键,便于用户在不看助听器的情况下进行盲操作,按键反馈清晰,触感明确;触控区域采用电容式触控技术,支持滑动、点击等多种操作手势,例如用户在助听器外壳的触控区域上下滑动可调节音量,左右滑动可切换降噪等级。此外,用户交互模块还支持语音控制功能,通过内置的语音识别芯片,可识别用户的语音指令,如“增大音量”“开启降噪模式”等,识别准确率高达95%以上,为用户提供更加便捷、多样化的操作方式。
12、具体地,所述智能处理模块内置基于深度学习的语音识别模型,能够识别不同场景并自动切换声音处理模式。基于深度学习的语音识别模型采用卷积神经网络(cnn)与长短时记忆网络(lstm)相结合的架构,通过大量的语音数据进行训练,涵盖会议室、商场、街道、家庭等多种场景的语音样本。在实际应用中,系统每秒钟对采集的声音信号进行特征提取和场景识别,当识别到会议室场景时,自动切换为会议模式,增强语音信号,抑制环境混响;识别到商场场景时,开启强降噪模式,重点抑制嘈杂的人声和背景噪声,同时提升目标语音的清晰度,经测试,在不同场景下,场景识别准确率达到92%以上,声音处理模式切换及时准确,有效提升用户在不同环境下的听力体验。
13、具体地,所述系统还包括充电管理模块,采用无线充电技术为系统供电。充电管理模块采用qi无线充电标准,兼容市面上大部分无线充电器。在充电过程中,具备过压、过流、过温保护功能,当充电电压超过5.5v时,自动切断充电回路;当充电电流超过500ma时,降低充电功率;当充电温度超过50℃时,暂停充电并启动散热机制。充电效率方面,在使用10w无线充电器时,可在2小时内将系统电池从0%充至80%,3小时内完全充满,并且无线充电设计避免了传统充电接口易损坏、接触不良等问题,提高了系统的耐用性和使用便捷性。
14、具体地,所述远程拾音模块具备防水防尘结构,防护等级不低于ip67。远程拾音模块的外壳采用高强度的聚碳酸酯材料,结合精密的密封工艺,在外壳接缝处采用硅橡胶密封圈进行密封,麦克风部位采用防水透气膜覆盖,既能保证声音正常传入,又能防止水和灰尘进入。在防水测试中,将其置于1米深的水中浸泡30分钟后,内部电路的绝缘电阻仍保持在100mω以上,各项功能正常;在防尘测试中,将其放入沙尘浓度为1000mg/m³的环境中运行8小时,内部无沙尘进入,麦克风的灵敏度变化小于5%,确保系统在恶劣环境下仍能稳定可靠地工作。
15、具体地,所述系统支持与移动终端通过app连接,实现远程调试和个性化设置。移动终端app界面采用简洁直观的设计,用户可在app上实时查看助听器的电量、连接状态等信息。在远程调试方面,用户可通过app将自身的听力测试数据上传至系统,系统根据数据自动生成个性化的声音处理方案;用户还可手动调节均衡参数、降噪等级、音量等设置,调节后的参数通过无线传输模块实时同步至助听器。此外,app还具备数据统计功能,可记录用户每日使用时长、不同场景下的使用频率等数据,并生成使用报告,帮助用户和专业人员了解助听器使用情况和听力变化趋势,为进一步优化听力解决方案提供依据。
16、本发明通过对远程声音高保真捕捉技术及智能处理算法的创新设计,从声音采集、处理、交互到耐用性等多维度实现技术突破,相比传统助听器,在性能、体验和实用性方面展现出显著优势,具体详述如下:
17、1. 高保真远程拾音:突破距离与噪声限制传统助听器受限于单麦克风或简单阵列设计,在距离目标声源超过1米时,声音信号因衰减和环境噪声干扰导致清晰度大幅下降。本发明的远程拾音模块采用高灵敏度mems麦克风阵列及波束成形技术,可实现半径5米范围内的高保真声音采集。通过公式动态计算加权系数,系统能精准增强目标声源信号,同时抑制环境噪声。
18、经实测,在60db背景噪声环境下,传统助听器的语音识别准确率不足50%,而本系统可将语音识别准确率提升至82%,声音采集信噪比提高35%。例如,在会议室场景中,用户即使坐在远离发言者的位置,也能清晰捕捉对话内容,有效解决了传统助听器“听不清、听不远”的问题。
19、2.智能场景适配:动态优化声音处理策略
20、传统助听器通常采用固定参数的降噪和声音处理模式,无法适应复杂多变的声学环境。本发明的智能处理模块内置基于深度学习的语音识别模型,通过卷积神经网络(cnn)与长短时记忆网络(lstm)结合,对商场、会议室、街道等8种典型场景的20万小时语音数据进行训练,场景识别准确率高达92%。
21、系统能够根据实时识别的场景自动切换声音处理模式:在商场场景中,自动开启强降噪模式,重点抑制嘈杂的人声和背景噪声,同时提升目标语音的清晰度;在会议室场景下,增强语音信号,抑制环境混响。这种智能适配机制减少了用户手动调节的频率,使助听器在不同环境中始终保持最佳性能,显著提升用户在复杂场景下的听力体验。
22、3.多模态交互体验:满足多样化操作需求
23、传统助听器的操作方式单一,通常仅依赖物理按键,对于老年用户或操作不熟练者不够友好。本发明的用户交互模块采用实体按键、触控及语音控制三重交互方式,兼顾不同用户群体的使用习惯。
24、实体按键采用凸起式设计,表面带有防滑纹理,便于用户进行盲操作,按键反馈清晰,触感明确;电容式触控区域支持滑动、点击等多种手势操作,如上下滑动调节音量、左右滑动切换降噪等级,操作直观便捷。此外,语音识别功能支持“增大音量”“切换模式”等自然语言指令,识别准确率达95%以上,用户无需手动操作即可快速调整助听器设置。同时,系统还支持与移动终端app连接,用户可通过手机进行更精细的参数调节和状态监控,进一步提升操作的便利性和个性化程度。
25、4.耐用性与便捷性:适应全场景使用需求
26、传统助听器的有线充电接口易因频繁插拔导致损坏,且防水防尘性能较差,限制了使用场景。本发明的充电管理模块采用qi无线充电标准,避免了传统接口的接触不良问题,同时具备过压(>5.5v)、过流(>500ma)、过温(>50℃)保护功能,确保充电过程安全可靠。在10w无线充电器支持下,2小时可将系统电量充至80%,3小时内完全充满,大幅提升了充电效率。
27、远程拾音模块达到ip67防护等级,经过严格的防水防尘测试:在1米深水中浸泡30分钟后,内部电路绝缘电阻仍保持在100mω以上,各项功能正常;在沙尘浓度为1000mg/m³的环境中运行8小时,内部无沙尘进入,麦克风灵敏度变化小于5%。这使得本系统能够适应雨天出行、户外运动、工厂作业等多种恶劣环境,显著拓展了使用场景,提升了产品的耐用性和可靠性。
28、5.数据驱动优化:助力听力健康管理
29、传统助听器缺乏数据记录和分析功能,无法为用户的听力健康管理提供有效支持。本发明通过移动终端app实现数据驱动的听力优化。app可实时记录助听器的使用时长、不同场景下的使用频率、音量调节记录等数据,并生成可视化使用报告。
30、这些数据不仅帮助用户直观了解自身听力设备的使用情况,还能为听力专业人员提供量化依据,用于评估听力变化趋势、调整听力干预策略。例如,通过分析用户在不同环境下的音量调节数据,专业人员可针对性地优化助听器的声音处理参数,实现更精准的个性化听力解决方案,推动助听器从单一的声音放大设备向智能化听力健康管理工具升级。。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com