
用于在视频编解码中控制基于模板的编解码工具的方法和装置与流程
本发明涉及视频编解码系统。具体而言,本发明涉及控制视频编解码系统中模板匹配工具的使用。
背景技术:
1、多功能视频编解码(versatile video coding,简称 vvc)是由国际电信联盟-电信标准化部门(international telecommunication union telecommunicationstandardization sector,简称itu-t)视频编解码专家组(video coding experts group,简称 vceg)和国际标准化组织/国际电工委员会(international organization forstandardization/international electrotechnical commission,简称iso/iec)动态图片专家组(moving picture experts group,简称 mpeg)的联合视频专家组(joint videoexperts team,简称 jvet)开发的最新国际视频编解码标准。该标准已作为 iso 标准于2021 年 2 月发布:iso/iec 23090-3:2021,信息技术 - 沉浸式媒体的编解码表示 - 第3部分:多功能视频编解码。vvc 是在其前身高效率视频编解码(high efficiency videocoding,简称hevc)的基础上开发的,通过添加更多的编解码工具来提高编解码效率,以及处理包含三维(three dimensional,简称3d)视频信号在内的各种类型的视频源。
2、图1a示出包含环路处理的示例性适应性帧间/帧内视频编码系统。对于帧内预测,预测数据基于当前图片中先前编解码的图片视频数据导出。对于帧间预测112,运动估计(motion estimation,me)在编码器侧进行,以及基于me的结果进行运动补偿(motioncompensation,mc),以提供从其他图片和运动数据导出的预测数据。开关114选择帧内预测110或帧间帧间预测112,并将选择的预测数据提供给加法器116以形成预测误差,也称为残差。然后对预测误差进行变换(transform,简称t)118处理,随后是量化(quantization,简称q)120。变换和量化的残差随后由熵编码器122编码,以包含在对应于压缩视频数据的视频比特流中。与变换系数相关的比特流随后与辅助信息(与帧内预测和帧间预测相关的运动和编解码模式等)以及与应用于底层影像区域的环路滤波器相关的参数等其他信息一起打包。如图1a所示,与帧内预测110、帧间预测112和环路滤波器130相关的辅助信息,被提供给熵编码器122。当帧间预测模式被使用时,一个或多个参考图片也必须在编码器侧重构。因此,变换和量化的残差由逆量化(inverse quantization,简称iq)124和逆变换(inversetransformation,简称it)126处理以恢复残差。然后残差被添加回预测数据136,在重构(reconstruction,简称rec)128处重构视频数据。重构的视频数据可以存储在参考图片缓冲器134中,并用于其他帧的预测。
3、如图1a所示,传入的视频数据在编码系统中经历一系列处理。来自 rec 128 的重构视频数据可能会因一系列处理而受到各种损害。因此,在将重构的视频数据存储在参考图片缓冲器134中之前,通常会对重构的视频数据应用环路滤波器130,以提高视频质量。例如,可以使用去块效应滤波器(deblocking filter,df)、样本适应性偏移(sampleadaptive offset,sao)和适应性环路滤波器(adaptive loop filter,alf)。可能需要将环路滤波器信息纳入比特流,以便解码器能够正确恢复所需信息。因此,环路滤波器信息也提供给熵编码器122,以纳入比特流。在图1a中,环路滤波器130应用于重构的视频,然后将重构的样本存储在参考图片缓冲器134中。图1a中的系统旨在示出典型视频编码器的示例性结构。它可以对应于高效率视频编解码(high efficiency video coding,简称hevc)系统、vp8、vp9、h.264或vvc。
4、如图1b所示,除了变换118和量化120之外,解码器可以使用与编码器相同或部分相同的功能块,因为解码器只需要逆量化124和逆变换126。解码器使用熵解码器140代替熵编码器122,将视频比特流解码为量化变换系数和所需的编解码信息(例如 ilpf 信息、帧内预测信息和帧间预测信息)。解码器侧的帧内预测150不需要进行模式搜索。相反,解码器只需要根据从熵解码器140接收的帧内预测信息生成帧内预测。此外,对于帧间预测,解码器只需要根据从熵解码器140接收的帧间预测信息进行运动补偿(mc 152),而不需要运动估计。
5、i. 相关技术
6、i.1 解码器侧帧内模式推导(decoder-side intra mode derivation,简称dimd)
7、当dimd被应用时,两个帧内模式从重构的相邻样本中导出,以及这两个预测子与平面模式预测子相结合,其中权重从梯度导出,如jvet-o0449 中所述。权重导出中的除法运算利用与cclm使用的相同的基于查找表(lookup table,简称lut)的整数化方案来执行。例如,方向计算中的除法运算。
8、
9、通过以下基于lut的方案计算:
10、x = floor( log2( gx ) ),
11、normdiff = ( ( gx<<4 )>>x )&15,
12、x +=( 3 + ( normdiff != 0 ) ? 1 : 0 ),以及
13、orient = (gy* ( divsigtable[ normdiff ] | 8 ) + ( 1<<( x-1 ) ))>>x,
14、其中divsigtable[16] = { 0, 7, 6, 5 ,5, 4, 4, 3, 3, 2, 2, 1, 1, 1, 1,0 }。
15、导出的帧内模式被包含在帧内最可能模式 (most probable modes,简称mpm)的主列表中。因此,dimd处理在构建mpm列表之前执行。dimd 块的主导出帧内模式与该块一起存储,以及用于相邻块的mpm列表构建。
16、i.2 dimd色度模式
17、dimd色度模式采用dimd推导方法,根据图2a-c中y、cb、cr分量(图2a、图2b、图2c)所示的第二相邻行、第二列的相邻重构y、cb、cr样本,当前块的色度帧内预测模式被推导。具体地,对当前色度块的每个同位重构亮度样本以及重构的cb、cr样本计算水平梯度和垂直梯度,构建hog。然后直方图幅度值最大的帧内预测模式被用来对当前色度块进行色度帧内预测。
18、当由dimd色度模式导出的帧内预测模式与由dm模式导出的帧内预测模式相同时,直方图幅度值第二大的帧内预测模式被用来作为dimd色度模式,以及cu级别标志被发送以指示是否应用所提出的dimd色度模式。
19、1.3基于模板的帧内模式推导的融合(fusion for template-based intra modederivation,简称time)
20、对于mpm中的每个帧内预测模式,计算模板的预测和重构样本之间的绝对变换差之和(sum of absolute transformed differences,简称satd)。通常,使用左上相邻的重构样本作为模板。具有最小satd的前两个帧内预测模式被选择作为timd模式。在应用位置相关预测组合(position dependent prediction combination,简称pdpc)处理后,这两个timd模式与权重融合,以及该加权帧内预测被用来对当前cu进行编码。pdpc包含在timd模式的推导中。
21、将所选的两种模式的成本与阈值进行比较。在测试中,成本因子2的应用如下:
22、costmode2<2*costmode1。
23、如果该条件为真,则应用融合,否则仅使用模式1。
24、模式的权重根据其satd成本计算如下:
25、weight1 = costmode2 / (costmode1+ costmode2)
26、weight2 = 1 - weight1。
27、与cclm所用的相同的基于查找表(lookup table,简称lut)的整数化方案被用来进行除法运算。
28、i.4 帧内预测融合
29、该帧内预测方法将预测样本导出为从不同参考线生成的多个预测值的加权组合。在此处理中,多个帧内预测子被生成,然后通过加权平均进行融合。导出融合处理中要使用的预测子的过程描述如下:
30、1)对于包括timd和dimd的单模式情况在内的角度帧内预测模式,所提出的方法通过从多个参考线获得的加权帧内预测来得出帧内预测, 表示为,其中是从默认参考线进行的帧内预测,是从默认参考线上方的线进行的预测。权重设置为和。
31、2)对于带混合的timd模式,p_line用于第一模式(w_0=1,w_1=0),以及p_(line+1)用于第二模式(w_0=0,w_1=1)。
32、3)对于带混合的dimd模式,用于加权平均值的预测子数量从3个增加到6个。
33、当角度帧内模式具有非整数斜率(需要参考样本插值)且块大小大于16时,将帧内预测融合方法应用于亮度块,该方法与mrl一起使用,不适用于isp编解码块。在子测试中研究的方法中,最接近当前块参考线的pdpc被应用于帧内预测模式。
34、i.5 色度帧内预测模式融合
35、在ecm中,两个色度帧内预测信号可以融合在一起。两个色度帧内预测信号中的一个使用dm模式、dimd色度模式和四个默认模式(非lm模式)之一进行预测。另一个色度帧内预测信号使用跨分量线性预测模式(lm模式)进行预测。两种不同的方法被支持。
36、在第一种方法中,lm模式可以是mm-cclm或mm-cccm,最终的预测子推导如下:
37、
38、其中是应用非lm模式得到的预测子,是应用lm模式得到的预测值,是当前色度块的最终预测子。两个权重w0和w1由相邻色度块的帧内预测模式决定,偏移(shift)被设置为2。具体而言,当上相邻块和左相邻块均采用lm模式编解码时,设置{w0,w1}={1, 3};当上相邻块和左相邻块均采用非lm模式编码时,设置{w0,w1}={3, 1};否则,设置{w0,w1}={2, 2}。两个模板成本通过将角度色度预测分别与mm-cclm或mm-cccm融合来计算,两个ccp中提供较小模板成本的一个ccp被用来来导出pred1。
39、在第二种方法中,lm模式可以是mmlm或cclm模式,最终的预测子推导如下:
40、
41、其中,是通过应用非lm模式获得的预测子,是位于同一位置的下采样重构亮度样本集,以及是当前色度块的最终预测子。β是固定值,对于10比特内容,β设置为512。三个权重、和从相邻的亮度和色度样本中导出,使用与cccm中相同的ldl推导方法。
42、i.6 帧内模板匹配
43、帧内模板匹配预测(intratmp)是一种特殊的帧内预测模式,它从当前帧的重构部分复制最佳预测块,其l形模板与当前模板匹配。对于预定的搜索范围,编码器在当前帧的重构部分中搜索与当前模板最相似的模板,以及使用相应的块作为预测块。然后,编码器发送此模式的使用情况,以及在解码器侧执行相同的预测操作。
44、通过将当前块的l形、仅顶部或仅左侧因果邻居与预定搜索区域中的另一个块进行匹配来生成预测信号。有6个预定搜索区域,其中包含来自顶部和左侧ctu的重构样本以及当前ctu内位于当前块上方、左侧、左下角和右上方的部分重构样本。绝对差和(sum ofabsoluate differences,简称sad)用作成本函数。
45、i.7 基于模板的多参考线帧内预测
46、基于模板的多参考线(template-based multiple reference line,简称tmrl)帧内预测模式将参考线和预测模式结合在一起,以及使用模板匹配方法构建候选组合列表。对候选组合列表的索引进行编解码以指示在编解码当前块时使用哪条参考线和预测模式。非timd部分的常规多参考线(multiple reference line,简称mrl)由tmrl模式替换。
47、tmrl模式扩展参考线候选列表和帧内预测模式候选列表。扩展的参考线候选列表为{1, 3, 5, 7, 12}。对顶部ctu行的限制保持不变。帧内预测模式候选列表的大小为10。帧内预测模式候选列表的构建与mpm类似,不同之处在于planar模式被排除在帧内预测模式候选列表之外,在5个相邻pu模式和dimd模式(如果不包括)之后添加dc模式,以及添加了角度模式,其增量角度从±1到±4(与帧内预测模式候选列表中的现有角度模式相比)。角度预测的精度从65扩展到129。此外,在构建帧内候选列表时,非相邻位置被添加为候选。如果相邻或非相邻块采用sgpm或gpm模式编解码,则块的帧内模式将被分割角取代。
48、tmrl候选的构造如下。对于一个块,扩展参考线和允许的帧内预测模式有5x10=50种组合。由于扩展参考线从参考线1开始,因此参考线0覆盖的区域用于模板匹配。在预测(由50种组合生成)和重构之间计算模板区域上的sad成本(参见图3)。按升序选择sad成本最小的20种组合以形成tmrl候选列表。
49、对于tmr信令,不是直接对参考线和帧内模式进行编解码,而是tmrl候选列表的索引被编解码以指示使用哪种参考线和预测模式的组合来对当前块进行编解码。
50、i.8 卷积跨分量帧内预测模型(convolutional cross-component intraprediction model,简称cccm)
51、在该方法中,卷积跨分量模型(cccm)被应用来从重构的亮度样本中预测色度样本,其精神与当前cclm模式类似。与cclm一样,当使用色度子采样时,重构的亮度样本被下采样以匹配较低分辨率的色度网格。与cclm类似,顶部、左侧或顶部和左侧参考样本被用作模型推导的模板。
52、此外,与cclm类似,可以选择使用cccm的单模型或多模型变体。多模型变体使用两个模型,一个模型针对高于平均亮度参考值的样本而得出,另一个模型针对其余样本而得出(遵循cclm设计的精神)。对于具有至少128个可用参考样本的pu,可以选择多模型cccm模式。
53、i.8.1 cccm的卷积滤波器
54、卷积7抽头滤波器由5抽头加号形状的空间分量、非线性项和偏置项组成。滤波器的空间5抽头分量的输入由中心(c)亮度样本组成,该亮度样本与要预测的色度样本及其上方/北(n)、下方/南(s)、左侧/西(w)和右侧/东(e)相邻样本同位,如图4所示。
55、非线性项p表示为中心亮度样本c的二次幂,以及缩放到内容的样本值范围:
56、p =( c*c + midval )>>bitdepth。
57、也就是说,对于10比特内容,其计算如下:
58、p = ( c*c + 512 )>>10。
59、偏置项b表示输入和输出之间的纯量偏移(类似于cclm中的偏移项)并且设置为中间色度值(即,对于10比特内容为512)。
60、滤波器的输出被计算为滤波器系数ci和输入值之间的卷积,然后被剪裁到有效色度样本的范围内:
61、predchromaval = c0c + c1n + c2s + c3e + c4w + c5p + c6b。
62、i.8.2 cccm滤波系数的计算
63、滤波器系数ci通过最小化参考区域中预测和重构色度样本之间的mse来计算。图3示出由pu上方和左侧的2或6行色度样本组成的参考区域。在单模型cccm中,是否使用6行或2行相邻样本来导出cccm模型参数由模板成本决定。类似地,对于多模型cccm模式,两个候选使用6行相邻亮度样本或与当前色度块同位的亮度样本来导出平均值,该平均值用于将样本分成两组。成本通过将候选ccp(2或6行)应用于模板,计算模板中ccp预测样本和重构样本之间的绝对差之和(sad)而得出。
64、mse最小化通过计算亮度输入的自相关矩阵以及亮度输入与色度输出之间的互相关向量来执行。自相关矩阵是ldl分解,以及使用回代法(back-substitution)来计算最终的滤波器系数。该处理大致遵循ecm中alf滤波器系数的计算,然而ldl分解被选择而不是cholesky分解以避免使用平方根运算。
65、使用亮度和色度样本的重构值来计算自相关矩阵。这些样本是全范围的(例如,对于10比特内容,介于0和1023之间),从而导致自相关矩阵中的值相对较大。这需要在模型参数计算期间进行高比特深度操作。建议从每个模型的每个pu中的亮度和色度样本中移除固定偏移。这降低模型创建中使用的值的幅度,以及允许降低定点算法所需的精度。因此,建议使用16比特十进制精度,而不是原始cccm实现的22比特精度。
66、为简单起见,pu左上角外侧的参考样本值用作偏移量(offsetluma、offsetcb和offsetcr)。在模型创建和最终预测中使用的样本值(即参考区域中的亮度和色度以及当前pu中的亮度)减少了这些固定值,如下所示:
67、c' = c – offsetluma,
68、n' = n – offsetluma,
69、s' = s – offsetluma,
70、e' = e – offsetluma,
71、w' = w – offsetluma,
72、p' = nonlinear(c'),
73、b = midvalue = 1<<(bitdepth - 1),
74、使用以下公式预测色度值,其中offsetchroma分别等于cr和cb分量的offsetcr和offsetcb:
75、predchromaval = c0c' + c1n' + c2s' + c3e' + c4w' + c5p' + c6b +offsetchroma
76、i.8.3 cccm发送
77、模式的使用情况使用cabac编解码的pu级别标志来发送。包括一个新的cabac上下文来支持这一点。在通知时,cccm被视为cclm的子模式。也就是说,仅当帧内预测模式为lm_chroma时,才会发送cccm标志。
78、i.9 基于梯度和位置的卷积跨分量模型(gl-cccm)
79、该方法使用滤波器将亮度值映射到色度值,该滤波器的输入由一个空间亮度样本、两个梯度值、两个位置信息、一个非线性项和一个偏差项组成。gl-cccm方法使用梯度和位置信息,而不是cccm滤波器中使用的4个空间邻域样本。用于预测的gl-cccm滤波器是:
80、
81、其中,gy和gx分别是垂直和水平梯度,计算方法如图5所示:
82、
83、.
84、此外,y和x是中心亮度样本的空间坐标。
85、其余参数与cccm工具相同。参数计算的参考区域与cccm方法相同。
86、模式的使用情况使用cabac编解码的pu级别标志来发送。在发送时,gl-cccm被视为cccm的子模式。也就是说,只有当原始cccm标志为真时,才会发送gl-cccm标志。
87、与cccm类似,gl-cccm工具具有6种计算参数的模式:
88、• 来自上方和左侧模板的单模型 gl-cccm
89、• 来自上方模板的单模型 gl-cccm
90、• 来自左侧模板的单模型 gl-cccm
91、• 来自上方和左侧模板的多模型 gl-cccm
92、• 来自上方模板的多模型 gl-cccm
93、• 来自左侧模板的多模型 gl-cccm
94、编码器对6个gl-cccm模式以及现有的cccm模式执行satd搜索,以找到用于完整rd测试的最佳候选。
95、i.10 局部光照补偿(local illumination compensation,简称lic)
96、lic是一种帧间预测技术,用于将当前块与其预测块之间的局部光照变化建模为当前块模板与参考块模板之间的样本值的函数。该函数的参数可以用比例α和偏移β表示,它们形成线性方程(即,α*p[x]+β)以补偿光照变化,其中p[x]是mv指向的参考图片中位置x处的参考样本。当环绕运动补偿被启用时,mv应在考虑环绕偏移的情况下进行剪辑。由于α和β可以基于当前块模板和参考块模板得出,因此它们不需要任何信令开销,除了对amvp模式发送lic标志以指示lic的使用情况。
97、jvet-o0066中提出的局部光照补偿用于单向预测帧间cu,以及进行以下修改。
98、• 可以使用帧内相邻样本进行lic参数推导;
99、• 对于亮度样本少于32个的块,lic被禁用;
100、• 对于非子块和仿射模式,lic参数推导基于当前cu对应的模板块样本执行,而不是基于第一左上角16x16单元对应的部分模板块样本;
101、• 参考块模板的样本使用mc和块mv生成,无需将其四舍五入为整数像素精度。
102、i.11 模板匹配(template matching)
103、模板匹配(tm)是一种解码器侧mv导出方法,当前cu的运动信息通过查找当前图片610中的模板(即,当前cu 612的顶部相邻块614和/或左侧相邻块616)与参考图片中的块(即,与模板大小相同,块624以及626)之间的最接近匹配来细化,如图6所示。在图6中,在初始mv630指向的参考图片620中的位置628周围的[-8, +8]像素搜索范围622内,在当前图片610的当前cu 612的初始运动630周围搜索更好的mv。jvet-j0021中的模板匹配方法被使用,以及进行以下修改:搜索步长基于amvr模式来决定,以及tm可以在合并模式下与双边匹配处理级联。
104、在amvp模式下,mvp候选基于模板匹配误差决定,以选择实现当前块模板和参考块模板之间最小差值的mvp候选,然后仅对该特定mvp候选执行tm以进行mv细化。通过使用迭代16点菱形搜索,tm在[-8, +8]像素搜索范围内从全像素mvd精度(或4像素amvr模式的4像素)开始细化该mvp候选。amvp候选可以使用全像素mvd精度(或4像素amvr模式的4像素)的交叉搜索进一步细化,然后根据amvr模式依次使用半像素和四分之一像素。该搜索处理确保mvp候选在tm处理之后仍保持与amvr模式指示的相同的mv精度。在搜索处理中,如果迭代中前一个最小成本与当前最小成本之间的差值小于等于块面积的阈值,则搜索处理终止。
105、在合并模式下,类似的搜索方法被应用于合并索引指示的合并候选。tm可以一直执行到1/8像素mvd精度或跳过超过半像素mvd精度的mvd,这取决于是否根据合并的运动信息使用可选插值滤波器(当amvr为半像素模式时使用)。此外,当tm模式被启用时,模板匹配可以作为基于块和基于子块的双边匹配(bilateral matching,简称bm)方法之间的独立处理或额外的mv细化处理,这取决于根据其启用条件检查是否可以启用bm。
106、i.12 基于tm的子块运动细化
107、在jvet-af0168测试3.4a中,提出将模板匹配应用于基于子块的运动工具,包括仿射和sbtmvp模式。更具体地说,单向预测仿射合并候选的控制点运动向量(cpmv)和sbtmvp候选的运动偏移使用tm来细化。对于单向预测仿射合并候选,对所有cpmv分配相同的mv偏移,以及据此计算仿射候选的tm成本。具有最小tm成本的最佳cpmv偏移可用于细化相应的仿射候选。对于sbtmvp候选,初始运动偏移可以使用tm细化,然后子块时间运动信息利用细化的运动移位来导出。
108、i.13 基于obmc的模板匹配
109、在基于模板匹配的重迭块运动补偿(overlaped block motion compensation,简称obmc)方案中,cu边界样本推导方法的预测值不直接使用加权预测,而是根据模板匹配成本来决定,包括仅使用当前块的运动信息,或者同时使用相邻块的运动信息和其中一种混合模式。
110、在该方案中,对于上方cu边界上每个4×4大小的块,上方模板大小等于4×1。如果n个相邻块具有相同的运动信息,则由于mc操作可以一次处理,因此上方模板大小被扩大到4n×1。对于左侧cu边界上每个4×4大小的左侧块,左侧模板大小等于1×4或1×4n,如图7所示,其中粗线框710对应于cu。
111、i.14 使用模板匹配对合并候选进行适应性重新排序(adaptive reordering ofmerge candidates with template matching,简称armc-tm)
112、基于模板匹配(tm),合并候选进行适应性地重新排序。重新排序方法适用于常规合并模式、tm合并模式和仿射合并模式(不包括sbtmvp候选)。对于tm合并模式,合并候选在细化处理之前进行重新排序。
113、首先根据给定的检查顺序构建初始合并候选列表,例如空间、tmvp、非相邻、hmvp、成对、虚拟合并候选。然后将初始列表中的候选分为几个子组。对于模板匹配(tm)合并模式、适应性dmvr 模式,首先初始列表中的每个合并候选使用tm/多遍次dmvr进行细化。每个子组中的合并候选被重新排序以生成重新排序的合并候选列表,以及重新排序根据基于模板匹配的成本值进行。重新排序的合并候选列表中的选定合并候选的索引发送给解码器。为简化起见,最后一个而不是第一个子组中的合并候选不被重新排序。在构建合并运动向量候选列表期间,来自armc重新排序处理的所有零候选被排除。对于常规合并模式和tm合并模式,子组大小设置为5。对于仿射合并模式,子组大小设置为3。
114、i.15 带模板匹配(tm)的几何分割模式(geometric partitioning mode,简称gpm)
115、模板匹配应用于gpm。当gpm模式启用于cu时,cu级标志被发送以指示tm是否应用于两个几何分区。每个几何分区的运动信息使用tm细化。当tm被选择时,模板根据分区角度使用左侧、上方或左上方相邻样本进行构建,如表1所示。然后,通过使用与半像素插值滤波器禁用的合并模式相同的搜索模式,最小化当前模板与参考图片中的模板之间的差值来细化运动。
116、表1. 第一和第二个几何分区的模板,其中a代表使用上方样本,l代表使用左侧样本,以及l+a代表使用左侧和上方样本。
117、
118、i.16 基于模板匹配的gpm分割模式重新排序
119、在基于模板匹配的gpm分割模式重新排序中,给定当前gpm块的运动信息,计算gpm分割模式的相应tm成本值。然后,基于tm成本值按升序对所有gpm分割模式进行重新排序。不是发送gpm分割模式,而是使用 golomb-rice码发出索引,以指示gpm分割模式在重新排序列表中的确切位置。
120、gpm分割模式的重新排序方法为在生成编解码单元中两个gpm分区的各自参考模板之后执行的两步过程,如下:
121、• 将gpm分区边缘扩展到两个gpm分区的参考模板中,得到64个参考模板,以及计算64个参考模板中每个参考模板的相应tm成本;
122、• 根据gpm分割模式的tm成本值按升序重新排序,以及将最佳的32个分割模式标记为可用分割模式。
123、模板上的边缘从当前cu的边缘延伸,如图8所示,但是在跨边缘的模板区域中未使用gpm混合处理。
124、在使用tm成本升序重新排序之后,索引被发送。
125、i.17 具有模板匹配的ibc
126、模板匹配在ibc中用于ibc合并模式和ibc amvp模式。
127、与常规ibc合并模式所使用的列表相比,ibc-tm合并列表有所修改,使得候选根据修剪方法进行选择,候选之间具有运动距离,如常规tm合并模式中一样。结尾零运动满足被左侧(-w,0)、顶部(0,-h)和左上角(-w,-h)的运动向量取代,其中w是当前cu的宽度,h是当前cu的高度。
128、在ibc-tm合并模式中,所选候选在rdo或解码处理之前通过模板匹配方法进行细化。ibc-tm合并模式已与常规ibc合并模式竞争,以及tm合并标志被发送。
129、在ibc-tm amvp模式中,从ibc-tm合并列表中选择最多3个候选。使用模板匹配方法细化这3个选定候选中的每一个选定候选,以及根据其产生的模板匹配成本进行排序。然后,在运动估计处理中仅考虑前两个候选。
130、ibc-tm合并和amvp模式的模板匹配细化相当简单,因为ibc运动向量被约束为(i)整数和(ii)在参考区域内,如图9所示。参考区域910-940用于当前块在不同位置时的当前块的ibc运动向量,其中图示910对应于当前块落入当前ctu的左上64x64块的情况,图示920对应于当前块落入当前ctu的右上64x64块的情况,图示930对应于当前块落入当前ctu的左下64x64块的情况,图示940对应于当前块落入当前ctu的右下64x64块的情况。因此,在ibc-tm合并模式下,所有细化都以整数精度执行,而在ibc-tm amvp模式下,它们以整数或4像素精度执行,具体取决于amvr值。此类细化仅访问样本而不进行插值。在这两种情况下,细化的运动向量和每个细化步骤中使用的模板都必须遵守参考区域的约束。
131、i.18 mvd预测
132、该方法首先根据模板匹配成本对可能的mvd符号组合和mvd幅值前6个最显著后缀比特(most signification suffix bins)的可能组合进行排序,然后导出真实mvd符号和mvd幅值对应的索引,并进行上下文编码。在解码器侧,mvd导出如下:
133、1. 解析mvd分量的大小
134、2. 解析上下文编解码的mvd预测索引
135、3. 通过创建可能的符号和可能的mvd大小之间的组合来构建mv候选以及将其添加到mv预测子
136、4. 根据模板匹配成本和排序导出每个导出的mv的mvd预测成本
137、5. 使用发送的索引来选择真正的mvd
138、mvd预测适用于帧间amvp、仿射amvp、mmvd和仿射mmvd模式。注意,当启用环绕运动补偿时,应在考虑环绕偏移的情况下对mv候选进行剪辑。
139、i.19 bvd预测
140、与mvd预测类似,ibc模式的可能的bvd符号组合按照模板匹配成本进行排序。此外,用于表示bvd幅度的指数哥伦布码的前4个最显著后缀箱也按照tm成本进行排序。示例如图10所示,其中显示的是当前pu 1010的bv、bvp和bvd。模板匹配操作用于决定具有最佳成本的bvd候选,以及在比特流中指示最佳候选是否被正确预测。
141、i.20 块级参考图片列表重新排序
142、基于模板匹配的块级参考图片重新排序方法被采用。对于单向预测amvp模式,列表0和列表1中的参考图片被交织以生成联合列表。对于联合列表中的参考图片的每个假设,模板匹配被执行以计算成本。联合列表基于模板匹配成本的升序重新排序。重新排序的联合列表中的所选参考图片的索引在比特流中发送。对于双向预测amvp模式,来自列表0和列表1的参考图片对列表被生成,以及基于模板匹配成本类似地重新排序。所选参考图片对的索引被发送。
143、i.21 基于模板匹配的bcw索引导出合并模式
144、合并编解码cu的具有cu级权重的双向预测(bi-prediction with cu-levelweight,简称bcw)索引基于模板匹配成本得出,而不是从相邻块得出。给定选定的合并候选,tm成本值使用不同的双向预测权重进行计算,然后具有最小tm成本值的双向预测权重被用来预测合并cu。
145、计算双向预测权重的tm成本时,应用以下规则:
146、由于继承的双向预测权重可能比其他权重具有更高的准确率,因此仅考虑继承的双向预测权重及其两个相邻权重(即±1)。例如,如果继承的双向预测权重为4,则只有三个权重{3,4,5}参与tm成本计算。
147、继承的bcw索引的tm成本乘以0.90625,即成本减少了3/32。
148、因为双向预测样本对bdof有益且bdof仅适用于具有相等权重的cu,相等权重的tm成本乘以0.90625。
149、基于模板匹配的bcw索引推导应用于以常规合并、模板匹配、适应性解码器侧运动向量细化和mmvd模式编解码的cu。
150、此外,合并模式的双向预测权重从{-2,3,4,5,10}扩展到{1,2,3,4,5,6,7}。此外,非合并模式的双向预测负权重{-2,10}被正权重{1,7}取代。
151、虽然模板匹配工具可能有助于提高编解码效率,但模板匹配工具也显著增加了系统计算要求。仅当模板匹配工具可能有助于提高性能时才希望打开模板匹配工具。因此,在本发明中,控制模板匹配工具使用的方法和装置被提出。
技术实现思路
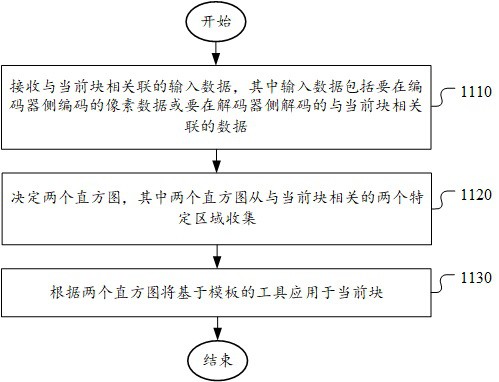
1、一种视频编解码方法和装置被提出。根据该方法,与当前块相关联的输入数据被接收,其中,输入数据包括编码器侧待编码的像素数据或解码器侧待解码的与当前块相关联的数据。两个直方图被决定,其中,两个直方图从与当前块相关联的两个特定区域收集。根据两个直方图,基于模板的工具被应用于当前块。
2、在一个实施例中,如果两个直方图之间的相似度较小,则基于模板的工具禁用于当前块。在一个实施例中,两个直方图之间的相似度通过使用两个直方图之间的绝对差值之和(sad)作成本函数来测量。
3、在一个实施例中,两个特定区域对应于当前块和当前模板,其中,当前模板指的是与当前块相邻的重构样本。
4、在一个实施例中,两个直方图对应于样本值的分布、从样本值得出的中值或平均值、从样本值得出的方差、标准化样本值、梯度值或角度方向。
5、在一个实施例中,如果两个直方图的对应第一比特(bin)的第一中心之间的第一差值小于阈值,两个直方图的对应第二比特的第二中心之间的第二差值小于阈值,两个直方图的对应其余前n个比特的其余中心之间的其余差值均小于阈值,或者上述情况的组合,则基于模板的工具被启用。
6、在一个实施例中,如果两个直方图之间的相似度较小,则基于模板的工具被应用于使用简化的模板候选集的当前块。
7、在一个实施例中,如果两个直方图之间的相似度较小,则基于模板匹配的搜索或与基于模板的工具相关的intratmp的搜索范围会减小。
8、在一个实施例中,如果两个直方图之间的相似度较小,则减少基于模板的帧内模式推导(template-based intra mode derivation,简称timd)、解码器侧帧内模式推导(decoder-side intra mode derviation,简称dimd)、重迭块运动补偿(overlapped blockmotion compensation,简称obmc)、基于模板的多参考线(template-based multiplereference line,简称tmrl)或帧内预测融合的候选数量。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com