
一种基于SA-WGAN的入侵检测数据增强方法
本发明涉及入侵数据检测,尤其涉及一种基于sa-wgan的入侵检测数据增强方法。
背景技术:
1、随着工业互联网的快速发展,工业系统的数字化转型已经成为现代制造业的重要趋势。然而,随之而来的是对工业互联网安全性的日益关注,尤其是针对工业控制系统的入侵威胁。工业互联网的复杂性和关键性使其成为恶意攻击的目标,这些攻击可能导致生产中断、数据泄露以及系统瘫痪,给企业造成巨大的经济损失,并带来了严重的声誉风险。
2、在网络安全领域,入侵检测是一个重要的任务,其目的是从大量的网络流量中识别出潜在的恶意行为。然而,在实际应用中,工业互联网的正常运行往往会产生大量的正常流量数据,这些数据占据了数据集的绝大部分。然而,异常流量数据,即那些可能表示入侵或攻击的数据,相对较少。这种数据不平衡问题会导致入侵检测系统难以有效地学习和识别异常模式,因为模型在训练过程中可能过于关注正常流量数据,而忽视了异常流量数据。这种数据不平衡不仅限制了模型的泛化能力,还可能使模型过于偏向于多数类样本,从而无法准确识别潜在的安全威胁。
3、ian goodfellow等首次提出生成对抗网络模型,这是一种用于生成建模的神经网络架构。生成对抗网络是近年来深度学习领域中的一大创新,其独特的结构和设计思想在诸多应用中展现出巨大的潜力。生成对抗网络gan由两个神经网络组成:生成器(generator)和判别器(discriminator),两者相互竞争、相互协作,在一种名为“零和博弈”的游戏中不断优化,以达到各自的目标。传统生成对抗网络中使用的jensen-shannon(js)散度作为损失函数,其作用是度量生成样本分布与真实样本分布之间的差异,从而引导生成器朝着生成逼真样本的方向进行训练。然而,由于js散度在两个分布之间存在不对称性,使得生成器和判别器的训练过程可能出现不平衡,可能导致训练过程不稳定、模式崩溃和梯度消失或爆炸等问题。虽然改进后的深度学习模型在入侵检测实验中已经取得了优秀的检测准确率,但早期的研究忽视了不同类别训练样本的数据分布不平衡问题,在处理不平衡数据集时,传统的机器学习方法往往难以有效地学习和泛化稀少类别的样本,这导致分类模型仅对多数类测试样本具有很高的检测率,而少数类样本的检测率却不能达到平均水平。
4、生成对抗网络gan模型结构如图1所示,主要包括判别器和生成器两部分。生成对抗网络gan模型中生成器的目标是从随机噪声中生成逼真的数据样本。它通常是一个神经网络,以随机向量作为输入,通过一系列的神经网络层将其转换为与训练数据相似的数据样本。判别器是另一个神经网络,其目标是区分生成器生成的生成样本和真实样本。在训练过程中,生成器和判别器通过反向传播算法和梯度下降来更新各自的参数。判别器的损失函数通常基于其正确判断真实样本和生成数据的准确性,而生成器的损失函数则基于其生成的数据被判别器误判为真实样本的程度。通过交替更新生成器和判别器的参数,gan能够逐渐提高生成数据的质量,使得生成的数据更加接近真实样本。gan的目标函数为:
5、
6、其中,d(x)表示判别器判断数据x为真实样本的概率,g(z)表示生成器根据噪声z生成的数据ex~data和ez~data分别表示对真实样本和噪声数据的期望。这个目标函数实际上是一个零和博弈,生成器的目标是最小化这个目标函数,而判别器的目标是最大化它。
7、公开号为cn110113353a的发明专利,公开了一种基于cvae-gan的入侵检测方法,涉及入侵检测技术领域,包括以下主要步骤:(一)进行数据增强;(二)进行数据预处理;(三)进行自编码器网络特征提取;(四)进行入侵识别;(五)进行异常处理。此发明有效地解决了入侵检测系统对某类或某几类数据检测率过低的问题。但是此发明无法解决由于js散度在两个分布之间存在不对称性,使得生成器和判别器的训练过程可能出现不平衡的问题。
技术实现思路
1、针对现有网络的生成器和判别器训练过程可能出现数据不平衡的技术问题,本发明提出一种基于sa-wgan的入侵检测数据增强方法,利用改进的生成对抗网络wgan改进训练稳定性和提高生成样本的多样性,不仅有效平衡了数据集,还提高了模型的检测精度和泛化能力。
2、为了达到上述目的,本发明的技术方案是这样实现的:
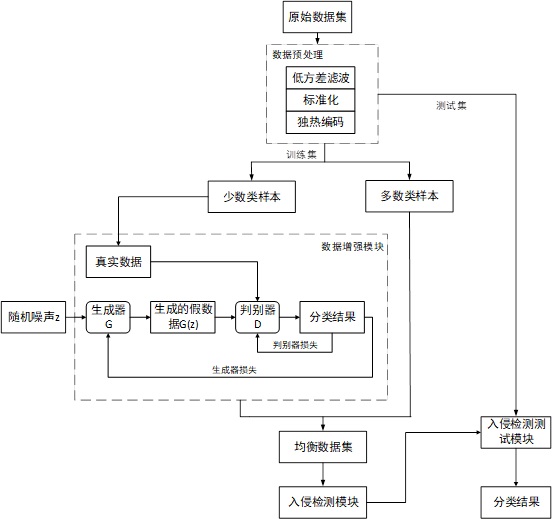
3、一种基于sa-wgan的入侵检测数据增强方法,包括以下步骤:
4、s1:构建sa-wgan模型,包括依次连接的随机数发生器、生成器和判别器;
5、s2:获取原始数据集,对原始数据集进行数据预处理,并将处理结果分为训练集和测试集,将训练集分为少数类真实样本和多数类真实样本,初始化sa-wgan模型;
6、s3:使用随机数发生器产生随机噪声,将随机噪声作为生成器的输入层,生成器经过卷积处理和注意力计算生成生成样本;
7、s4:将少数类真实样本和生成样本进行级联归一化,并将级联归一化结果传入判别器,判别器进行特征提取和分类决策获取生成样本得分和真实样本得分;
8、s5:利用生成样本得分获取生成器损失函数并计算生成器损失,利用生成样本得分和真实样本得分通过计算wasserstein损失和计算梯度惩罚项获取判别器损失函数并计算判别器损失,分别通过反向传播更新生成器参数和判别器参数;
9、s6:重复步骤s3到s5,直到达到预定的训练轮数或损失函数收敛,将生成器参数和判别器参数进行保存,得到增强后的sa-wgan模型;
10、s7:将增强后的sa-wgan模型生成的数据和多数类真实样本按数据类型进行整合,得到经过数据增强后的均衡数据集,然后利用测试集对经过数据增强后的均衡数据集进行验证,获取最终分类结果。
11、步骤s2所述的对原始数据集进行数据预处理的方法为:利用低方差滤波器处理具有多个特征的原始数据集,去除原始数据集中方差最小的多个特征列,最终得到一个具有多维有效特征值的数据集xp;使用归一化公式将数据集xp中的特征映射到范围[0,1],使用独热编码,为映射后的离散特征数据建立一个映射表,得到有序化和连续化的数据集l,将数据集l按比例分成训练集和测试集。
12、步骤s2所述的初始化sa-wgan模型的方法为:使用随机初始化或特定权重初始化对生成器和判别器的权重和偏置参数进行初始化。
13、步骤s3所述的生成生成样本的方法为:使用随机数发生器产生随机噪声z,在生成器中,对随机噪声z通过反卷积层、归一化层和relu激活函数生成特征图x,特征图x经过三个不同的线性变换分别得到查询向量f(xi)=wfxi、键向量g(xi)=wgxi、值向量h(xi)=whxi,其中,xi∈x为特征向量,i={1,2,..,n},n为随机噪声z的序列长度,wf、wg、wh表示权重矩阵;使用公式sij=f(xi)tg(xi),得到一个相似度分数矩阵s,sij∈s表示查询向量f(xi)与键向量g(xi)之间的相似度,应用softmax函数将相似度分数矩阵s转化为注意力权重矩阵β,注意力权重矩阵β中每个元素为注意力权重每个值向量h(xi)乘以对应的注意力权重βj,i,然后将所有值向量加权结果βj,ih(xi)相加,得到当前查询位置的注意力输出特征从而获得注意力特征图o,oj∈0,将注意力特征图o经过转置卷积层操作,再通过公式yi=γoj+h(xi)将注意力特征oj与值向量h(xi)组合获得具有注意力机制的特征映射yi,得到特征映射图y,yi∈y,其中γ为可学习的参数,通过生成器的卷积层对特征映射图y进行特征提取和转换,最终输出为生成样本g(z)。
14、步骤s4所述的获取生成样本得分和真实样本得分的方法为:将少数类真实样本x和生成样本g(z)经过级联归一化、卷积层、池化层得到输入数据,判别器通过卷积运算和激活函数leaky relu对输入数据进行特征提取,判别器使用分类决策通过全连接层将提取的特征映射到一个概率值,分别得到生成样本得分d(g(z))和真实样本得分d(x),d()表示判别器输出函数,激活函数leaky relu的数学表达式为:
15、
16、其中,α为leak系数,b为卷积运算结果,f(b)表示leaky relu函数输出。
17、步骤s5所述的利用生成样本得分获取生成器损失函数的方法为:通过判别器获取到的生成样本得分d(g(z))最大化判别器对生成样本的评价,得到生成器损失函数:
18、
19、其中,表示生成样本得分的期望,pg为生成样本分布。
20、步骤s5所述的计算wasserstein损失的方法为:根据wasserstein距离公式,利用限制条件||d||l≤k,将判别器所有权重参数限制在[-c,c],从而得到基于wasserstein损失的判别器损失函数,利用基于wasserstein损失的判别器损失函数计算wasserstein损失,wasserstein距离公式为:
21、
22、基于wasserstein损失的判别器损失函数为:
23、
24、其中,pr为真实样本分布,表示真实样本得分的期望,||d||l为判别器输出函数d()的lipchitz常数,k是一个正实数,c为权重裁剪阈值。
25、步骤s5所述的计算梯度惩罚项的方法为:首先,从真实样本分布pr中采样一个真实样本x,再从生成样本分布pg中采样一个生成样本g(z),接下来,生成真实样本和生成样本之间的随机插值点然后计算关于随机插值点的判别器输出函数在随机插值点处的梯度得到最终判别器的损失函数:
26、
27、其中,g(z)来自生成样本分布pg中采样得到,x自真实样本分布pr中采样得到,表示g(z)和x混合的数据,表示对任意服从真实样本分布pr和生成样本分布pg的数据之间的直线上均匀采样,是梯度惩罚项,λ是梯度惩罚项系数。
28、步骤s5所述的分别通过反向传播更新生成器参数和判别器参数方法为:判别器参数的更新:根据判别器损失函数ld通过反向传播算法计算出判别器中每一层参数的梯度l表示层数,使用梯度下降算法根据梯度更新判别器的权重和偏置参数;
29、生成器参数的更新:使用判别器损失函数ld通过链式求导法则生成样本得分d(g(z))通过反向传播算法计算出生成器中每一层参数的梯度使用优化算法根据梯度更新生成器的权重和偏置参数。
30、利用增强后的sa-wgan模型得到最终训练数据,然后按照数据类型将增强后的sa-wgan模型生成的数据与多数类真实样本通过级联归一化按行进行拼接,从而构建出经过数据增强后得到的均衡数据集,将经过sa-wgan模型增强后的均衡数据集分别输入到cnn和sru分类模型中进行训练,再利用测试集进行测试,获取最终分类结果。
31、本发明的有益效果:
32、自注意力机制被集成到生成器中,生成器在生成新的异常流量数据时,会利用自注意力机制来关注流量数据中的关键特征,生成的异常流量样本不仅数量上增加了,而且在质量上也更加接近真实的异常流量,从而有效地平衡了数据集,还提高了模型的检测精度和泛化能力,为工业互联网的安全性提供了有力保障。
33、通过改进训练稳定性和提高生成样本的多样性,引入wasserstein距离代替js散度,wasserstein距离可以更准确地度量两个概率分布之间的差异,并且在梯度消失和模式崩溃等问题上更加稳定。
34、在损失函数中加入梯度惩罚项,直接作用于梯度,通过对判别器的梯度进行惩罚来确保梯度的大小和方向符合要求,更加精确地控制梯度大小,避免了权重裁剪可能引起的梯度消失或梯度爆炸问题。
35、这种结合自注意力和生成对抗网络的数据增强方法,为工业互联网入侵检测领域提供了一种新的解决方案。通过增强数据集,可以更加有效地训练入侵检测模型,提高其对潜在安全威胁的识别能力,从而提升工业互联网的整体安全性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com