
一种面向GEO的品牌AI可见性评估与优化系统的制作方法
本发明涉及人工智能搜索引擎优化,具体涉及一种针对中文ai搜索平台(豆包、通义千问、文心一言、deepseek等)的品牌可见性评估方法、引用源权重自动校准机制、内容引用概率预评估引擎及多平台内容差异化自动生成引擎。
背景技术:
1、随着以大语言模型(llm)为核心的生成式ai搜索平台(如豆包、通义千问、文心一言、deepseek)在中国市场快速普及,传统seo(搜索引擎优化)技术已无法满足品牌在ai搜索场景中的可见性需求。生成式引擎优化(geo, generative engine optimization)作为新兴技术方向,旨在让品牌信息被ai搜索平台的rag(检索增强生成)机制高频引用和推荐。
2、现有技术存在以下不足:
3、缺乏标准化的品牌ai可见性评估方法:现有方案仅以简单的"引用率"(被提及次数÷总查询次数)作为评估指标,未考虑提及位置质量、平台覆盖度、竞品相对优势、引用稳定性和维度均衡性等多维度因素,无法准确反映品牌在ai搜索生态中的真实可见性状态。
4、ai平台引用源权重采用固定配置:不同行业的ai平台引用源分布差异显著(如医疗行业通义千问和deepseek引用权重高于豆包,而装修行业豆包引用权重最高),现有方案使用统一的固定权重,导致评估结果偏离行业真实情况。
5、内容发布前缺乏引用效果预测机制:现有geo服务采用"发布→等待→复测"的被动模式,无法在内容发布前预估其被ai平台引用的概率,导致大量低效内容浪费资源。
6、多平台内容差异化依赖人工经验:同一话题需要在多个内容平台(今日头条、搜狐号、百家号、csdn、知乎等)发布,各平台的写作风格、审核规范、ai抓取偏好差异巨大,现有方案依赖人工逐篇调整,效率低且差异化程度不可控。
技术实现思路
1、本发明提出一种面向geo的品牌ai可见性评估与优化系统(泽引geo系统),包含四个核心技术模块。系统整体架构如图1所示。
2、技术问题:解决现有geo评估仅依赖单一引用率指标、无法反映品牌在ai搜索生态中真实可见性状态的问题。
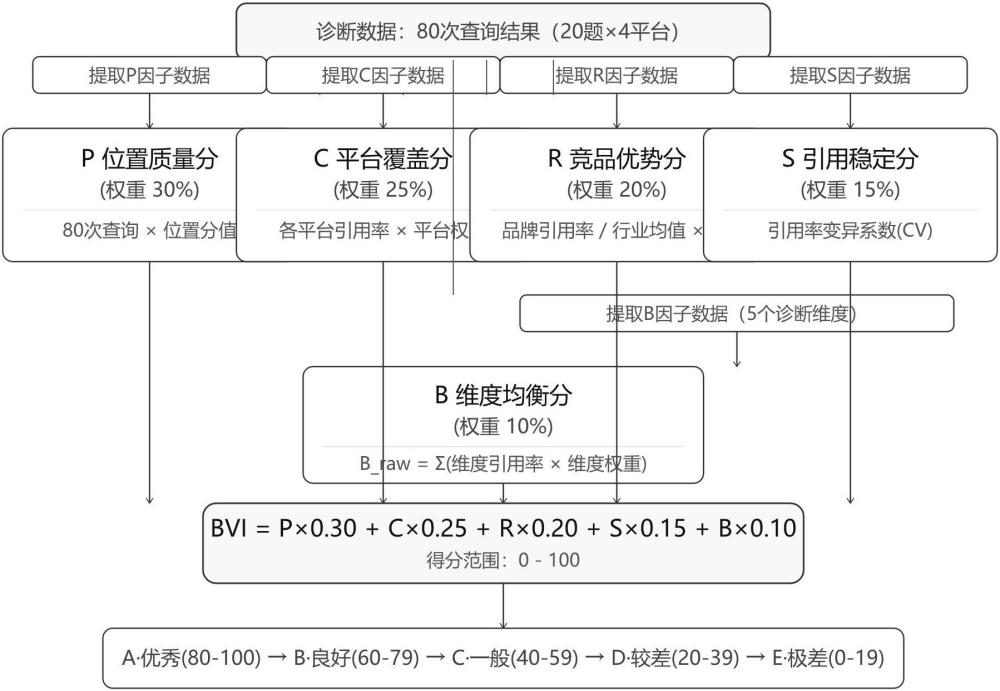
3、技术方案:提出一种多维度加权复合评估算法,通过五个因子的加权计算,得出0-100分的品牌ai可见性指数(bvi)。
4、五因子定义及权重
5、位置质量分(p):权重30%,品牌在ai回答中的提及位置(首推/前三/仅提及)
6、平台覆盖分(c):权重25%,品牌在各ai平台的引用率加权覆盖度
7、竞品优势分(r):权重20%,品牌引用率相对于竞品的优势程度
8、引用稳定分(s):权重15%,品牌引用率的时间稳定性(需多次诊断数据)
9、维度均衡分(b):权重10%,品牌在5个诊断维度的均衡表现
10、计算公式
11、bvi = p × 0.30 + c × 0.25 + r × 0.20 + s × 0.15 + b × 0.10
12、p因子(位置质量分)计算
13、对20题×4平台=80次查询,每次查询根据品牌在ai回答中的提及位置赋分:
14、首推(ai首先推荐):5分
15、第2-3位推荐:3分
16、仅提及(在回答中被提到但非推荐):1分
17、未提及:0分
18、p = (实际得分总和 / 理论满分) × 100 理论满分 = 80 × 5 = 400
19、c因子(平台覆盖分)计算
20、根据各ai平台的引用率和平台权重计算:
21、c = (豆包引用率 × w_doubao + 通义引用率 × w_tongyi + 文心引用率 ×w_wenxin + deepseek引用率 × w_deepseek) × 100
22、其中 w_doubao、w_tongyi、w_wenxin、w_deepseek 为平台权重,由专利模块二动态提供。
23、r因子(竞品优势分)计算
24、当有竞品数据时:r = (品牌引用率 / 行业平均引用率) × 50,上限100 当无竞品数据时:r = 50(基准分)
25、s因子(引用稳定分)计算
26、当有多次诊断数据时:s基于引用率的变异系数(cv)计算,cv越小分越高 当仅有单次诊断时:s = 50(基准分)
27、cv ≤ 10%:100
28、10% 29、20% 30、30% 31、cv>40%:20 32、b因子(维度均衡分)计算 33、5个诊断维度:品牌直查(20%)、行业推荐(30%)、场景需求(25%)、竞品对比(15%)、行业知识(10%) 34、b_raw = 品牌直查率×0.20 + 行业推荐率×0.30 + 场景需求率×0.25 + 竞品对比率×0.15 + 行业知识率×0.10 零分项惩罚 = 零分维度数量 × 5 b = max(b_raw× 0.30, b_raw - 零分项惩罚) 35、保底机制:b分不低于原始分的30%,确保新客户首次诊断时(大部分维度为0是正常状态)不会被过度惩罚。 36、bvi等级映射 37、80-100:a·优秀,品牌在ai搜索中高度可见 38、60-79:b·良好,品牌有较好可见性,需持续优化 39、40-59:c·一般,品牌可见性不足,需系统性内容投入 40、20-39:d·较差,品牌在ai搜索中基本不可见 41、0-19:e·极差,品牌在ai搜索中完全隐形 42、首次将品牌ai可见性从单一引用率指标扩展为五维度复合评估 43、位置质量因子(p)区分了"首推"和"仅提及"的价值差异 44、维度均衡因子(b)及其保底惩罚机制平衡了全面性和新客户友好性 45、bvi等级映射为geo服务效果提供了标准化的量化评价依据 46、实测验证数据 47、华康医院(医疗行业):总引用率18.8%,bvi分数23.9,等级d 48、斯贝佳(食品行业):总引用率37.5%,bvi分数31.4,等级d 49、验证结论:bvi分数能够反映引用率无法体现的维度差异——斯贝佳虽然总引用率是华康的2倍,但bvi仅高出7.5分,因为斯贝佳在行业知识维度同样为0%,维度均衡性问题限制了bvi提升。 50、bvi五因子计算流程如图2所示。 51、技术问题:解决ai平台引用源权重在不同行业间差异显著、固定权重配置导致bvi评估偏离真实情况的问题。 52、技术方案:提出一种"行业基准权重+诊断数据动态微调"的两级校准机制。 53、第一级:行业基准权重表 54、基于实测数据建立10+行业的ai平台基准权重配置: 55、通用(默认):豆包0.35、通义0.25、文心0.20、deepseek0.20(综合多行业平均) 56、法律:豆包0.25、通义0.30、文心0.15、deepseek0.30(通义+deepseek引用华律网/找法网) 57、医疗/牙科:豆包0.25、通义0.30、文心0.15、deepseek0.30(通义+deepseek引用牙舒丽网/99健康网) 58、装修:豆包0.40、通义0.25、文心0.15、deepseek0.20(豆包引用土巴兔+搜狐+头条) 59、餐饮:豆包0.30、通义0.30、文心0.15、deepseek0.25(豆包+通义引用大众点评) 60、食品:豆包0.35、通义0.20、文心0.15、deepseek0.30(豆包引用头条/什么值得买) 61、教育:豆包0.30、通义0.25、文心0.20、deepseek0.25(各平台较均衡) 62、酒店:豆包0.30、通义0.25、文心0.20、deepseek0.25(携程/大众点评为核心引用源) 63、科技:豆包0.30、通义0.25、文心0.15、deepseek0.30(csdn+博客园→deepseek+通义) 64、第二级:诊断数据动态微调 65、在行业基准权重基础上,根据该客户实际诊断数据进行±0.05的动态调整。 66、a) 提取诊断数据中"行业推荐维度"(第5-8题)在4个ai平台的引用率 67、b) 如果某平台在行业推荐维度的引用率比其他平台高出20个百分点以上,该平台权重上浮0.05,从最低权重平台扣除0.05 68、c) 如果某平台在行业推荐维度引用率为0%且基准权重≥0.25,该平台权重下调0.05,平均分配给引用率>0的平台 69、d) 校准后所有权重归一化,确保总和=1.00 70、行业匹配容错机制 71、诊断报告中的行业描述可能与基准权重表的key不完全一致(如"医疗健康"vs"医疗"),采用双向包含匹配算法,先对行业描述小写化,然后遍历基准权重表的关键词进行双向包含判断。 72、引用源权重两级校准流程如图3所示。 73、技术问题:解决现有geo服务在内容发布前无法预估ai引用效果、只能依赖"发布→复测"被动模式的问题。 74、技术方案:提出一种基于四维度多因子评分模型的内容引用概率预评估方法。 75、四维评估模型(满分100分) 76、平台-ai通路匹配:0-30分,内容发布平台与目标ai平台的数据源通路匹配程度 77、内容质量:0-30分,内容的字数、类型和结构化程度 78、ai抓取友好度:0-25分,关键词位置、geo关键词密度和品牌篇幅占比 79、竞争优势:0-15分,竞品提及数量和账号类型匹配程度 80、平台-ai通路匹配关系表(节选) 81、今日头条→豆包:30分 82、百家号→文心一言:30分 83、搜狐号→通义千问:28分 84、搜狐号→deepseek:25分 85、网易号→通义千问:28分 86、网易号→deepseek:25分 87、csdn→deepseek:28分 88、博客园→通义千问:26分 89、博客园→deepseek:26分 90、知乎→任一平台:15分 91、其他未列出组合:5分(弱通路) 92、内容质量评分规则 93、字数:800-1200字得10分,600-799或1201-2000字得7分,其他得3分 94、内容类型:c类(深度横评对比)得10分,b类(行业知识科普)得8分,a类(品牌展示介绍)得5分 95、结构加分:含faq问答+5分,含数据表/对比表+3分,技术类平台含代码片段+2分 96、等级与预测引用率映射 97、≥85:a,75-90% 98、70-84:b,55-75% 99、55-69:c,35-55% 100、40-54:d,15-35% 101、<40:e,<15% 102、技术效果:将geo内容生产从"发布后被动等待"转变为"发布前主动预测",系统根据各维度的失分点自动生成优化建议(如"品牌词应在文章前500字内出现")。 103、引用概率预评估四维模型如图4所示。 104、技术问题:解决同一话题在多内容平台发布时,差异化依赖人工经验、效率低且差异化程度不可控的问题。 105、技术方案:提出一种三层递进的差异化自动生成引擎。 106、第一层:平台结构化规则库 107、为各内容平台维护结构化的创作规则,以json格式存储: 108、{ "platform": "今日头条", "targetai": "doubao", "tone": "信息流深度解读者,从业者分享语气,自称小编", "structure": "导语(100字)→正文分段(每段带小标题)→faq(2-3个q&a)→话题标签", "wordrange": [800, 1200], "musthave": ["前三段配图位", "标题用数字+疑问+利益点"], "forbidden": ["禁止蓝色科技风配图"], "keywordrules": { "brandin500": true, "geokeywordmin": 2, "localkeywordmin": 2 }, "imageprompt": "手机实拍/自然光线/随手拍角度", "accountrules": { "a": "品牌官方口吻", "b": "行业专家口吻", "c": "真实用户口吻,自称'我'" } } 109、第二层:差异化创作指令生成 110、输入:话题+客户信息+目标平台列表+内容类型+账号类型 111、对每个目标平台,系统自动生成一套结构化的创作指令(styleguide json),创作指令传递给内容生产模块,由内容生产模块按指令生成完整文章。 112、第三层:差异化检测 113、对同一话题在不同平台生成的文章,自动检测差异化程度。 114、提取每篇文章的关键词指纹(品牌名+行业关键词+核心论点关键词) 115、计算任意两篇文章的关键词重合度(jaccard相似度算法) 116、对比开头段落、论证结构、结论表述的相似度 117、综合计算差异化分数(0-100%) 118、差异化≥40%:通过,可以发布 119、差异化<40%:不通过,需要重写其中一篇 120、将多平台内容差异化从人工经验驱动转为系统自动化 121、平台规则库确保生成内容符合各平台审核要求 122、差异化检测阈值(≥40%)确保同一话题在不同平台不会被ai判定为重复内容 123、创作指令与内容生产解耦,规则更新不影响生产逻辑 124、实测验证数据 125、云南geo优化值不值得(今日头条+搜狐号):差异化分数65%,信息流 vs 特稿 126、云南geo优化值不值得(今日头条+搜狐号+csdn):差异化分数68.1%,信息流 vs特稿 vs 技术博客 127、多平台差异化生成数据流如图5所示。 128、系统集成与闭环反馈 129、诊断阶段:20题×4平台诊断→诊断数据→模块2(权重校准)→模块1(bvi计算)→bvi分数+等级 130、内容生产阶段:话题+平台→模块4(差异化指令)→模块3(引用预测)→内容生产模块(全文生成)→差异化检测→内容资产库 131、效果监测阶段:月度复测→新诊断数据→模块2(权重再校准)→模块1(bvi重算)→与上月对比 132、模块3的引用预测分与月度监测的实际引用结果形成闭环: 133、发布前:模块3预测引用概率 134、发布后1月:监测实际引用结果 135、对比预测值vs实际值,校准预测模型参数 136、积累数据后持续提高预测准确度 137、闭环反馈机制如图6所示。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com