
一种基于大语言模型驱动的自动化不确定性量化分析方法及系统
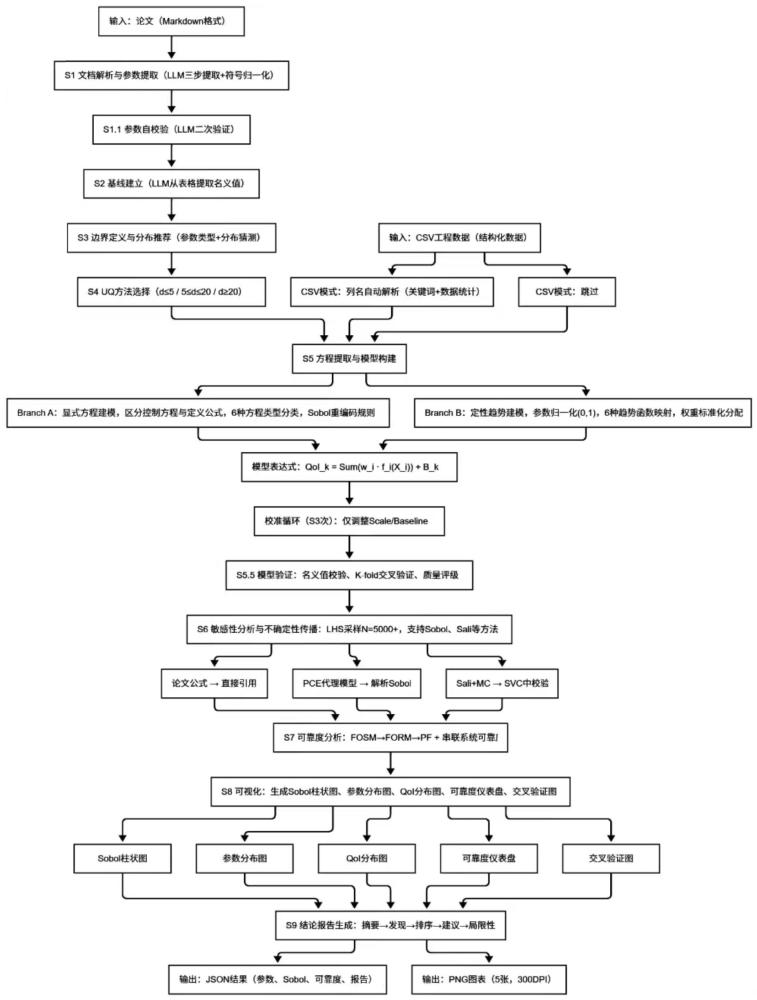
本发明属于工程不确定性量化(uncertainty quantification, uq)分析,具体涉及一种基于大语言模型(large language model, llm)驱动的自动化不确定性量化分析方法和系统,用于从科研论文文本或工程数据中自动完成参数提取、模型构建、敏感性分析、不确定性传播和可靠度评估的全流程自动化分析。
背景技术:
1、不确定性量化在工程设计中发挥着关键作用,用于系统评估输入参数变异性如何通过计算模型传播并影响最终性能预测。完整的uq工作流通常包括五个步骤:(i)从相关文献中手动识别不确定参数及其数值范围;(ii)构建代理模型或配置物理仿真器;(iii)使用拉丁超立方采样(latin hypercube sampling, lhs)等采样方法对输入参数空间进行采样;(iv)计算全局敏感性指数以排序参数重要性;(v)通过一阶二次矩方法(first ordersecond moment, fosm)评估可靠度。手动执行此工作流需要同时具备工程领域专业知识和uq方法学知识,通常每篇论文需要数小时至数天的时间,且不同分析人员对同一篇论文的分析结果往往存在显著差异,可重复性低。
2、现有uq软件工具如sandia国家实验室开发的dakota、法国电力公司开发的openturns和瑞士苏黎世联邦理工学院开发的uqlab提供了采样、敏感性分析和可靠度方法的稳健实现。然而,这些工具均要求用户手动指定模型输入函数、参数范围、概率分布类型和输出定义,未能自动化最关键的初始步骤——从论文中提取相关信息。这一步骤既是工作流中最耗时的环节,也是最容易出错的环节。此外,概率编程框架如pymc和stan虽然自动化了贝叶斯推断过程,但要求用户使用领域特定语言手动指定模型结构,同样无法从论文文本中自动提取模型信息。
3、近年来,大语言模型(llm)在自动化科学任务方面展现出卓越能力。领域特定代理系统如chemcrow(化学合成)、mlagentbench(机器学习实验)和boiko等人的自主化学研究系统已证明llm能够自主规划和执行多步科学工作流,从被动文本生成器转变为主动科学推理代理。然而,现有系统均未提供专门用于端到端不确定性量化的能力,无法自动从论文中提取uq参数、构建代理模型并执行敏感性分析。
4、在代理模型构建方面,现有技术中常用的加权平均公式 `qoi = (σw_i·f_i) /σw_i` 存在显著的方差压缩问题:低权重参数的方差贡献被所有权重的平方和二次压缩,导致其在sobol分解中几乎不可见。例如,在含7个参数且权重和 σw_j = 2.65 的系统中,权重为 w_i = 0.05 的参数在加性公式中的方差贡献为 w_i² = 0.0025,而在加权平均公式中变为 0.0025/7.02 ≈ 0.00036,降低了一个数量级。这种压缩效应使得加权平均公式无法正确区分重要参数和不重要参数。
5、在sobol敏感性指数计算方面,标准saltelli估计方法使用两个独立样本均值之积 `f_0² = mean(f_a) · mean(f_b)` 估计总均值平方,引入阶数为 o(1/√n) 的叉积偏置。该偏置导致部分参数无法满足 s_i ≤ st_i 的基本数学约束,降低了敏感性分析结果的可信度。此外,llm生成的代码由于缺乏统一的编码规范,常使用 np.clip、布尔索引和if/else 条件分支等操作,在sobol分析中产生平坦区域导致导数消失,严重影响敏感性指数的计算精度。
6、
技术实现思路
1、本发明提供一种基于大语言模型驱动的自动化不确定性量化分析方法及系统,其目的在于,解决现有不确定性量化工具需人工提取论文参数、代理模型存在方差压缩、sobol 估计存在偏置、llm 生成代码适配差的缺陷,依托大语言模型实现从文本、工程数据到完整uq分析的端到端自动化,以提升分析精度与效率。
2、本发明是通过以下技术方案实现的:
3、一种基于大语言模型驱动的自动化不确定性量化分析方法,具体包括以下步骤:
4、步骤s1、文档解析与信息提取:接收论文markdown文件或csv工程数据文件,通过大语言模型从论文文本中提取不确定设计参数及其数值范围、目标性能指标及其数值阈值,并从论文中提取已有的灵敏度分析数据和可靠度数据,对提取的参数符号执行希腊字母到拉丁字母的映射和大小写统一化归一处理;
5、步骤s2、基线建立:通过大语言模型从论文表格中提取每个设计参数的名义值和每个目标性能指标的基线性能值,其中名义值必须从论文表格中直接提取;
6、步骤s3、边界定义与分布推荐:通过大语言模型为每个设计参数推荐概率分布类型,根据参数物理分类执行预设的映射规则,并为每个参数标注随机不确定性或认知不确定性类型,同时为每个目标性能指标根据其阈值和方向建立极限状态函数;
7、步骤s4、uq方法选择:通过大语言模型根据参数维度自动选择采样方法、敏感性分析方法、可靠度方法和样本量,按维度执行三路分支规则,其中参数数量d≤5时选择张量积pce结合高斯积分,5
8、步骤s5、方程提取与模型构建:根据论文是否包含显式控制方程,自动选择第一分支或第二分支构建可执行的代理模型;
9、所述第一分支:当论文包含参数到目标性能指标的控制方程时,提取论文中的显式控制方程,识别方程类型为闭式代数、多步链式、隐式求根、分段条件、耦合系统或积分微分中的一种,翻译为python数值代码,并强制执行sobol兼容编码规则;
10、所述第二分支:当论文仅提供定性趋势描述时,构建归一化加性多项式代理模型,其数学形式为qoi_k = σ_{i=1}^{n} w_i · f_i(x_{n,i}) + b_k,其中x_{n,i}为归一化到[0,1]区间的参数,f_i为根据论文定性描述映射的趋势函数,w_i为灵敏度权重,b_k为基线常数;
11、步骤s6、模型验证:对构建的代理模型执行名义值校验和k-fold交叉验证,生成模型质量评级;
12、步骤s7、敏感性分析与不确定性传播:使用拉丁超立方采样生成参数样本,在代理模型上执行不确定性传播,计算每个目标性能指标的均值、标准差和置信区间,并采用无偏saltelli sobol估计器计算全局敏感性指数;
13、步骤s8、可靠度分析:基于传播结果,通过一阶二次矩方法计算每个目标性能指标的失效概率和可靠度指标,采用串联模型计算系统可靠度,并筛选满足所有目标性能指标阈值的样本作为满意参数区间;
14、步骤s9、可视化:自动生成sobol敏感性柱状图、参数概率密度分布图、目标性能指标概率密度分布图、可靠度仪表盘和交叉验证结果图;
15、步骤s10、结论报告生成:通过大语言模型读取所有计算结果,生成包含执行摘要、关键发现、参数重要性排序、优化建议、价值分析和局限性分析的结构化分析结论报告。
16、作为优选实施例,所述步骤s1中还包括参数自校验步骤:通过第二次大语言模型调用,验证提取的每个参数和每个目标性能指标是否在论文的results、discussion和conclusion部分有支持证据,无证据的参数被移除,遗漏的参数被补充。
17、作为优选实施例,所述步骤s1中当输入为csv工程数据文件时,还包括以下子步骤:通过关键词匹配自动识别输入列和输出列,计算每列的均值、标准差、变异系数和分位数,分别拟合normal、uniform、lognormal三种分布并使用aic准则择优选择分布类型,根据参数数量自动选择代理模型构建方法,参数数量n≤10时使用多项式混沌展开ols拟合,参数数量n>10时使用高斯过程回归cholesky拟合,后续步骤s6至s10复用论文模式的完整流程。
18、作为优选实施例,所述步骤s3中所述概率分布类型的映射规则为:几何尺寸参数推荐normal或uniform分布,材料属性参数推荐normal或lognormal分布,比率/分数参数推荐uniform或beta分布,环境条件参数推荐uniform或normal分布,载荷参数推荐gumbel或weibull分布。
19、作为优选实施例,所述步骤s5中第二分支的归一化加性多项式代理模型,其趋势函数f_i根据论文定性描述映射为以下6种标准形式之一:正比函数f(x_n) = x_n、递减函数f(x_n) = 1 - x_n、饱和函数f(x_n) = √(x_n)、加速函数f(x_n) = e^{x_n} - 1、峰值函数f(x_n) = 1 - 4(x_n - 0.5)²、阈值函数f(x_n) = 1/(1 + e^{-10(x_n - 0.5)});权重w_i根据论文灵敏度结论分配:主导参数w_i ∈ [0.7, 1.0],显著参数w_i ∈ [0.3,0.7],低影响参数w_i ∈ [0.05, 0.25]。
20、作为优选实施例,所述步骤s5中第二分支构建归一化加性多项式代理模型后,执行校准循环:在名义设计点评估代理模型,若预测目标性能指标值与论文报告值的偏差超过20%,则通过大语言模型仅调整scale和baseline常数,不修改权重w_i或趋势函数f_i,最多重复3次迭代。
21、作为优选实施例,所述步骤s5中所述第一分支的sobol兼容编码规则包括:禁止使用np.clip函数产生平坦区域导致导数消失;禁止使用布尔索引赋值arr[mask] = value;禁止使用if/else对数组操作,必须使用np.where替代;必须使用np.exp、np.log、np.sqrt、np.power等平滑非线性函数;在分母中添加1e-10防止除零;model_func的接口规范为xshape (n, n) → return shape (n, m),其中n为样本数,n为参数数,m为目标性能指标数。
22、作为优选实施例,所述步骤s6中所述模型质量评级分为四个等级:reliable表示名义值偏差<20%且交叉验证r²>0.8,low_confidence表示名义值偏差<20%但r²≤0.8,unverified表示名义值偏差在20%至50%之间且为第二分支模型,unreliable表示名义值偏差≥50%且为第一分支模型。
23、作为优选实施例,所述步骤s7中所述无偏saltelli sobol估计器采用池化估计替代标准saltelli方法中的叉积项,具体为:使用f_bar = (1/2n) σ_{k=1}^{2n} f_k计算总均值,以f_bar²替代原方法中的mean(f_a)·mean(f_b),其中{f_k}_{k=1}^{2n}为两个独立样本矩阵f(a)和f(b)的拼接,将估计偏置从o(1/√n)降低至o(1/n),并将估计器方差减半;步骤s7中所述无偏saltelli sobol估计器重复计算5次,使用5个不同的随机种子,取中位数作为最终结果,以进一步降低蒙特卡洛噪声;样本量设置为max(5000, n × 2000),其中n为参数数量。
24、一种基于大语言模型驱动的自动化不确定性量化分析系统,用于执行所述的分析方法,包括输入模块、大语言模型驱动提取模块、数值计算模块、可视化模块、报告生成模块,
25、所述输入模块,用于接收论文markdown文件或csv工程数据文件;
26、所述大语言模型驱动提取模块,用于执行权利要求1所述步骤s1至s5,包括参数提取、自校验、基线建立、分布推荐、方法选择和双分支模型构建;
27、所述数值计算模块,包含内置算法库,用于执行权利要求1所述步骤s6至s8,包括模型验证、拉丁超立方采样、无偏saltelli sobol敏感性分析、不确定性传播和fosm可靠度计算;
28、所述可视化模块,用于执行权利要求1所述步骤s9,自动生成sobol敏感性柱状图、参数概率密度分布图、目标性能指标概率密度分布图、可靠度仪表盘和交叉验证结果图;
29、所述报告生成模块,用于执行权利要求1所述步骤s10,通过大语言模型生成结构化分析结论报告;
30、所述数值计算模块中的内置算法库包含9个模块共55种以上算法,涵盖采样方法、随机展开、敏感性分析、可靠度方法、高斯过程、预测模型、回归正则化、伴随方法和认知不确定性量化。
31、本发明的技术实现原理:本发明一种基于大语言模型驱动的自动化不确定性量化分析方法及系统,基于大语言模型构建端到端不确定性量化自动化分析框架,首先输入工程文本、实验数据等原始素材,经大语言模型完成文献参数自动提取,替代传统人工摘抄参数的工作。本发明通过模型调用多类不确定性量化工具组件,对输入数据开展代理模型构建,同时对代理模型输出进行方差压缩校正,消除模型输出偏差。针对sobol指数估计存在固有偏置的问题,集成偏置消除计算模块,修正敏感性指数计算结果。大语言模型依据任务需求自动生成可运行的uq分析代码,完成数据预处理、代理模型训练、敏感性分析、不确定性传播全流程运算,规避传统代码适配性差、调试繁琐问题。框架自动解析运算结果,输出可视化图表与量化报告,完整复现不确定性量化全流程。整个流程无需科研人员手动编写代码、手动提取文献参数,实现从原始输入到分析报告的全自动输出,提升工程不确定性量化的计算精度与工作效率。
32、与现有技术相比,本发明具有以下有益效果:
33、(1)实现了uq分析全流程的端到端自动化,将单篇论文的uq分析时间从数小时缩短至8-10分钟,且无需人工干预。参数提取准确率通过llm自校验机制保障,可重复性通过权重标准化和校准循环实现。
34、(2)双分支架构使系统可处理任意论文,无论是否有显式方程。branch a覆盖约40%的论文(有显式方程),branch b覆盖约60%的论文(仅有定性趋势),总覆盖率达到100%。
35、(3)归一化加性代理模型从根本上避免了加权平均公式的方差压缩问题,使低权重参数在sobol分解中保持可见性,正确区分重要参数和不重要参数,即使参数权重跨多个数量级。
36、(4)无偏saltelli sobol估计器通过池化估计替代叉积项,将偏置从 o(1/√n)降低至 o(1/n),在超过94%的参数-qoi对中满足 s_i ≤ st_i 的数学约束,提高了敏感性分析结果的可信度。
37、(5)sobol兼容编码规则确保了llm生成的python代码可直接用于sobol敏感性分析,避免了因代码实现问题导致的敏感性指数计算错误。
38、(6)csv双模式支持工程数据直接导入,aic分布拟合和pce/gp自动选择使非论文来源的数据也可进行完整的uq分析。
39、(7)通过40次稳定性测试验证(20次×2篇论文),参数符号一致性在归一化后达到100%,模型质量评级为reliable的比例达到88.9%-100%,图表生成成功率达到100%,关键参数排序集一致性达到100%。
40、
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com