
一种流式输出内容的渲染速率调节方法及系统与流程
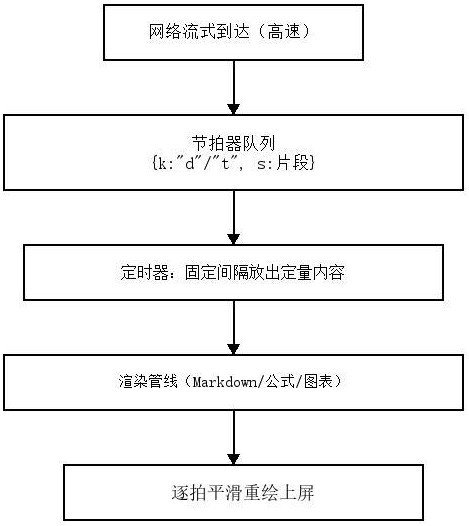
本发明涉及人工智能人机交互,具体涉及一种在人工智能流式生成内容时,根据用户配置的速率上限对内容显示进行匀速节拍控制,并结合平滑重绘和跟随滚动锚定,以降低学习者认知负荷的渲染控制方法及系统。
背景技术:
1、3.1 现有技术的技术方案
2、当前主流 ai 对话产品(chatgpt、claude、gemini、khanmigo 等)的流式输出渲染方式为:内容到达即显示——服务器推送一个 token/字符块,客户端立即渲染上屏,显示速度等同于网络传输速度。
3、对于本地部署的大模型(如 llama.cpp),生成速度约 10~40 tokens/秒,显示节奏与人类阅读速度接近。但对于云端大模型(如 deepseek、gpt-4、kimi),生成速度可达100~300 tokens/秒,远超人类阅读速度(中文约 5~10 字/秒)。
4、3.2 现有技术的缺陷
5、1. 认知过载:云端模型瞬间输出大段文字(几百字在 1~2 秒内全部显示),学习者来不及阅读,产生"文字刷屏"的心理压迫感,导致放弃跟读;
6、2. 学习效果下降:认知心理学研究表明,当信息呈现速率超过学习者的加工速率时,工作记忆超载,长期记忆编码效率显著下降;
7、3. 增量内容与富文本渲染管线的冲突:流式内容以不完整片段持续到达。常见实现将增量片段直接交由通用 markdown 管线渲染——数学公式的反斜杠结构(如 \frac、\left)易被 markdown 转义规则破坏;图表若在数据不完整或渲染动画进行中反复重绘与取帧,易出现空图、错乱或多图并发渲染互相干扰;
8、4. 缺乏面向 ai 流式生成的显示速率控制:现有 ai 对话产品(本发明人所知范围内)均未提供针对流式生成内容的显示速率上限调节。
9、3.3 最接近的现有技术
10、(a)打字机效果脚本/库(typed.js 等):对已完整存在的文本按固定时间间隔逐字显示。其与本案的区别在于:作用对象是静态既有文本而非网络流式到达、生成与显示并发进行的内容;不存在"网络到达速率与显示速率解耦"的问题(文本无到达速率);无速率上限配置、无生成中途变速、无数据完整性保护(不存在未到达内容的丢失问题)、无与跟随滚动及图表渲染的协同。
11、(b)流媒体播放器的缓冲-恒速播放模型:视频播放器将网络到达的数据缓存后按恒定帧率播放,用户可调播放倍速。其与本案的区别在于:作用对象为连续媒体流(音视频帧),按时间轴解码渲染;本案对象为离散文本增量,需经富文本渲染管线(markdown/公式/图表)逐拍重绘,且需处理增量解析、公式状态、图表中间态等文本渲染特有的技术问题;播放器的倍速调节改变的是媒体时间轴,而非"显示速率上限对到达速率的解耦钳制"。
12、(c)语音合成/字幕的速率控制:调节的是合成或播放速度,不涉及流式生成内容的渲染管线节拍控制。
13、以上现有技术均未解决"ai 流式生成内容以超过人类阅读速度到达时,如何按用户可配的速率上限匀速渲染、且与富文本渲染管线协同"的问题。
技术实现思路
1、4.1 发明目的
2、提供一种在人工智能流式生成内容时,将内容到达速度与内容显示速度解耦的方法——网络可以飞快传输,但显示按用户设定的速率匀速放出,配合逐字符平滑重绘和智能跟随滚动,为学习者创造"行云流水"的阅读节奏,降低认知负荷。
3、4.2 技术方案
4、4.2.1 系统架构
5、(a)双通道节拍器模块
6、设置一个统一的内容放出队列,接收来自两个通道的流式数据:
7、正文通道(delta):ai 生成的主要回答内容;
8、思考通道(reasoning):推理模型的中间思考过程。
9、两条通道的内容以「通道标识(正文或思考)+ 文本片段」的二元组格式进入队列,由同一个定时器(每 50ms 触发一次)按配置速率匀速放出:
10、rate = 用户配置的字/秒(如 42);每秒 20 拍,每拍放出字符数 = 显示速率除以 20,四舍五入且至少为 1
11、(b)动态速率调节模块
12、每拍动态读取当前配置:
13、用户在设置中修改速率后,下一拍立即生效(无需等待当前回答完成);
14、用户切换到"不限速"模式时,队列中剩余内容立即全部放出。
15、(c)平滑重绘模块
16、与节拍器协同工作:
17、限速激活时:重绘间隔从 260ms 降至 50ms(与节拍器同步),每拍仅新增 2~3 个字符,实现逐字符流出的视觉效果;
18、不限速时:保持 260ms 聚合绘制,减少 dom 操作。
19、(d)跟随滚动锚定模块
20、确保生成内容始终在用户视野内:
21、以"生成头"(最新增长的内容块)为锚点,每拍调整滚动位置使其保持在视口下方;
22、脱离跟随仅识别真实用户输入(滚轮、触摸滑动、翻页键),而非程序性滚动或浏览器锚定事件;
23、用户滚动回生成头附近时自动恢复跟随。
24、(e)页面卸载冲刷模块
25、当用户刷新或关闭页面时:
26、立即将队列中所有未放出的内容同步冲刷到文档中;
27、触发保存操作,确保内容不因限速回放未完成而丢失。
28、(f)图表渲染协调模块
29、2d 图表(canvas 2d):关闭动画 → 同步完成绘制 → 立即截取静态图 → 替换为静态图;
30、3d 图表(webgl):显示"生成中"提示 → 延迟 300ms 等待 gpu 首帧 → 双requestanimationframe 确认渲染完成 → 截取静态图;
31、段落定稿后将静态图替换为可交互实例(悬停提示、缩放旋转)。
32、4.2.2 方法流程
33、步骤 t1:ai 开始流式生成,网络内容高速到达客户端
34、步骤 t2:客户端接收内容并放入节拍器队列(而非直接渲染)
35、步骤 t3:节拍器每 50ms 从队列中取出 rate/20 个字符,送入渲染管线
36、步骤 t4:渲染管线以 50ms 间隔逐拍重绘(平滑逐字流出效果)
37、步骤 t5:跟随滚动模块每拍调整滚动位置,保持生成头在视野内
38、步骤 t6:图表在围栏闭合时触发渲染(2d 立即、3d 延迟)
39、步骤 t7:用户中途调速 → 下一拍生效
40、步骤 t8:生成完成但队列未空 → 等待队列排空再收尾
41、步骤 t9:页面卸载 → 冲刷队列 + 保存数据
42、4.2.3 关键技术特征
43、特征 1:网络速率与显示速率的解耦
44、流式内容从网络到达后不直接渲染,而是进入节拍器队列按配置速率匀速放出。这是本发明的核心创新——将"网络传输速率"与"内容显示速率"作为两个独立变量,允许显示速率远低于网络速率。
45、特征 2:多通道的节拍控制(含思考通道的折叠与倍速围观)
46、正文(delta)与推理模型的思考内容(reasoning)均纳入节拍器体系统一节拍控制,具体实施方式包括两个层级:
47、实施方式一(统一预算):两通道内容以「通道标识+文本片段」的二元组进入同一队列,共享同一速率预算,思考先匀速流出、正文接续,整体节奏一致;
48、实施方式二(按通道独立预算,优选):正文与思考分别计预算——思考通道的放出速率为正文速率的倍数(倍率可配置,如 2.5 倍,倍率为 0 表示思考不限速;倍率可由服务端按当前服务的模型随流通告,切换模型即自动生效),避免长思考模型拖慢正文节奏。
49、在实施方式二的基础上,思考通道还具有折叠态零渲染特征:思考内容默认折叠,不进入渲染管线(仅累计计数并以脉冲指示提示"思考进行中",无限速、零渲染等待);当用户手动展开围观时,已到达的思考一次性铺出,此后新到达的思考转入节拍器按倍速节拍放出;正文开始后思考块定格为可回看状态。该特征消除了不同模型思考长度差异(数百字至数万字)导致的体验不可拉平问题。
50、特征 3:中途变速的即时生效
51、每拍动态读取配置(而非在生成开始时锁定),用户在生成过程中修改速率后,当前正在流出的内容也立即变速,无需等待下一轮生成。
52、特征 4:页面卸载时的数据完整性保护
53、当用户在限速回放未完成时刷新页面,系统在 beforeunload 和visibilitychange 事件中同步冲刷队列,确保已到达但未显示的内容不会丢失。
54、4.3 有益效果
55、1. 认知负荷可控:学习者可以将显示速率调节到与自身阅读速度匹配的水平(如42 字/秒),避免文字刷屏导致的认知过载;
56、2. 学习体验提升:逐字符匀速流出的"打字机"效果创造了"行云流水"的阅读节奏,被用户评价为"眼睛的享受";
57、3. 公式与图表的流式安全渲染:公式片段先于 markdown 管线摘出、围栏闭合后整块渲染(源码态到成品态一次转换,反斜杠结构不被破坏);图表流式期间以静态图呈现、段落定稿后替换为可交互实例,避免并发渲染冲突;
58、4. 数据完整性保障:即使在限速回放过程中刷新页面,已接收的内容也不会丢失;
59、5. 个性化:不同用户(如老人、儿童、专业人士)可以设置不同的显示速率。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com