
一种承载水资源模型的云容器负载预测方法与流程
本发明属于云计算资源调度,具体涉及一种承载水资源模型的云容器负载预测方法。
背景技术:
1、随着云计算、边缘计算及智能物联网等新型计算范式的快速发展,动态负载预测已成为实现资源弹性调度、保障服务质量及优化能效比的核心技术基础。
2、在承载水资源模型等复杂科学计算应用的云容器环境中,负载波动呈现出非线性、非平稳、多尺度耦合等复杂动力学特征。这类模型在进行大规模水文模拟、洪水预报或水资源优化调度时,其计算任务具有突发性、阶段性强依赖性和长时间尺度依赖等特点,导致容器工作负载表现出显著的突变、趋势漂移及多时间尺度混杂。这种复杂的负载特性,对预测模型的准确性和鲁棒性构成了严峻挑战。
3、传统的负载预测方法主要分为两类:一类是基于统计模型的方法,如arima(autoregressive integrated moving average,自回归移动平均模型)、svr(supportvector regression,支持向量回归)等,这类方法假设时间序列具有线性或平稳特性,难以有效处理实际生产环境中的突发性负载变化和长周期趋势;另一类是基于单一循环神经网络的方法,如rnn、lstm等,虽然能够捕捉时序依赖关系,但在面对高频噪声、模态混叠以及多尺度特征耦合时,预测误差容易累积,导致模型性能下降。
4、现有研究表明,通过信号分解技术,如emd(empirical mode decomposition,经验模态分解)、eemd、vmd(variational mode decomposition,变分模态分解)等,将原始负载序列解耦为多个imf分量,再对各分量分别建模预测,可有效提升预测精度。然而,传统分解方法仍存在以下不足:
5、(1)emd易出现模态混叠现象,导致分解后分量的物理意义模糊;
6、(2)eemd虽引入噪声辅助,但其关键参数,如噪声幅值、集成次数、最大imf数,依赖人工经验设定,难以自适应不同负载特性;
7、(3)现有分解-预测框架多采用单一网络结构对分量建模,忽略了不同频段分量的时序模式差异,且未能充分融合多尺度特征,限制了预测性能的进一步提升。
8、因此,本发明提供一种能够自适应分解负载信号、并针对多尺度特征进行差异化建模的负载预测方法,以解决现有技术中预测精度低、鲁棒性差的问题。
技术实现思路
1、本发明旨在克服现有技术的不足,提供一种承载水资源模型的云容器负载预测方法,解决传统方法在非平稳、多尺度负载数据上预测精度低、参数依赖人工经验、模态混叠等问题。
2、为实现上述目的,本发明提供如下技术方案:
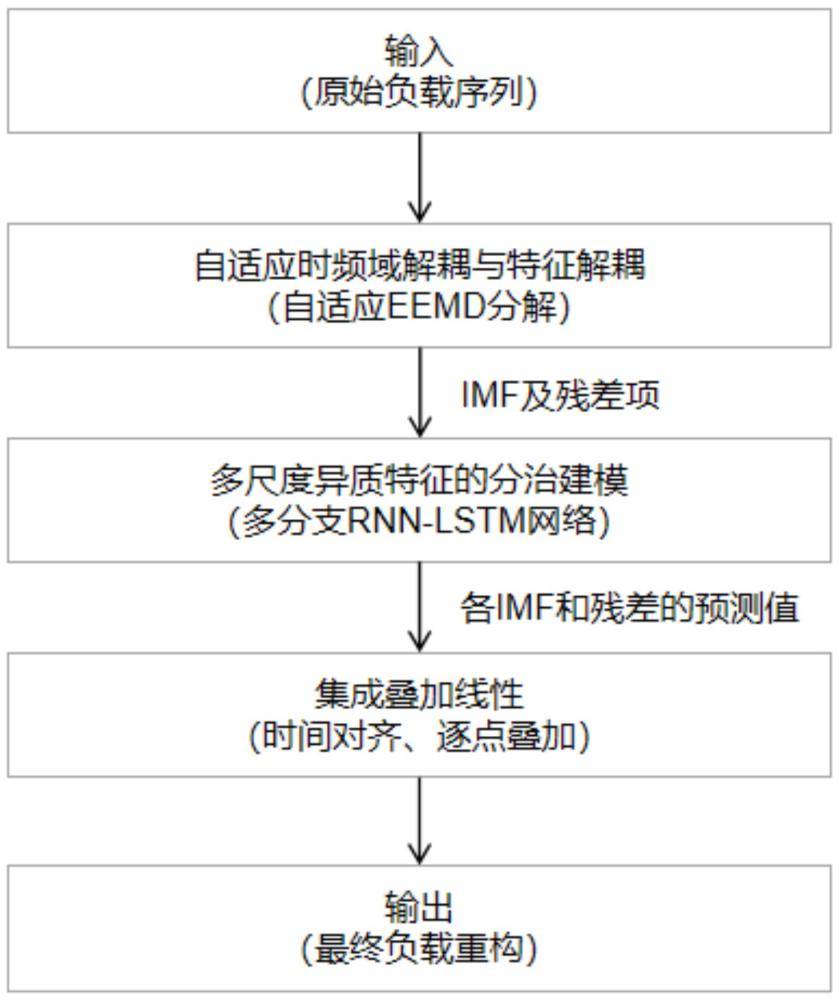
3、一种承载水资源模型的云容器负载预测方法,获取历史负载时序数据,构建输入序列;采用贝叶斯优化算法对eemd的参数进行自适应优化,所述eemd是一种通过多次添加白噪声辅助的经验模态分解方法;将原始负载序列分解为若干imf分量及残差项,所述imf表征序列在不同时间尺度上的本征振荡模式;构建多尺度rnn-lstm混合预测网络,对各imf分量和残差项分别进行时序建模,得到各分量的预测值;将各分量的预测结果进行线性叠加,重构得到最终负载预测值。
4、具体的包括以下步骤:
5、步骤1:数据获取与预处理;
6、从云容器监控平台采集历史负载数据,包括cpu利用率、内存使用率、网络传输吞吐量等指标;设历史时间窗口长度为l,当前时刻为t,构建输入序列,其中每个时间步包含待预测的目标变量;将数据集按时间顺序划分为训练集、验证集和测试集,并进行归一化处理;
7、步骤2:基于贝叶斯优化的eemd分解;
8、对训练集中的原始负载序列进行bo-eemd分解;
9、bo-eemd分解具体包括以下子步骤:
10、(1)以时间序列形式输入负载数据,作为后续分解与预测的基础输入。
11、(2)设定eemd相关参数的优化搜索范围,并初始化贝叶斯优化算法的超参数,包括最大迭代次数、收敛容忍度、超时阈值。
12、(3)对负载数据执行eemd分解,得到若干imf和残余项;同时计算各imf的包络熵,用于衡量分解质量,并记录当前迭代的适应度。
13、(4)检查是否达到预设的终止条件,若满足,则终止优化过程;否则,进入下一轮迭代。
14、(5)保存目前迭代过后的最优参数和最小适应度。
15、(6)使用第(5)步获得的最优参数,对原始负载信号重新执行eemd分解。
16、(7)针对每个imf分量分别构建独立的rnn-lstm预测单元,捕捉不同时间尺度的波动特征。
17、(8)将所有分量的预测结果按线性叠加原理重构,结合残差项修正,最终输出高精度的负载预测值。
18、步骤3:构建多尺度rnn-lstm预测网络;
19、针对每个imf分量和残差项,分别构建相同结构的多尺度rnn-lstm网络进行预测。多尺度时序预测模型结构包括高分辨率分支、低分辨率分支和特征融合层。
20、高分辨率分支:输入原始时间步序列,经过一个rnn层,再接一个lstm层,分别设置单元数与激活函数,输出得到细粒度特征;
21、低分辨率分支:对输入序列进行平均池化降采样,然后依次经过rnn层和lstm层,输出粗粒度特征。
22、特征融合层:将双分支输出在特征维度上拼接,输入到一个全连接层。
23、全连接层:最后通过线性叠加融合各imf预测结果,输出该分量的预测值。
24、所有分支共享相同的网络参数,采用统一的训练策略。高分辨率分支,用rnn-lstm提取细粒度特征,保留瞬时细节;低分辨率分支,通过池化压缩时间维度,再用rnn-lstm提取粗粒度特征,抑制噪声干扰。将不同分支的输出在特征融合层合并,使模型能联合优化短期与长期信息基于多尺度时序预测模型。
25、步骤4:模型训练与预测;
26、将每个分量的历史序列作为输入,未来负载值作为输出,构建训练样本。采用adam优化器,配置初始学习率、批大小、epoch,以mse作为损失函数,并在验证集上监控早停。训练完成后,对测试集进行预测,得到各分量的预测值。
27、步骤5:重构最终预测结果;
28、将所有分量的预测值按照时间对齐后逐点线性叠加,得到最终负载预测值。
29、还包括步骤6:多步预测扩展;
30、对于需要预测未来多个时间步的场景,采用递归或多输出策略。实例设置超前预测步数,直接输出对应步长的预测序列。训练时,将输出维度设置为预测步长,损失函数计算各步误差的平均值。
31、一种承载水资源模型的云容器负载预测方法,包括以下步骤:
32、进一步的,步骤(2)中所述贝叶斯优化算法采用改进的tpe(tree-structuredparzen estimator,树结构parzen估计器)作为代理模型,并通过ei(expectedimprovement,期望改进)采集函数指导离散参数空间的搜索;待优化参数包括噪声幅值、集成次数和最大imf数量。
33、进一步的,步骤(2)中所述eemd通过多次添加高斯白噪声并对分解结果进行集成平均,缓解模态混叠现象;具体步骤包括:对原始信号添加多组高斯白噪声,生成含噪信号集合;对每个含噪信号进行独立emd分解,得到各自的imf集合;对所有分解结果按imf阶数进行对齐并取平均,得到最终的imf分量和残差项。
34、进一步的,所述方法支持多步预测任务,通过设置预测步长,输出未来多个时间点的负载值;在训练过程中采用自适应矩估计优化器,结合均方误差损失函数进行端到端训练,并通过早停机制防止过拟合。
35、进一步的,所述方法应用于承载水资源模型的云容器资源调度场景中,通过预测负载趋势指导容器的弹性扩缩容操作。
36、与现有技术相比,本发明具有以下有益效果:
37、(1)通过贝叶斯优化驱动的eemd参数自适应机制,实现了对负载信号的高质量分解,有效抑制了模态混叠,保证了imf分量的物理意义和稳定性;
38、(2)构建了多尺度rnn-lstm混合预测网络,通过双分支结构同时捕捉负载的短期波动和长期趋势,实现了对不同频段分量的差异化建模,提升了模型对复杂时序模式的拟合能力;
39、(3)采用“分解-分治-集成”的预测框架,各分量独立优化后线性重构,避免了传统端到端模型中不同频率信号相互干扰的问题,显著提高了预测精度和鲁棒性;
40、(4)在公开数据集上的实验表明,本发明的预测精度指标,包括mae(meanabsolute error,平均绝对误差)、rmse(root mean squared error,均方根误差)、r²(coefficient of determination,决定系数)、ia(index of agreement,一致性指数),均优于现有主流方法,尤其在多步预测任务中表现出更强的抗误差累积能力,适用于承载水资源模型等复杂应用的云容器动态调度场景。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com