
一种基于康巴藏语方言的端到端气象播报数字人生成方法与流程
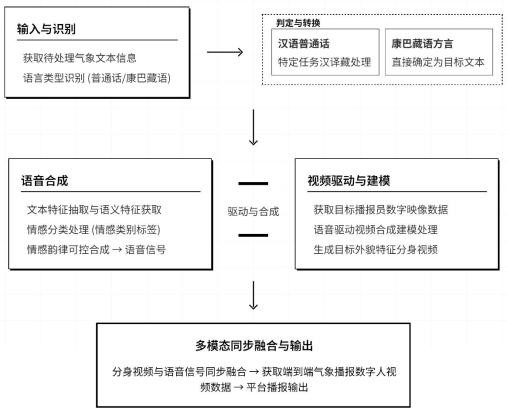
本发明涉及人工智能与自然语言处理,尤其涉及一种基于康巴藏语方言的端到端气象播报数字人生成方法。
背景技术:
1、随着人工智能与多媒体技术的快速发展,数字人技术在气象播报、新闻主持、客户服务等领域得到了广泛应用。数字人能够通过语音合成、面部动画生成及多模态融合等技术,实现逼真的人物形象与自然的交互表达,有效提升了信息传播的生动性与用户体验。特别是在公共信息服务领域,数字人播报不仅可降低人力成本,还能实现24小时不间断服务,成为智慧政务与智能媒体建设的重要组成部分。
2、当前主流数字人系统主要面向汉语普通话或英语等资源丰富的语种设计,针对康巴藏语等低资源方言的支持极为有限,导致少数民族地区难以获得高质量、本地化的智能播报服务,制约了气象信息在民族地区的有效覆盖与精准传达。
3、在语音合成技术方面,现有技术已尝试引入情感或风格控制以提升合成语音的表现力。例如,中国专利cn113539236b公开了一种语音合成方法和装置,其通过风格生成模块从输入文本中提取风格特征表示,并结合音色标记与目标语音合成模型,实现半监督条件下可自定义风格的情感语音合成,使合成语音的风格适用于语料库中的所有音色。该方法虽在一定程度上实现了情感风格的灵活控制,但其依赖于已有语料库中的音色资源及风格标注数据,且未涉及跨语种文本转换、低资源方言适配以及语音驱动数字人视频生成等环节,难以直接应用于康巴藏语这类语料稀缺、缺乏标准化情感标注的方言场景。
4、因此,如何在语料匮乏条件下实现汉语普通话到康巴藏语方言的准确转换,并在端到端框架下融合情感韵律控制与语音驱动视频生成,以产出自然流畅、情感适配、音画同步的康巴藏语气象播报数字人视频,是当前亟待解决的技术问题。
技术实现思路
1、本发明的目的在于克服现有技术的不足,以解决现有技术在康巴藏语等低资源方言语料匮乏条件下,难以实现跨语种文本自动适配的问题,提供一种基于康巴藏语方言的端到端气象播报数字人生成方法。
2、本发明的目的是通过以下技术方案来实现的:
3、一种基于康巴藏语方言的端到端气象播报数字人生成方法,包括:
4、获取待处理气象文本信息,对待处理气象文本信息进行语言类型识别,获取语言类型识别结果,语言类型识别结果用于指示待处理气象文本信息的语种为汉语普通话或康巴藏语方言;
5、当语言类型识别结果指示待处理气象文本信息为汉语普通话时,对待处理气象文本信息进行特定任务汉语翻译藏语处理,获取康巴藏语方言气象文本信息;当语言类型识别结果指示待处理气象文本信息为康巴藏语方言时,将待处理气象文本信息确定为康巴藏语方言气象文本信息;
6、对康巴藏语方言气象文本信息进行文本特征抽取,获取文本语义特征,并对文本语义特征进行情感分类处理,获取情感类别标签;基于情感类别标签,通过情感韵律可控语音合成模型对康巴藏语方言气象文本信息进行端到端语音合成处理,获取康巴藏语方言语音信号;
7、获取目标播报人员的数字映像数据,基于康巴藏语方言语音信号驱动数字映像数据进行语音驱动视频合成建模处理,生成具有目标播报人员外貌特征的气象播报数字人分身视频;将气象播报数字人分身视频与康巴藏语方言语音信号进行多模态同步融合处理,获取端到端气象播报数字人视频数据,端到端气象播报数字人视频数据用于在气象信息发布平台进行播报输出。
8、作为优选方式,在获取待处理气象文本信息之后,还包括:对所述待处理气象文本信息进行气象数据格式校验,获取气象数据格式校验结果;
9、所述对所述待处理气象文本信息进行语言类型识别,获取语言类型识别结果,包括:当所述气象数据格式校验结果指示所述待处理气象文本信息符合预设气象数据格式时,对所述待处理气象文本信息进行语言类型识别,获取语言类型识别结果。
10、作为优选方式,对所述待处理气象文本信息进行特定任务汉语翻译藏语处理,获取康巴藏语方言气象文本信息,包括:
11、基于预设天气预报汉藏专业术语库,对所述待处理气象文本信息进行术语匹配处理,获取术语匹配结果;基于所述术语匹配结果,通过基于大语言模型辅助翻译的特定任务汉语翻译藏语模型对所述待处理气象文本信息进行翻译处理,获取康巴藏语方言气象文本信息;其中,所述预设天气预报汉藏专业术语库基于专业藏文词汇库中的天气预报相关术语构建得到;
12、或者,基于预设天气预报汉藏专业术语库,对所述待处理气象文本信息进行术语匹配处理,获取术语匹配结果;基于所述术语匹配结果,通过端到端特定任务汉语翻译藏语模型对所述待处理气象文本信息进行翻译处理,获取康巴藏语方言气象文本信息。
13、作为优选方式,情感类别标签通过以下方式获取:采用循环神经网络与长短期记忆网络相结合的情感特征提取模型,对所述文本语义特征进行情感特征提取,获取情感特征向量;通过全连接层对所述情感特征向量进行分类处理,获取所述情感类别标签,所述情感类别标签包括喜悦、悲伤、愤怒、惊讶、恐惧和平静中的至少一种;
14、所述情感韵律可控语音合成模型通过以下方式对所述康巴藏语方言气象文本信息进行端到端语音合成处理:
15、基于所述情感类别标签,通过多层感知器模型将所述情感类别标签映射为声学特征向量;所述声学特征向量至少包括基频特征、语速特征、音量特征和音色特征;
16、基于所述情感类别标签和所述声学特征向量,通过端到端语音合成模型对所述康巴藏语方言气象文本信息进行声学特征预测处理,获取目标声学特征;通过神经声码器对所述目标声学特征进行波形合成处理,获取康巴藏语方言语音信号。
17、作为优选方式,通过多层感知器模型将所述情感类别标签映射为声学特征向量之前,还包括:
18、基于所述情感类别标签,从事先设置的各情感类别基频模板库中获取与所述情感类别标签相匹配的目标基频模板;基于所述康巴藏语方言气象文本信息的文本内容和情感强度,对所述目标基频模板进行微调处理,获取基频曲线参数;
19、基于所述情感类别标签,从事先设置的各情感类别语速缩放因子库中获取与所述情感类别标签相匹配的目标语速缩放因子;基于所述目标语速缩放因子对原始语音时长进行调整,获取语速参数;
20、所述通过多层感知器模型将所述情感类别标签映射为声学特征向量,包括:将所述情感类别标签、所述基频曲线参数和所述语速参数共同输入所述多层感知器模型,获取所述声学特征向量;
21、其中,所述基频曲线参数的计算公式为:
22、
23、其中,为所述基频曲线参数在时刻的基频值;为预先定义的与情感类别对应的基频模板在时刻的基频值;为依据情感类别和文本内容确定的基频调整量;
24、所述语速参数的计算公式为:
25、
26、其中,为调整后的语音时长;为原始语音时长;为与情感类别相关的时长缩放因子。
27、作为优选方式,基于所述康巴藏语方言语音信号驱动所述数字映像数据进行语音驱动视频合成建模处理,生成具有目标播报人员外貌特征的气象播报数字人分身视频,包括:
28、对所述数字映像数据进行面部特征提取处理,获取目标播报人员的面部特征参数;
29、基于所述康巴藏语方言语音信号,通过端到端语音驱动数字分身模型进行口型同步与面部表情驱动处理,获取驱动后的面部运动参数;
30、基于所述面部特征参数和所述面部运动参数,通过面部增强算法进行高清合成处理,获取气象播报数字人分身视频。
31、作为优选方式,将所述气象播报数字人分身视频与所述康巴藏语方言语音信号进行多模态同步融合处理,获取端到端气象播报数字人视频数据,包括:
32、获取所述气象播报数字人分身视频的视频时间戳信息和所述康巴藏语方言语音信号的音频时间戳信息;
33、基于所述视频时间戳信息和所述音频时间戳信息,对所述气象播报数字人分身视频与所述康巴藏语方言语音信号进行时间轴对齐处理,获取对齐后的视频数据和音频数据;
34、将所述对齐后的视频数据和音频数据进行多模态融合编码处理,获取端到端气象播报数字人视频数据。
35、作为优选方式,情感韵律可控语音合成模型包括文本编码器、声学解码器、波形生成器、说话人和语言编码器以及说话人分类器;
36、所述说话人和语言编码器,用于从说话人嵌入向量和语言嵌入向量中提取对应的特征参数;
37、所述说话人分类器,设置于所述文本编码器的输出端,用于分离文本表示中存在的说话人信息,其内部结构包括:梯度反转层,用于在反向传播时对输入特征进行梯度反转,迫使所述文本编码器生成与说话人无关的特征;不少于两层堆叠的双向长短时记忆网络,用于对输入序列进行时序建模,捕获长期上下文依赖;全连接层,用于将所述双向长短时记忆网络的输出映射到说话人概率分布空间;
38、所述基于所述情感类别标签,通过情感韵律可控语音合成模型对所述康巴藏语方言气象文本信息进行端到端语音合成处理,获取康巴藏语方言语音信号,包括:
39、对所述康巴藏语方言气象文本信息进行藏文构件转写处理,获取藏文构件序列,将所述藏文构件序列输入文本编码器,获取康巴藏语方言音素序列;将所述康巴藏语方言音素序列和第一语言标识输入所述文本编码器,获取文本隐藏表示;
40、将所述文本隐藏表示输入所述说话人分类器,获取与说话人无关的更新文本隐藏表示;
41、基于所述更新文本隐藏表示、第一说话人标识和所述第一语言标识,通过所述说话人和语言编码器获取第一说话人特征参数和第一语言特征参数;
42、依据所述第一说话人特征参数和所述第一语言特征参数,对所述声学解码器中的隐藏特征进行条件层归一化处理,获取声学特征;
43、将所述声学特征输入所述波形生成器,获取所述康巴藏语方言语音信号。
44、作为优选方式,依据所述第一说话人特征参数和所述第一语言特征参数,对所述声学解码器中的隐藏特征进行条件层归一化处理,包括:
45、对所述声学解码器中的第层隐藏特征进行标准化处理,获取标准化向量;
46、以所述第一说话人特征参数中的缩放因子和偏移量作为第一条件参数,对所述标准化向量进行说话人条件层归一化,获取第一归一化结果;
47、以所述第一语言特征参数中的缩放因子和偏移量作为第二条件参数,对所述标准化向量进行语言条件层归一化,获取第二归一化结果;
48、将所述第一归一化结果和所述第二归一化结果相加,获取所述条件层归一化处理的输出向量;其中,所述输出向量的计算公式为:
49、
50、其中,为所述条件层归一化处理的输出向量;为对所述声学解码器中第层的输入隐藏特征向量进行标准化处理后获取的标准化向量;和分别为第层对应的第一说话人特征参数的缩放因子和偏移量;和分别为第层对应的第一语言特征参数的缩放因子和偏移量。
51、作为优选方式,端到端语音合成模型的训练过程采用循环迭代方式,基于标准合成性能的各配置范例语音数据,对未经配置的端到端语音合成模型进行配置,直到迭代配置终止,获取配置完毕的端到端语音合成模型;
52、其中,每次迭代配置产生的总损失函数包括:
53、
54、其中,为所述总损失函数;为梅尔谱重构损失;为基频预测损失;为能量预测损失;为时长预测损失;为余弦相似度损失,用于促使说话人向量与语言向量正交;为交叉熵损失,用于优化所述说话人分类器;为说话人正则化损失,用于约束随机持续时间预测器中的隐藏说话人表示;
55、所述余弦相似度损失的计算公式为:
56、
57、其中,为所述余弦相似度损失,取值范围为[0,1],最小化该损失可促使说话人嵌入向量与语言嵌入向量趋于正交;为说话人嵌入向量;为语言嵌入向量;表示两个向量的点积运算;和分别为两个向量的欧几里得范数;所述说话人正则化损失的计算公式为:
58、
59、其中,为所述说话人正则化损失;为预设的调节权重系数;表示基于自然对数的kl散度计算;为后验编码器基于hubert语音表示输出的后验概率分布;为随机持续时间预测器中预设的先验概率分布;为隐藏变量;依据所述总损失函数,依次对模型中的各个性能单元进行更新。
60、本发明至少具有以下有益效果:本发明通过语言类型识别与汉藏翻译,实现了汉语普通话与康巴藏语方言气象文本的自动适配,有效解决了康巴藏语气象播报语料匮乏及跨语种转换难题;同时结合情感分类与情感韵律可控语音合成模型,使生成的康巴藏语语音不仅准确传达气象信息,还能根据内容自适应匹配恰当的情感韵律,显著提升了语音播报的自然度与感染力;进一步利用目标播报人员数字映像数据进行语音驱动视频合成及多模态同步融合,生成了外貌逼真、音画同步的气象播报数字人分身视频,实现了从文本到视听一体化数字人播报的端到端自动化生成,大幅降低了康巴藏语气象播报的人力成本,提高了少数民族地区气象信息传播的效率与亲和力。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com