
一种基于多源异构数据融合的学术期刊智能推荐方法及系统与流程
本发明涉及学术信息处理,尤其涉及一种基于多源异构数据融合的学术期刊智能推荐方法及系统。
背景技术:
1、随着学术出版规模的持续增长,全球学术期刊数量已超过数万种。科研人员完成论文撰写后,需要在众多期刊中选择合适的期刊进行投稿。选刊过程涉及论文主题匹配度、影响因子、审稿周期、oa费用、录用率等多个维度的考量。传统手动选刊方式效率低下,科研人员往往需要花费大量时间查阅期刊信息。
2、目前市场上已存在多种期刊推荐工具,主要包括:基于单一出版商数据库的文本匹配工具(如elsevier journal finder、springer journal suggester、jane等),基于期刊数据库的查询筛选平台(如letpub、科研通等),以及基于协同过滤或知识图谱的学术推荐系统。
3、现有技术存在以下共性问题:数据源单一:现有工具均基于单一数据源(论文文本、历史统计数据或单一api),无一涉及多源异构学术数据源的融合,无法全面覆盖全球主要学术期刊;匹配维度有限:现有技术主要依赖文本相似度或机器学习模型的特征匹配,缺乏主题图谱匹配、共引网络分析、已发表论文证据等多维度匹配信号;缺乏反向推荐路径:现有技术均为"论文到期刊"的正向匹配,无"论文→相似论文→期刊"的反向召回路径,现有技术无法利用已发表相似论文的实际发表去向作为推荐依据;风险评估缺失:现有技术缺乏中国作者发文占比分级、oa类型标准化、预警期刊标记等多维度风险评估的系统化集成,在学术出版领域,单一国家作者占比过高已被学术界广泛认为是期刊质量风险的重要指标,根据美国国家科学基金会(nsf)发布的《science&engineering indicators》报告,中国学术论文产出约占全球总量的20-25%,当某一期刊的中国作者发文占比显著偏离这一全球平均水平时,该期刊可能存在稿源单一化、同行评审质量下降等风险,中国科学院文献情报中心及新锐学术发布的期刊预警名单也将作者来源集中度过高作为预警判定的重要参考指标之一,然而现有技术均未将此指标系统化地集成到期刊推荐流程中。
技术实现思路
1、本发明的目的在于提供一种基于多源异构数据融合的学术期刊智能推荐方法及系统,以解决现有技术中数据源单一、匹配维度有限、缺乏反向推荐路径和风险评估缺失的技术问题。
2、为实现上述目的,本发明提供一种基于多源异构数据融合的学术期刊智能推荐方法,包括以下步骤:
3、s1:接收用户的论文信息和偏好设置,其中论文信息包括论文标题、摘要和关键词,偏好设置包括期望影响因子范围、期望审稿周期和期望收录数据库;
4、s2:调用大语言模型api对论文文本进行特征提取,获得结构化论文特征,所述结构化论文特征包括关键词列表、主学科分类、副学科方向和研究类型;
5、s3:基于步骤s2获得的结构化论文特征,并行执行多源异构数据采集,调用多个学术开放数据源接口分别获取期刊元数据、论文统计数据和语义搜索结果,采用并行异步模式,任一数据源调用失败不阻塞其他数据源的调用;
6、s4:将各数据源返回的异构数据通过统一数据标准化模块转换为内部标准schema,实现字段映射和数据结构统一;
7、s5:并行执行双通道候选期刊召回,包括:
8、s5a:主题精确匹配通道,基于学科主题图谱,计算论文关键词与期刊主题的重叠度,按重叠数排序召回候选期刊;
9、s5b:学科模糊匹配通道,基于多套主流学科分类字段进行模糊检索,召回候选期刊;
10、s6:从语义搜索结果中选取种子论文,利用文献关联字段扩展共引网络,获取相关论文并统计其发表期刊频次,将高频期刊加入候选集,作为共引网络增强通道,实现从论文到期刊的反向推荐路径;
11、s7:将步骤s5和s6中三个通道的召回结果合并去重,按主题匹配度优先排序,得到候选期刊集合;
12、s8:对候选期刊进行五维加权评分,计算综合匹配分score,所述五维加权评分公式为:
13、score = w1 x s_topic + w2 x s_subject + w3 x s_impact + w4 x s_cost +w5 x s_evidence
14、其中s_topic为主题匹配度,s_subject为学科匹配度,s_impact为影响力匹配度,s_cost为审稿费用匹配度,s_evidence为论文发表证据度,w1至w5为对应的权重系数,所述s_evidence基于步骤s6中共引网络增强通道获取的相似论文在各候选期刊的发表数量和被引次数计算;
15、s9:对推荐结果进行多维度风险评估,包括基于中国作者发文占比进行风险分级、oa类型标准化处理和预警期刊标记,输出结构化风险提示;
16、s10:基于各维度评分和数据源证据,为每个推荐期刊生成基于事实依据的推荐理由,返回带有匹配评分、推荐理由和风险提示的top-n推荐结果。
17、进一步地,步骤s3中所述的多源异构数据采集具体包括:
18、从openalex api获取期刊主题图谱、h-index、i10-index、oa状态、apc费用和中国作者发文统计数据;
19、从crossref api获取期刊发文量、被引统计、年度趋势和论文类型分布数据;
20、从semantic scholar api获取论文语义搜索结果、tldr摘要、高影响力引用标记和相似论文推荐数据。
21、进一步地,步骤s8中所述的权重系数满足以下优先级关系:w1>w2 ≥ w5>w3>w4,其中w1为主题匹配度权重,在五维评分中取最大值,w2为学科匹配度权重,w5为论文发表证据度权重,w3为影响力匹配度权重,w4为审稿费用匹配度权重,取最小值。
22、所述权重系数的优先级关系基于期刊推荐场景中各决策维度对投稿决策的影响程度确定:
23、主题匹配度对投稿决策影响最大,因为论文研究方向与期刊收录范围的匹配是选刊的首要条件;
24、学科匹配度和论文发表证据度次之,分别从学科分类和已发表论文的实际发表去向两个角度提供匹配依据;
25、影响力匹配度再次之,反映期刊学术影响力与用户期望的匹配;
26、审稿费用影响最小,因为费用通常不是选刊的决定性因素。
27、进一步地,步骤s9中所述的基于中国作者发文占比进行风险分级具体为:
28、统计近5年中国作者发文数据,计算中国作者发文占比;
29、基于全球学术产出中中国作者的自然发文比例确定基准线,当占比低于基准线时标记为安全等级;
30、当占比高于基准线但未超过预设的国人友好阈值时,标记为国人友好等级;
31、当占比超过预设的国人友好阈值时,标记为高风险等级;
32、当占比超过预设的高危阈值时,标记为高危等级;
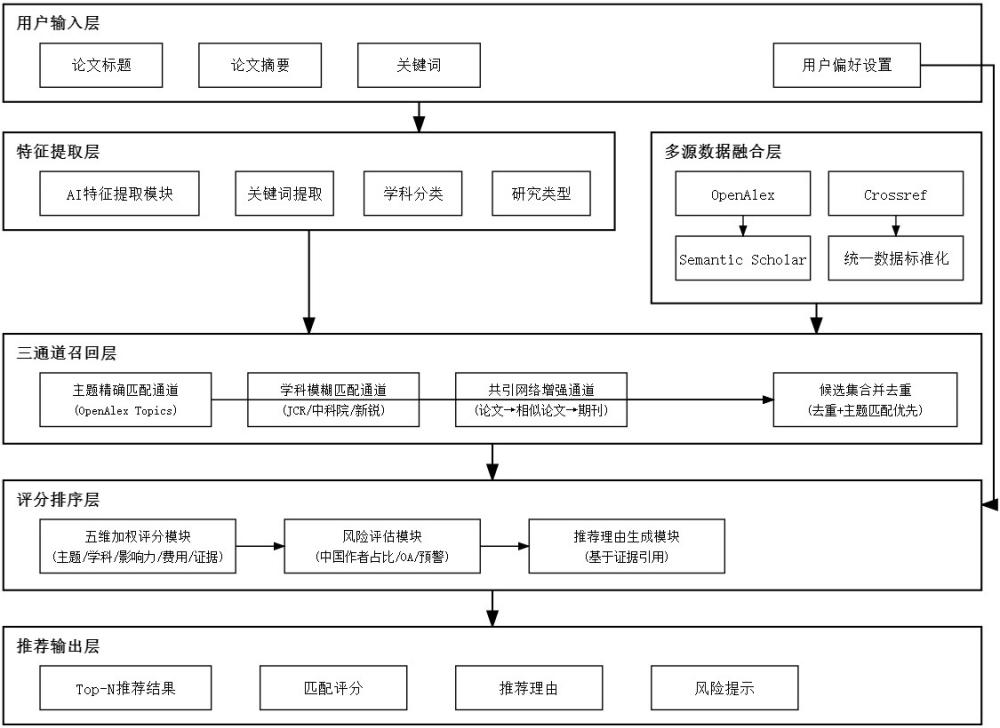
33、当占比超过预设的极高风险阈值时,标记为极高风险等级;
34、其中所述基准线基于全球学术论文数据库中中国作者的历史发文占比统计确定。
35、进一步地,所述基准线取值为全球学术论文数据库中中国作者近5年发文占比的统计均值,约为20-25%;所述国人友好阈值为基准线的1.5至2倍;所述高危阈值为基准线的2.5至3倍;所述极高风险阈值为基准线的3至3.5倍。该分级方法参考了中国科学院文献情报中心及新锐学术发布的期刊预警名单中关于作者来源集中度的评估思路,以及doaj对期刊国际化程度的评价标准。
36、进一步地,步骤s9中所述的oa类型标准化处理具体包括:对nature、science、cell期刊强制标记为hybrid类型;对非标准oa类型进行fallback映射,其中green映射为closed,bronze映射为hybrid;基于oa类型推断doaj收录状态,其中gold和diamond类型标记为已收录,closed和hybrid类型标记为未收录。
37、进一步地,步骤s6中所述的从语义搜索结果中选取种子论文具体为:选取语义搜索结果中相关度最高的前n篇论文作为种子论文,n的取值范围为2至5;所述扩展共引网络具体为:获取每篇种子论文的relatedworks列表,批量获取相关论文的元数据,统计各期刊收录的相关论文数量和累计被引次数,将收录数量超过预设阈值的期刊加入候选集。
38、进一步地,步骤s7中所述的合并去重具体为:以期刊唯一标识符为去重键,对三个通道的召回结果进行去重;对于同时被多个通道召回的期刊,保留其最高主题匹配度作为排序依据;候选集上限为100本期刊。
39、本发明还提供一种基于多源异构数据融合的学术期刊智能推荐系统,包括:
40、用户输入层,用于接收用户的论文信息和偏好设置;
41、特征提取层,与所述用户输入层连接,基于大语言模型api对论文文本进行特征提取,获得结构化论文特征;
42、多源数据融合层,包括若干学术开放数据源模块和统一数据标准化模块,所述统一数据标准化模块用于将各数据源模块返回的异构数据转换为内部标准schema;
43、三通道召回层,包括主题精确匹配通道、学科模糊匹配通道和共引网络增强通道,以及用于将三个通道的召回结果合并去重的候选集合并去重模块,所述共引网络增强通道从语义搜索结果中选取种子论文,利用文献关联字段扩展共引网络,统计相关论文的发表期刊频次,实现从论文到期刊的反向推荐路径;
44、评分排序层,包括五维加权评分模块、风险评估模块和推荐理由生成模块,所述五维加权评分模块基于主题匹配度、学科匹配度、影响力匹配度、审稿费用匹配度和论文发表证据度五个维度计算综合匹配分,其中论文发表证据度基于共引网络增强通道获取的相似论文发表数据计算;
45、推荐输出层,用于输出带有匹配评分、推荐理由和风险提示的top-n推荐结果。
46、进一步地,所述风险评估模块包括:中国作者发文占比风险分级子模块,用于基于openalex统计的近5年中国作者发文数据,计算中国作者发文占比,并按预设阈值进行五级风险分级;oa类型标准化子模块,用于对openalex返回的oa类型进行标准化处理,包括顶刊覆盖规则、非标准类型fallback映射和doaj收录状态推断;预警期刊标记子模块,用于检查期刊是否在预警期刊名单中并添加标记。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com