
一种基于强化学习后训练的中英文视觉文字生成方法
本发明属于人工智能,涉及基于流匹配和多模态扩散变换器mmdit(multi-modal diffusion transformer)的图像生成和视频生成,为一种基于强化学习后训练的中英文视觉文字生成方法。
背景技术:
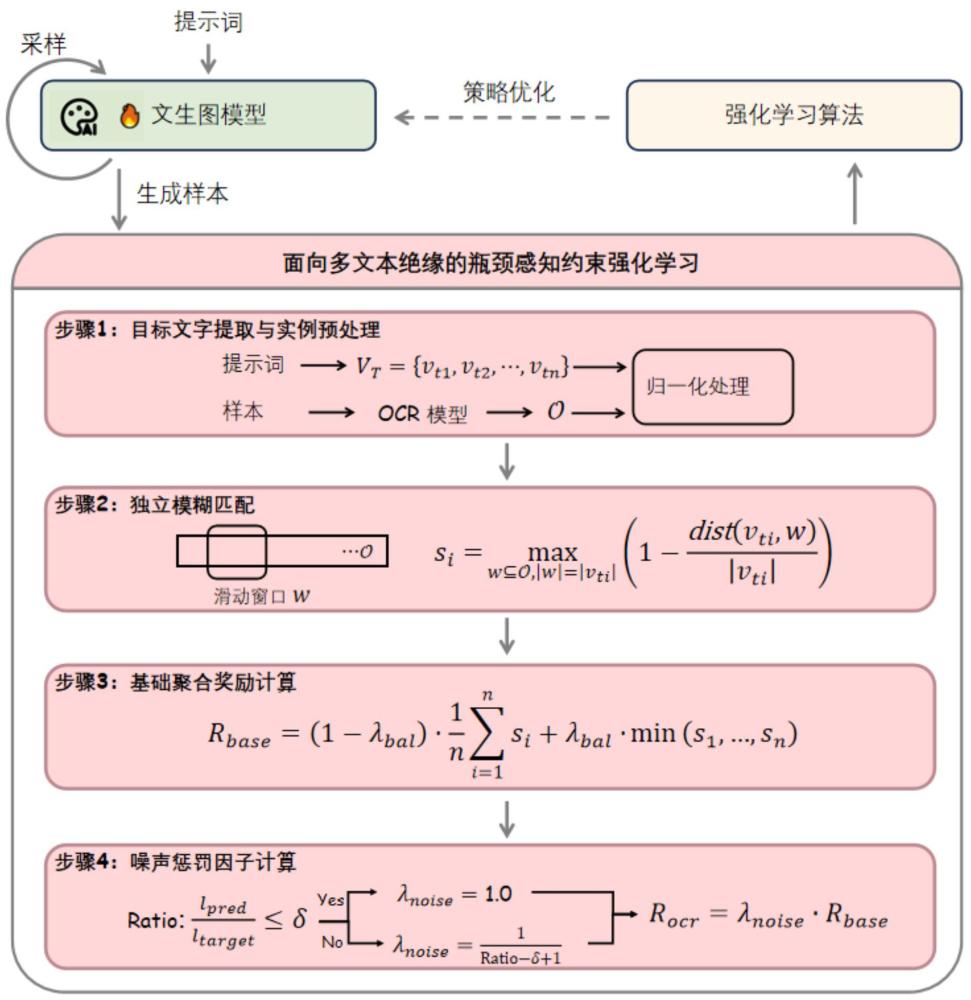
1、文生图模型的文字渲染能力是指模型根据提示词,在生成的图像内部准确、清晰地渲染出指定文字(如汉字、英文、数字、标点符号)的能力,在提升文字渲染能力这方面已经有了较多的研究成果,包括:训练外接文字渲染模块;训练文本模型,增强其字符理解;免训练方法。下面分别进行介绍。
2、1、训练外接文字渲染模块。这类方法比较有代表性的包括阿里巴巴公司题出的anytext和anytext2方法,以及中国科学技术大学提出的postermaker方法。在网络结构部分,这些方法均对主干扩散模型外接了一个类似控制网controlnet架构的模型。在训练的时候,contolnet进行参数更新,而主干模型的参数被冻结。
3、anytext提出了辅助潜在模块和文本嵌入模块。其中,辅助潜在模块用于将字型信息、位置信息叠加到隐空间中,用于扩散模型的去噪过程;文本嵌入模块利用了ocr模型,将字符语义信息嵌入到文本模型的embedding中,引导语言模型理解文本信息。同时,anytext还设计了textcontrolnet,根据上述两个模块提取出的信息,来控制最终图像的生成。在数据方面,anytext构建了大量的字型数据,这些字型数据以掩码(mask)的形式存在,包含了字符信息和位置信息。这些都会被送入controlnet参与训练。在推理过程中,模型首先将用户输入的prompt中的文字部分渲染成字符,然后作为控制信息引导模型推理。
4、anytext2在anytext的基础上进行了改进。它修改了textcontrolnet,去掉了时间编码层,同时也去掉了图像相关的输入,只保留字符信息相关的输入,并把修改后的模型命名为writenet。其本质上也是属于controlnet的流程。
5、postermaker主要是针对海报场景的文字渲染,它设计了textrendernet和scenegennet,分别以文字信息和场景信息作为引导,注入到主干模型中。这两个网络结构本质上也是根据controlnet结构进行的改动。textrendernet使得每个字符通过 ocr 编码器提取独立的视觉特征,scenegennet负责保持图片其他部分的一致性。另外,该方法使用的基准模型是stable diffusion (sd) 3 模型。由于sd3没有中文能力,该方法的引导图像生成的文本使用的是英文,而对于中文,该方法将每个中文文字分解成单个字符,将每个字符看作一个小图片,以视觉的形式引导模型生成中文字符。
6、2、训练文本模型,增强其字符理解。这类方法比较有代表性的是微软亚洲研究院和清华大学等单位题出的glyph-byt5和glyph-byt5-v2。为解决现有文本到图像生成模型在视觉文本渲染准确性低的问题,研究团队提出glyph-byt5,一种经过字符感知和字形对齐优化的定制化文本编码器。在数据方面,通过基于图形渲染构建可扩展的字形-文本配对数据集(含 100k-1m 规模),并采用字符或单词级字形增强策略进行数据增强;在训练方面,共分为两步:1)采用glyph-prompt和glyph-image,利用clip的对比学习方法,对文本模型byt5进行预训练。视觉主干模型采用dinov2。训练损失采用字符或单词级字形增强策略及框级对比损失 + 硬负样本对比损失训练。2)将预训练完成的glyph-byt5模型与主干模型sdxl进行对齐训练。方式是将其通过区域级多头交叉注意力机制集成到 sdxl 中,形成glyph-sdxl 模型,在训练过程中,为了保持原有主干模型的能力,采用了两个办法:lora微调、区域级多头交叉注意力机制训练。实验证明此方法可以大幅提升模型的文字渲染能力。
7、在增强字符理解这条技术路线上,另一种思路是采用更为精细的多模态融合方式,例如美团提出的chargen模型,它同样致力于解决字符渲染不准的问题,但其核心在于设计了一个字符级的多模态编码器 (character-level multimodal encoder) 。该方法不再将整行文字作为一个整体图像进行编码,而是将文本中的每一个字符都单独渲染成一张字形图 (glyph) 。随后,编码器会同时提取这个字符的视觉特征(来自字形图)和文本特征(来自其在原始文本中的编码),并通过特设的映射器模块,将这两种模态的特征融合成一个统一的、信息更丰富的字符级嵌入向量 。这种逐字融合视觉与文本信息的方式,使得模型能够获得对字符结构更细致、更精确的理解,从而在生成多笔画汉字或复杂英文单词时,有效避免字符粘连、缺笔画、增笔画等常见错误。为了进一步提升模型处理长文本描述的能力,chargen还引入了long-clip方案,将文本编码器的处理长度上限提升至248个token 。此外,为了在训练过程中强化对字形细节的监督,chargen还提出了一种名为 chargenloss 的新型感知损失函数 。该损失函数利用了一个预训练的odm(ocr文本去风格化)模型,其目标是专注于还原文字的字形结构而忽略其颜色、纹理等风格特征 。通过这种方式进行监督,可以让主干模型更专注于生成形态正确的字符,避免了因字体风格多样性带来的干扰,从而实现了对笔画细节更精准的约束 。
8、3、免训练方法。这类方法的其中一个代表是南京大学和中国移动等单位提出的textcrafter方法。textcrafter 是一个无需额外训练(training-free) 的方法,在现有的dit(diffusion transformer)模型上实现精确的多文本生成。它采用逐步分解(progressive)策略,包括三个关键阶段:1)instance fusion(实例融合),这一阶段的主要目标是强化文本与其视觉载体(如招牌、海报)的绑定关系。采用的方法是,利用引号 token的 embedding 与文本载体进行加权融合,确保文本出现在正确的区域,而不会“漂浮”在图像表面或错位。2)region insulation(区域隔离),主要目的是避免多个文本之间的相互干扰,包括混淆与遗漏。通过借助 dit 模型的空间先验(positional priors),自动为每段文字生成初步布局,再通过混合整数线性规划milp优化器生成不重叠的 bounding box,来实现文本区域的隔离与去噪,从而减少多文本冲突。3)text focus(文本聚焦),这一步主要为了提升小字体或复杂样式文本的清晰度。通过修改 attention map 权重,增强“文本token”与“图像 token”之间的注意力,重点突出视觉文字。
9、另一类免训练方法则从采样过程本身入手进行优化,其代表是由google和德克萨斯大学奥斯汀分校的研究人员提出的 attention modulated overshooting (amo)sampler 。该方法无需修改模型结构或进行额外训练,通过改进采样算法来显著提升预训练好的 rectified flow (rf) 模型的文本渲染质量 。其核心是一种名为“过射采样器(overshooting sampler)”的策略,该策略在标准的欧拉采样器 (euler sampler) 基础上,交替执行两个步骤:首先,有策略地“过模拟(over-simulating)”学习到的常微分方程(ode),即比常规单步预测更远的时间点 ;然后,通过重新引入精心计算的噪声来进行补偿和校正 。这一过程等效于在每个欧拉步中引入了一个额外的朗之万动力学项 (langevindynamics term),该项有助于纠正连续欧拉步中累积的误差,从而提升文本生成质量 。然而,较高的过射强度可能会导致图像出现过度平滑的伪影 。为了解决这个问题,研究人员进一步提出了注意力调制机制,即amo。该方法利用图像块与提示词中文字内容的注意力分数,来自适应地控制不同图像区域的过射强度。具体来说,它会增强文本相关区域的过射效果,同时减弱对图像其余部分的影响,从而在精确渲染文字的同时,不损害整体图像质量。实验证明,amo在sd3和flux等先进模型上,将文本渲染准确率分别提升了32.3%和35.9%,且没有增加额外的推理成本 。
10、上述方案分析可见,近两年来,针对文生图模型的文字渲染能力增强方法取得了很大的进展,但依然存在下面几个问题:
11、1、基于外接文字渲染模块或字形控制分支的方法,通常需要预先将目标文字渲染为字形图、文字掩码或布局控制条件,再输入文生图模型以约束图像生成。该类方法依赖预设字形和控制区域,当文字需要自然附着于标牌、黑板、包装袋等真实场景载体表面时,文字与载体之间的位置关系、透视关系和几何形变关系难以在生成前准确确定,因此容易出现文字位置、大小或朝向与载体不匹配的问题。
12、2、基于文本编码器或字符理解增强的方法,通常通过训练字符级编码器、字形感知文本模型或相关对齐模块来提升模型对文字内容和字形结构的理解能力。该类方法通常需要构建包含精确文字标注、字形图像或区域对齐信息的训练数据,数据构造成本较高;同时,在多文本实例同时生成的场景中,不同文字目标之间仍可能产生干扰,导致局部文字准确性与整体图像一致性难以兼顾。
13、3、免训练方法通常不更新基础文生图模型参数,而是在推理阶段通过区域约束、注意力调制或采样策略调整等方式改善文字生成效果。该类方法虽然使用灵活、成本较低,但其性能上限仍受基座模型能力限制;当基础模型在多文本生成、中文复杂字符渲染或幻觉文字抑制方面能力不足时,单纯依靠推理阶段约束难以从根本上提升文字生成能力。此外,部分推理阶段调整方法还可能引入过度平滑、伪影增加或细节丢失等新的图像质量问题。
14、因此,现有方法仍难以同时满足复杂场景下多文本准确生成、文字与视觉载体自然绑定、不同文本之间互不干扰、减少未指定文字或乱码文字幻觉,以及保持整体图像质量的需求。
15、另外,2025年中旬以来,随着seedream4.0、qwen-image等模型的发布,上述的文字增强方法不再适用,因为qwen-image等新的模型本身就有很强的文字渲染能力。这些模型通过大量的文字数据进行训练,其效果超过了前面所述的各类对原有模型的增强方案。但是,目前这些强大的模型依然存在生成幻觉的问题,这里的幻觉指的是生成用户未指定的文字或者乱码,如图1所示,图1中第一行生成了用户未指定的文字,第二行生成的文字中存在乱码。
16、由于人类对于文字的注意力远远比图像其他细节更敏感,所以文字幻觉非常影响图像整体内容的准确体现。
技术实现思路
1、本发明要解决的问题是:现有文生图模型的文字渲染能力提升存在生成位置受限、受基础模型能力影响等问题,特别是存在文字生成幻觉的问题。
2、本发明的技术方案为:一种基于强化学习后训练的中英文视觉文字生成方法,对于具备中英文文字生成图像能力的文生图模型,构建一个多文本绝缘奖励函数,采用强化学习后训练来优化文生图模型的文字渲染能力,具体为:
3、首先,从多文本提示词中提取个目标文本字符串实体,构成基准集合,由文生图模型生成图像并进行ocr识别,获取全局识别序列,针对每一个目标字符串,采用滑窗机制计算其与全局识别序列之间的独立相似度得分,所述独立相似度得分定义为目标字符串与序列中所有等长子串之间的最大莱文斯坦相似度;
4、计算基础聚合奖励:
5、
6、为平衡系数,用于控制对最差表现实例的敏感度,所述最差表现实例指基准集合中各个目标字符串计算所获独立相似度得分最低的实体;
7、计算基于所生成图像中的文本长度比例的噪声惩罚因子 :
8、
9、为长度比例的容忍阈值,用于容忍识别冗余,为生成的图像中经识别的文本总长度,为提示词中的目标文本总长度;
10、得到多文本绝缘奖励函数:。
11、进一步的,对和进行标准化处理,以消除格式噪声对奖励计算的干扰。
12、进一步的,独立相似度得分 的范围为,计算如下:
13、
14、其中, 表示莱文斯坦编辑距离。
15、进一步的,采用课程学习训练策略对文生图模型进行两阶段后训练,包括:
16、审美维持阶段:使用审美奖励模型对文生图模型进行预训练;
17、文本强化阶段:基于多文本绝缘奖励函数,对文生图中多文本生成的准确性进行优化,通过多文本绝缘奖励函数引导文本在特征层面实现空间解耦。
18、进一步的,进行强化学习后训练时,通过以下方式构建训练数据:
19、1)配置不同的文生图图片场景,包括通用写实环境、海报和ppt,其中通用写实环境的占比为50%,以在保障真实场景泛化性的同时规避同质化输出;;
20、2)配置提示词中的目标文本总长度:10~20字;
21、3)配置文生图提示词所要包含的文字类型,包括不同的图像中位置、颜色、大小、字型、以及复杂字型;
22、4)每个提示词中包含1~3处要求生成的目标文本;
23、基于上述配置生成用于强化学习后训练的训练样本,每条训练样本包括文本生成提示词和文本实例属性标注集合,文本实例属性标注集合用于记录该提示词中每个目标文本实例的结构化属性信息,包括文字内容、文字位置、文字颜色、字体类型和字体大小。
24、进一步的,对文生图模型进行幻觉文字评估,基于ocr模型,首先通过文字检测模型对生成图像中的文字区域进行检测,得到候选文字区域,然后利用文字识别模型识别所述候选文字区域中的文字,获得候选文字区域文本及其识别置信度;并计算候选文字区域文本与目标文本之间的局部文本相似度或文本覆盖召回度;若候选文字区域的识别置信度大于等于0.6,且其与目标文本之间的局部文本相似度或文本覆盖召回度大于等于0.90,则将该候选文字区域划分为正确文字块;若候选文字区域与目标文本之间的局部文本相似度或文本覆盖召回度大于等于0.60但小于0.90,则将该候选文字区域划分为未正确生成文字块,且不计入幻觉块;其余情况的候选文字区域划分为幻觉块;分别计算用于评估幻觉严重程度的幻觉计数指标和幻觉面积指标:
25、
26、
27、其中:为识别出的幻觉块数量,为第j个幻觉块的识别置信度,为幻觉块中文本与图像全局识别序列的独立相似性得分,为幻觉块检测框面积,为整图面积;幻觉计数指标和幻觉面积指标均与生成图像中的幻觉文字严重程度正相关;幻觉计数指标越大,表示生成图像中被识别出的幻觉文字块数量越多;幻觉面积指标越大,表示幻觉文字块在整张图像中占据的空间比例越大;
28、通过对训练的不同候选文生图模型生成的图像计算上述指标,比较文字幻觉抑制效果;在其他生成质量满足要求的情况下,选择幻觉计数指标和幻觉面积指标较低的模型作为较优的文生图模型。
29、本发明提出一种文生图模型的文字生成优化方法,包括训练方式、数据处理和评测基准三个方面都进行了针对性的改进设计。第一,在训练方式上,采用强化学习的手段,来优化目前具备中英文文字生成能力的开源模型。本发明的强化学习采用多文字隔离的强化学习后训练算法,将其应用到文字渲染能力提升方面。第二,在数据处理方面,构建了一个数据收集和清洗流程pipeline,有利于进一步提升强化学习后训练的效果。第三,在评测基准方面,基于ocr模型进行设计,使其有能力检测幻觉文字,可以有效评估本发明的视觉文字生成效果。
30、与 anytext、anytext2、glyphcontrol、postermaker 等基于外接文字渲染模块或字形控制分支的方法相比,本发明不需要在图像生成前预先构造字符 mask、字形图像或固定文字布局条件,而是在保留基础文生图模型原有生成能力的基础上,通过强化学习后训练提升其文字生成能力。因此,本发明能够避免预设字符 mask 对文字位置、形状和朝向的过强限制,使生成文字更容易随着真实场景中的标牌、黑板、包装袋等载体产生自然的位置关系和几何变化。
31、与 glyph-byt5、glyph-byt5-v2、textdiffuser、diff-text 等主要通过增强文字编码、引入布局掩码或限制注意力图来提升文字准确性的方案相比,本发明的重点不是为原本缺乏文字生成能力的模型额外增加文字控制模块,而是针对 qwen-image 等已经具备较强中英文文字生成能力、但在复杂多文本场景下仍可能产生未指定文字、重复文字或乱码文字的问题,构建基于 ocr 反馈的多文本绝缘奖励函数,并通过强化学习后训练直接优化模型的文字幻觉问题。
32、与 amo sampler 等在推理阶段通过采样策略调整来改善文字生成效果的方法相比,本发明不是仅对单次推理过程进行临时约束,而是将各目标文字作为相互独立的文本实例进行奖励建模:一方面通过独立相似度和最差文本实例约束提高各目标文字的生成完整性,避免漏字或漏文本;另一方面通过识别文本长度比例惩罚抑制未指定文字、重复文字和乱码文字等过度生成现象。由此,本发明能够从训练目标层面同时约束“应生成的文字必须准确生成”和“不应生成的文字不应出现”,从而更直接地降低复杂中英文视觉文字生成中的文字幻觉。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com