
一种覆盖缺口驱动的可信知识生产飞轮方法及系统与流程
本发明涉及计算机知识处理与人工智能,具体涉及一种覆盖缺口驱动的可信知识生产飞轮方法及系统。
背景技术:
1、随着检索增强生成(rag)技术和知识型智能系统的广泛应用,知识生产流程的可信度和可审计性日益成为关键问题。现有技术中,数据整理、版本控制与工作流溯源系统(例如us11042523b2)可记录数据清洗、实体解析、转换和发布过程,但其对象通常是数据表或数据集,不判断某一知识主题是否覆盖充分,也不区分候选知识能否被正式智能系统使用的门禁边界。
2、检索增强生成与知识图谱增强技术(例如us20250112878a1、us20250131289a1)通过检索外部文档增强生成模型输出,重点在于回答时怎样检索和利用知识,不解决检索资料被加工为候选对象后如何独立审校、确定性校验、哈希绑定并正式发布的问题。rag重提示与数据飞轮反馈技术利用知识图谱确定再提示方案,能够根据知识图谱关系改进后续提示或检索策略,但缺少缺口量化、数据需求、候选加工、审校发布、应用反馈的可信知识生产完整流程(rag重提示与数据飞轮反馈技术例如us20250371066a1)。
3、现有技术存在以下缺点:第一,检索到的资料常被直接用于回答,缺少候选知识和正式知识的强边界,导致未充分验证、重复、过期或低可信的资料可能包装成正式知识;第二,现有rag多关注召回质量,缺少对目标范围还差什么知识的量化判断,容易造成重复采集和虚假覆盖;第三,候选生成主体和审校主体容易同源,导致模型自审或同上下文偏差,降低审校有效性;第四,发布前缺少候选内容、审校报告、校验结果和发布包的一致性绑定,发布后内容可能被替换而无法追溯;第五,应用失败和用户纠错难以稳定转化为下一轮资料生产任务,知识资产无法持续更新。
技术实现思路
1、本发明所要解决的技术问题是:提供一种覆盖缺口驱动的可信知识生产飞轮方法及系统,使知识型智能系统只有在发布区无法满足目标范围时才创建数据需求;围绕数据需求进行多来源检索、快照解析、去重冲突处理和候选知识生成;候选知识经过独立审校、确定性校验和哈希绑定后才可进入发布区;正式应用后的失败、纠错和覆盖缺口继续反馈为下一轮数据需求,从而避免候选资料越权使用和虚增覆盖。
2、为解决上述技术问题,本发明采用如下技术方案:
3、一种覆盖缺口驱动的可信知识生产飞轮方法,包括:获取目标知识范围,所述目标知识范围包括至少一个子目标;根据发布区中已有的知识包,计算所述发布区对所述目标知识范围的覆盖满足度,并根据所述覆盖满足度确定覆盖缺口;当所述覆盖缺口大于或等于预设缺口阈值时,创建与所述目标知识范围对应的数据需求,并且阻断基于所述发布区对所述目标知识范围的正式输出;根据所述数据需求生成多种类型的查询语句,基于所述查询语句从多个来源采集资料,保存所采集资料的原始快照,并对所述原始快照进行解析以获得解析文档;依据规范化url、内容哈希、相似度和版本标识对所述解析文档进行去重处理和冲突记录,将去重处理后的抽取结果作为候选知识写入候选区,其中,所述候选区仅允许审校流程读取,不允许正式应用模块直接读取;由独立于候选生成主体的审校主体对所述候选区中的候选知识进行审校,输出通过、拒绝或需补充的审校结论;对审校结论为通过的候选知识执行确定性校验,所述确定性校验包括必填字段检查、边界声明检查、重复冲突检查、黄金样例检查和发布范围检查;对确定性校验通过的候选知识执行哈希绑定,将候选内容、审校报告、校验结果和发布包进行一致性绑定以形成发布一致性证明;将完成哈希绑定的候选知识作为正式知识写入所述发布区;以及采集所述正式知识在应用过程中的失败原因、用户纠错、覆盖缺口和过期事件,将其转化为下一轮数据需求、修订任务或退役任务。
4、优选地,所述根据发布区中已有的知识包计算所述发布区对所述目标知识范围的覆盖满足度,并根据所述覆盖满足度确定覆盖缺口,包括:为所述目标知识范围中的每个子目标设置重要性权重,所有子目标的重要性权重之和为1且每个权重非负;分别计算所述发布区对每个子目标的覆盖满足度,所述覆盖满足度取值范围为0至1;将每个子目标的重要性权重与对应的覆盖满足度相乘后求和,得到所述发布区对所述目标知识范围的覆盖满足度;以及将1减去所述覆盖满足度,得到所述覆盖缺口,计算公式为=σ(×),=1-式(1)。
5、优选地,所述数据需求包括目标范围、缺失知识点、最低来源要求、可接受用途和禁止声明;其中,所述最低来源要求规定候选知识所需的来源数量和来源类型,所述可接受用途规定该知识可被用于的应用场景,所述禁止声明规定该知识不应包含的内容或不应被用于的场景。
6、优选地,所述多种类型的查询语句包括核心查询、同义查询、反例查询、文件查询和站点查询;依据规范化url、内容哈希、相似度和版本标识对所述解析文档进行去重处理和冲突记录,包括:通过规范化url将同一网页的不同url形式统一,通过内容哈希识别完全相同的文档,通过相似度识别高度相似但不完全相同的文档,通过版本标识区分同一资料的不同版本;对于存在冲突的资料,记录冲突内容和冲突来源;计算重复率和冲突率,所述重复率为重复来源占总采集来源的比例,所述冲突率为存在冲突的候选知识占总候选知识的比例。
7、优选地,所述由独立于候选生成主体的审校主体对所述候选区中的候选知识进行审校,包括:确认所述审校主体与所述候选生成主体为不同主体;由所述审校主体对候选知识的内容准确性、来源可靠性和边界声明完整性进行审查;以及输出通过、拒绝或需补充的审校结论,其中,审校结论为需补充时,生成补充资料需求并返回资料采集步骤;审校结论为拒绝时,该候选知识不进入后续流程。
8、优选地,所述对确定性校验通过的候选知识执行哈希绑定之后,还包括:计算候选知识的发布可信评分,所述发布可信评分根据证据链健康评分、有用性评分、差异度评分和冲突度评分加权计算,计算公式为=++-式(3),其中,为候选知识对象e的发布可信评分,为证据链健康评分,为有用性评分,为差异度评分,为冲突度评分,、、、为预设权重系数,在一些实施例中=0.4,=0.3,=0.2,=0.1;当所述发布可信评分大于或等于预设发布阈值时,允许所述候选知识进入所述发布区;以及当所述发布可信评分小于所述预设发布阈值时,拒绝所述候选知识进入所述发布区并生成修订任务。
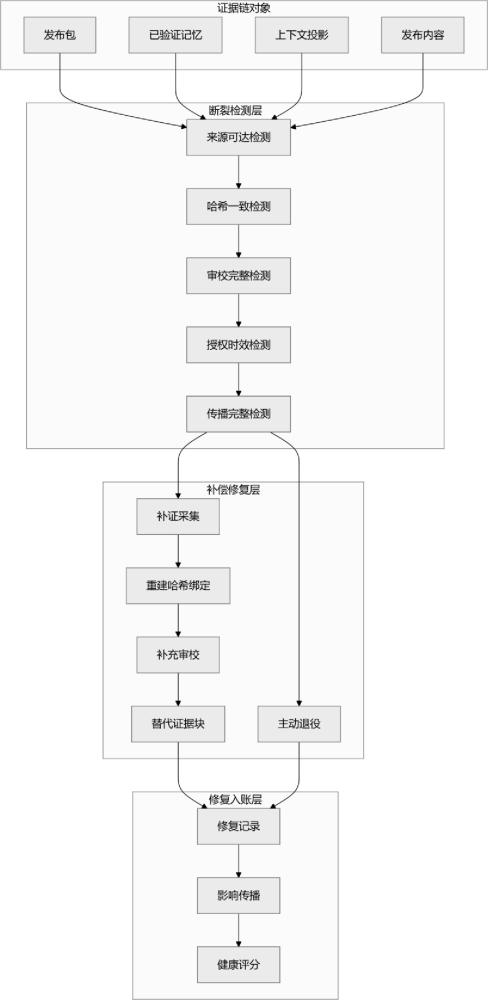
9、优选地,所述证据链健康评分通过以下方式计算:分别检测候选知识的来源可达性、哈希一致性、审校完整性、授权时效性和传播完整性,获得对应五个维度的缺失率、、、、;以及将1减去所述五个维度的缺失率的平均值,得到所述证据链健康评分,计算公式为=1-(++++)/5式(2),其中,来源可达性检测原始资料来源是否仍然可访问,哈希一致性检测候选内容与原始快照的哈希值是否一致,审校完整性检测审校报告是否完整,授权时效性检测资料的授权是否在有效期内,传播完整性检测知识在传播过程中是否完整未被篡改;每个维度的缺失率取值范围为0至1。
10、本发明还提供一种覆盖缺口驱动的可信知识生产飞轮系统,包括:覆盖门禁模块,用于获取目标知识范围,根据发布区中已有的知识包计算所述发布区对所述目标知识范围的覆盖满足度并确定覆盖缺口,当所述覆盖缺口大于或等于预设缺口阈值时创建数据需求并阻断正式输出;数据需求模块,用于记录所述数据需求,所述数据需求包括目标范围、缺失知识点、最低来源要求、可接受用途和禁止声明;查询组合模块,用于根据所述数据需求生成核心查询、同义查询、反例查询、文件查询和站点查询;快照解析模块,用于基于所述查询从多个来源采集资料,保存原始快照并对所述原始快照进行解析以获得解析文档;去重冲突模块,用于依据规范化url、内容哈希、相似度和版本标识对所述解析文档进行去重处理和冲突记录;候选知识模块,用于将去重处理后的抽取结果作为候选知识写入候选区,所述候选区仅允许审校流程读取,不允许正式应用模块直接读取;独立审校模块,用于由独立于候选生成主体的审校主体对所述候选区中的候选知识进行审校,输出通过、拒绝或需补充的审校结论;确定性校验模块,用于对审校结论为通过的候选知识执行确定性校验,所述确定性校验包括必填字段检查、边界声明检查、重复冲突检查、黄金样例检查和发布范围检查;哈希绑定模块,用于对确定性校验通过的候选知识执行哈希绑定,将候选内容、审校报告、校验结果和发布包进行一致性绑定以形成发布一致性证明;发布区,用于存储完成哈希绑定的正式知识;以及反馈再生产模块,用于采集所述正式知识在应用过程中的失败原因、用户纠错、覆盖缺口和过期事件,将其转化为下一轮数据需求、修订任务或退役任务。
11、优选地,所述覆盖门禁模块还用于:为所述目标知识范围中的每个子目标设置重要性权重,所有子目标的重要性权重之和为1且每个权重非负;分别计算所述发布区对每个子目标的覆盖满足度;将每个子目标的重要性权重与对应的覆盖满足度相乘后求和,得到所述发布区对所述目标知识范围的覆盖满足度;将1减去所述覆盖满足度,得到所述覆盖缺口;所述独立审校模块还用于:确认所述审校主体与所述候选生成主体为不同主体;由所述审校主体对候选知识的内容准确性、来源可靠性和边界声明完整性进行审查;输出通过、拒绝或需补充的审校结论,其中,审校结论为需补充时,生成补充资料需求并通知所述查询组合模块重新采集资料。
12、优选地,所述系统还包括发布许可判断模块和证据链健康检测与修复模块;所述发布许可判断模块用于:计算候选知识的发布可信评分,所述发布可信评分根据证据链健康评分、有用性评分、差异度评分和冲突度评分加权计算;当所述发布可信评分大于或等于预设发布阈值时,允许所述候选知识进入所述发布区;当所述发布可信评分小于所述预设发布阈值时,拒绝所述候选知识进入所述发布区并生成修订任务;其中,所述证据链健康评分通过分别检测候选知识的来源可达性、哈希一致性、审校完整性、授权时效性和传播完整性获得对应五个维度的缺失率,并将1减去所述五个维度的缺失率的平均值得到;所述证据链健康检测与修复模块用于对发布区中的正式知识执行证据链健康检测与修复,包括:读取正式知识的证据链,所述证据链包括发布包、已验证记忆、上下文投影和发布内容;依次执行来源可达检测、哈希一致检测、审校完整检测、授权时效检测和传播完整检测;当检测到证据链存在断裂时,生成修复计划;判断所述断裂是否可补证,当可补证时,执行补证采集和重审,并重建哈希绑定;当不可补证但可替代时,生成替代证据块;当不可恢复时,执行主动退役;将修复结果入账并更新健康评分。
13、与现有技术相比,本发明具有以下有益效果:
14、第一,将资料被检索到和知识可正式使用拆分,通过候选区、审校区和发布区的三区隔离,保证候选知识不能绕过审校直接影响正式输出,降低候选资料越权使用风险。
15、第二,用覆盖缺口函数把还差什么知识转化为可计算门禁,只有当覆盖缺口超过预设阈值时才创建数据需求并启动采集,通过覆盖缺口量化减少重复采集和虚假覆盖。
16、第三,通过候选生成主体与审校主体分离的独立审校机制,降低模型自审和同源偏差,提高审校有效性。
17、第四,通过确定性校验与哈希绑定组合的发布许可机制,将候选内容、审校报告、校验结果和发布包进行一致性绑定,形成发布一致性证明,防止发布内容被替换而无法追溯。
18、第五,通过反馈再生产模块将正式应用后的失败原因、用户纠错、覆盖缺口和过期事件转化为下一轮数据需求、修订任务或退役任务,使知识资产持续更新,形成可审计、可发布、可反馈的知识生产飞轮。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com