
一种皮肤基底细胞癌规范数据集构建方法
本发明涉及数据处理集成,特别是一种皮肤基底细胞癌规范数据集构建方法。
背景技术:
1、人工智能(ai)的三大核心要素包括算力、算法和数据集,随着计算机处理能力的提升与算法架构的创新发展,训练算法所需的数据集已成为决定ai输出质量和准确性的关键因素,是ai模型的基础,其重要性甚至超过算法和算力;现有人工智能辅助诊断模型对皮肤基底细胞癌的识别准确率已达到与临床专家相当的水平。
2、但目前具有代表性的数据集仍存在问题,现有数据集存在数据采集无统一标准、标签形式各异难以整合、元数据(人口统计学信息、临床信息等)存在选择偏倚等问题,大多数研究采用单一中心的回顾性数据集,仅能满足特定研究区域内的应用需求,且对现有数据集的评价指标同质化,多集中于数据完整性、准确性等基础维度,缺乏针对知识关联性、跨中心一致性及数据质量等特色评价指标,现有技术多依赖传统机器学习算法进行实体和关系抽取,未结合大模型的强语义理解能力,导致知识图谱构建周期长、实体关系提取准确率有限,且知识图谱概念层与数据层的联动不足,难以有效指导数据集变量选择与质量优化。
技术实现思路
1、鉴于上述现有存在的问题,提出了本发明。
2、因此,本发明提供了一种皮肤基底细胞癌规范数据集构建方法解决知识提取效率低、数据集与知识体系脱节、缺乏规范性约束及动态性的问题。
3、本发明的目的在于弥补现有数据集的不足,基于大模型与知识图谱融合及数据智能治理构建符合“完备性、无偏性、平衡性、一致性、动态性和安全性”6个维度的皮肤基底细胞癌规范数据集。
4、为解决上述技术问题,本发明提供如下技术方案:
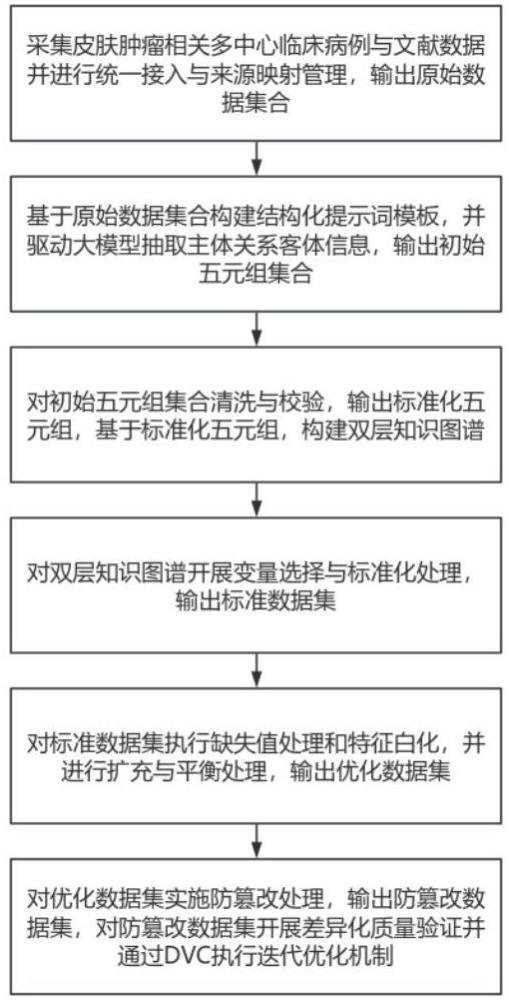
5、本发明提供了一种皮肤基底细胞癌规范数据集构建方法,其包括:采集皮肤肿瘤相关多中心临床病例与文献数据并进行统一接入与来源映射管理,输出原始数据集合;基于原始数据集合构建结构化提示词模板,并驱动大模型抽取主体关系客体信息,输出初始五元组集合;对初始五元组集合清洗与校验,输出标准化五元组,基于标准化五元组,构建双层知识图谱;对双层知识图谱开展变量选择与标准化处理,输出标准数据集;对标准数据集执行缺失值处理和特征白化,并进行扩充与平衡处理,输出优化数据集;对优化数据集实施防篡改处理,输出防篡改数据集,对防篡改数据集开展差异化质量验证并通过dvc执行迭代优化机制。
6、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述采集皮肤肿瘤相关多中心临床病例与文献数据并进行统一接入与来源映射管理,输出原始数据集合,具体步骤如下:
7、获取多中心临床病例数据与文献数据并建立统一的数据接入接口,对接入数据进行来源标识登记并绑定中心标识与采集批次标识;
8、对多中心临床病例数据与文献数据进行格式归一化与字段基础整理,得到原始数据集合。
9、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述输出初始五元组集合是以基底细胞癌知识图谱概念层定义的核心语义框架为约束,并基于结构化提示词模板调用大模型对原始数据集合进行抽取得到的。
10、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述结构化提示词模板是采用任务指令加约束条件加输出格式三段式结构;
11、所述基底细胞癌知识图谱概念层定义的核心语义框架包括实体类型与关系类型。
12、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述对初始五元组集合清洗与校验包括采用tf-idf计算实体语义相似度并剔除重复或语义冲突的五元组,对无法直接判定的五元组进行审核,形成标准化五元组。
13、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述双层知识图谱包括概念层与数据层,对概念层补充实体属性定义并添加关系约束,采用owl语言对概念层进行形式化描述并导入neo4j图数据库,将标准化五元组映射为数据层的实体节点与关系边,形成双层知识图谱。
14、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述输出标准数据集是通过对概念层实体属性与数据层的关联关系筛选核心变量进行元数据描述,对多中心字段执行变量名称对齐进行语义统一,并进行格式与单位统一和逻辑校验得到的。
15、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述对标准数据集执行缺失值处理和特征白化,并进行扩充与平衡处理,输出优化数据集,具体步骤如下:
16、对缺失比例达到缺失阈值且贡献度达到贡献度阈值的标准数据集采用改进gan模型补充数据,并按临床指标类别分层进行特征白化,形成中间优化数据;
17、基于中间优化数据,采用ctgan生成合成数据,并采用分层抽样与smote结合的混合采样方法,按病理分型、病情阶段分层,通过smote算法进行平衡优化,输出优化数据集。
18、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述输出防篡改数据集是通过对优化数据集进行整体哈希计算,采用sha-3算法生成唯一散列值并采用rsa-4096生成数字签名形成的。
19、作为本发明所述皮肤基底细胞癌规范数据集构建方法的一种优选方案,其中:所述差异化质量验证是由基础验证指标与验证指标共同构成,其中基础验证指标包括完备性、无偏性、平衡性与一致性,验证指标指通过五元组映射准确率tma与知识覆盖密度kcd及跨中心数据一致性ccd衡量防篡改数据集质量,并通过dvc进行版本控制执行迭代优化机制。
20、本发明有益效果为:通过“大模型+知识图谱”的融合创新,形成从知识提取、图谱构建到数据集制备、质量验证的完整技术闭环,相较于现有技术,实现了知识关联性强、数据质量高、提取效率高等多维度突破,解决了现有数据集缺乏解决了现有数据集缺乏规范,导致数据质量参差不齐且知识挖掘能力不足,难以支撑高质量人工智能辅助诊断模型训练的核心痛点,为人工智能辅助诊断模型训练、临床决策支持及多中心协作研究奠定高质量数据基础。
1.一种皮肤基底细胞癌规范数据集构建方法,其特征在于:包括:
2.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述采集皮肤肿瘤相关多中心临床病例与文献数据并进行统一接入与来源映射管理,输出原始数据集合,具体步骤如下:
3.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述输出初始五元组集合是以基底细胞癌知识图谱概念层定义的核心语义框架为约束,并基于结构化提示词模板调用大模型对原始数据集合进行抽取得到的。
4.如权利要求3所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述结构化提示词模板是采用任务指令加约束条件加输出格式三段式结构;
5.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述对初始五元组集合清洗与校验包括采用tf-idf计算实体语义相似度并剔除重复或语义冲突的五元组,对无法直接判定的五元组进行审核,形成标准化五元组。
6.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述双层知识图谱包括概念层与数据层,对概念层补充实体属性定义并添加关系约束,采用owl语言对概念层进行形式化描述并导入neo4j图数据库,将标准化五元组映射为数据层的实体节点与关系边,形成双层知识图谱。
7.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述输出标准数据集是通过对概念层实体属性与数据层的关联关系筛选核心变量进行元数据描述,对多中心字段执行变量名称对齐进行语义统一,并进行格式与单位统一和逻辑校验得到的。
8.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述对标准数据集执行缺失值处理和特征白化,并进行扩充与平衡处理,输出优化数据集,具体步骤如下:
9.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述输出防篡改数据集是通过对优化数据集进行整体哈希计算,采用sha-3算法生成唯一散列值并采用rsa-4096生成数字签名形成的。
10.如权利要求1所述的皮肤基底细胞癌规范数据集构建方法,其特征在于,所述差异化质量验证是由基础验证指标与验证指标共同构成,其中基础验证指标包括完备性、无偏性、平衡性与一致性,验证指标指通过五元组映射准确率tma与知识覆盖密度kcd及跨中心数据一致性ccd衡量防篡改数据集质量,并通过dvc进行版本控制执行迭代优化机制。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com