
面向强异质数据的几何拓扑感知联邦学习方法及系统
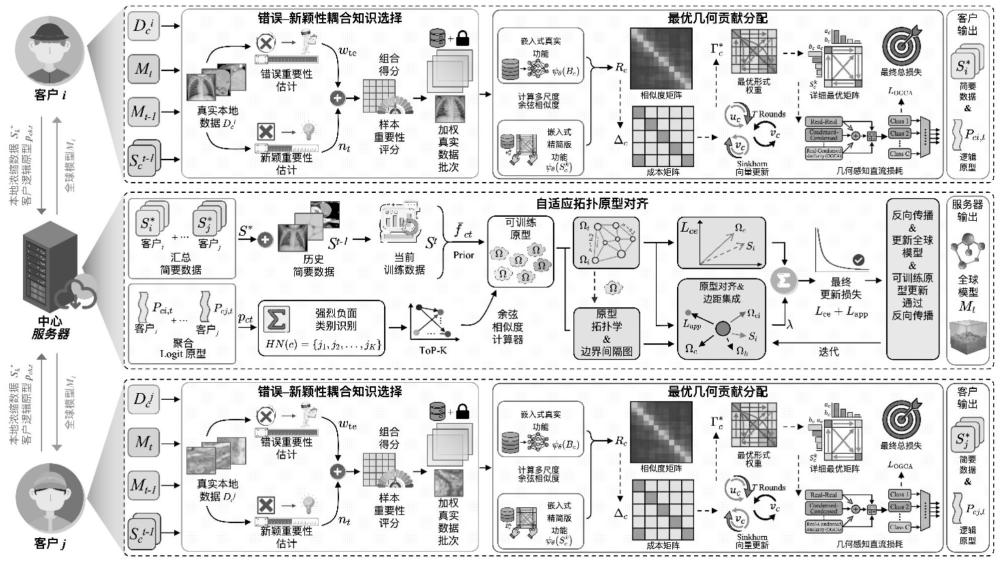
本发明属于数据处理,具体涉及一种面向强异质数据的几何拓扑感知联邦学习方法及系统。
背景技术:
1、在数据隐私保护与跨机构协同建模需求日益迫切的时代背景下,联邦学习(federated learning,fl)已成为支撑医疗影像分析、多媒体内容理解以及智能视觉计算等隐私敏感场景的核心技术范式。联邦学习是一种支持多客户端在不共享原始数据的前提下协同训练全局模型的分布式范式。其经典实现fedavg在每一轮中由服务端将全局模型分发至各客户端,客户端在本地数据上执行若干步随机梯度下降后,将模型参数(或梯度)上传至服务端进行加权平均聚合。
2、尽管近年来基于联邦学习的数据隐私保护协同建模技术在医疗影像、多媒体分析以及智能视觉计算等领域得到了广泛应用,然而,在实际部署过程中,由于分布于不同客户端的数据普遍呈现出严重的非独立同分布(non-independent and identicallydistributed,non-iid)特征,再叠加通信带宽受限与隐私泄露风险的双重约束,使得现有联邦学习方法在准确性、鲁棒性与通信效率等核心指标上面临巨大压力。因此,现有联邦学习方法在面对严重非iid与受限通信预算的双重挑战时,仍存在以下技术问题:
3、(1)严重非独立同分布场景下的客户端漂移与全局模型性能退化:传统的联邦学习算法(如fedavg及其改进变体)假设各客户端数据近似服从相同分布,但在实际医疗影像(pathmnist、organcmnist等)和自然图像(cifar-10、stl-10等)等多模态场景中,客户端间的数据分布存在显著的类别失衡与统计偏差。当采用dirichlet分布以极小浓度参数(如β=0.05或β=0.02)模拟极端非iid场景时,各客户端的本地优化方向严重发散,导致全局模型在聚合后产生持续性漂移,最终精度大幅下降。
4、现有的模型中心化的联邦学习方法(如fedprox、scaffold、moon等)主要从优化算法层面对原始的fedavg进行改进,例如fedprox在本地目标中引入近端正则项以约束本地更新与全局模型的偏离,moon则通过模型层面的对比学习来减少跨客户端的特征空间不一致性。这类方法虽然能够在一定程度上能够缓解客户端漂移现象,但是它们大多采用基于本地近端项或模型对比的“参数级修正”模式,在面对采用dirichlet分布以极小浓度参数(如β=0.05或β=0.02)模拟极端非iid场景时,这类方法仅能在客户端漂移已经产生之后对模型参数进行间接约束,无法从根本上补偿各客户端缺失的类别分布信息,其本质仍是在数据分布差异已经造成模型偏离之后进行的“事后参数级修正”,并未触及数据分布异质性的根本来源。当客户端间的数据异构程度进一步加剧时,仅依赖参数层面的间接修正往往难以获得持续且显著的性能提升。
5、(2)凝聚式数据共享方法的合成质量瓶颈与跨轮次冗余开销:数据集蒸馏(dataset condensation,dc)旨在将大规模真实数据集中所蕴含的知识压缩到一个小规模、可学习的合成数据集s中,使得在合成数据集s上训练的下游模型可以达到接近于在完整真实数据集上训练的性能。基于最大均值差异(maximum mean discrepancy,mmd)的分布匹配方法是其中应用最为广泛的技术路线之一,其基本思想是在某个隐空间(latentfeature space)中使合成数据集s的特征分布尽可能逼近真实数据t的分布。
6、现有的模型中心化的联邦学习方法(如feddm、fedvck等)通过在各客户端本地蒸馏出小规模合成数据集进行通信,这种凝聚式数据共享方法虽然通过共享小规模合成数据集在一定程度上缓解了模型层面的漂移,但其凝聚损失采用统一权重的mmd交叉项,未对真实样本与合成样本之间的几何相关性进行差异化建模,导致合成样本倾向于退化为“类均值中心”,丢失了重要的类内多样性,导致合成数据质量难以保证。同时,现有的模型中心化的联邦学习方法在每轮蒸馏中通常依据均匀采样或当前模型损失进行样本选择,跨轮次容易产生高度同质化的凝聚知识,造成宝贵的上传带宽被冗余更新所消耗。在极限通信预算(如10轮)下,这一冗余进一步放大,使得每轮所传输的凝聚数据对全局模型的边际信息增益急剧递减。
7、(3)严重数据异质性下全局判别边界的弱化与低掌握度区域的持续漂移:现有的模型中心化的联邦学习方法在服务端聚合时仅采用普通交叉熵或固定权重的有监督对比目标,未考虑全局原型空间中的“混淆类拓扑关系”。在严重数据异质性下,由于各客户端无法观察到所有类别的样本,全局聚合的类间判别边界在那些跨客户端共有的混淆类对(hard-negative classes)上极易模糊,这使得全局模型在那些跨客户端共有的易混淆类对上长期处于低掌握度状态,难以通过有限的通信轮次得到改善。此外,现有的模型中心化的联邦学习方法缺乏基于原型几何关系的自适应边界调节机制,使得对所有负类施加相同的分离强度,无法针对真正的混淆类对进行重点强化,进一步降低了系统在复杂异质场景下的鲁棒判别能力。
技术实现思路
1、本发明的目的是提供一种面向强异质数据的几何拓扑感知联邦学习方法及系统,旨在解决联邦学习场景中由于客户端数据严重非iid、通信带宽受限、全局判别边界模糊导致的模型漂移和凝聚冗余核心技术痛点以及现有技术在严重非iid环境下凝聚低效、判别不足及通信昂贵等技术短板,通过系统化方法实现对联邦协同建模任务的高效、鲁棒、隐私友好支持。
2、本发明通过基于最优传输的几何感知蒸馏、基于误差-新颖性耦合的样本选择以及基于自适应拓扑边界的原型对齐三大核心创新点,系统性地解决了联邦学习中凝聚质量低、跨轮冗余高、判别边界弱三大难题,为构建鲁棒、通信高效且兼具隐私保护能力的联邦协同建模体系提供了新范式与工程实践指导。
3、本发明为解决技术问题所采用的技术方案如下:
4、本发明的第一个目的是提供一种面向强异质数据的几何拓扑感知联邦学习方法。
5、本发明提供的一种面向强异质数据的几何拓扑感知联邦学习方法,主要包括以下步骤:
6、步骤一、客户端执行基于最优传输的几何感知蒸馏;
7、s101:在客户端,对每个类别构建真实样本与合成样本之间的多尺度高斯核相似度矩阵;
8、s102:基于多尺度高斯核相似度矩阵构建真实样本到合成样本的运输代价矩阵;通过sinkhorn迭代求解最优贡献分配矩阵,以替代标准mmd凝聚损失中的统一权重交叉项;
9、s103:以最优贡献分配矩阵为加权矩阵重写mmd凝聚损失中的统一权重交叉项得到几何感知凝聚损失;
10、步骤二、客户端执行基于误差-新颖性耦合的样本选择;
11、s201:利用当前轮次全局模型与上一轮全局模型的自集成输出,对样本的未掌握度进行平滑估计;基于自集成预测误差定义误差重要性权重;
12、s202:基于样本与历史凝聚知识在隐空间中的最大相似度定义新颖性得分;
13、s203:将误差重要性权重和新颖性得分以乘性放大形式构造为协同重要性得分,最后归一化得到知识选择分布;
14、步骤三、服务端执行基于自适应拓扑边界的原型对齐;
15、s301:服务端将所有客户端上传的逻辑原型按样本数加权聚合,得到全局逻辑原型;
16、s302:从全局逻辑原型中按降序选取top-k混淆类作为top-k混淆类集合;
17、使用每个类别的特征原型先验对可学习全局原型进行初始化;
18、s303:对每个类别及其混淆类定义自适应拓扑边界,同时构造自适应拓扑原型校准损失,服务端使用联合损失同时更新全局模型参数与可学习全局原型。
19、进一步的,步骤s101中,真实样本与合成样本之间的多尺度高斯核相似度矩阵为:
20、;
21、其中,为预定义的核尺度参数集合,为共享嵌入函数,k为预定义的核尺度参数集合中核尺度参数的数量,为类别的真实样本,为类别的合成样本;所述运输代价矩阵为:,为全1矩阵,为多尺度高斯核相似度矩阵,为真实样本小批量中的样本数量,为合成知识集合中的样本数量;
22、步骤s102中,所述最优贡献分配矩阵为:,,为边缘约束集合,为由行、列组成的实数矩阵空间,为frobenius内积,ε > 0为熵正则化系数,为熵项,为类别;
23、步骤s103中,所述几何感知凝聚损失为:
24、;
25、其中,为真实样本小批量内真实样本之间的平均多尺度高斯核相似度,为合成知识集合内合成样本之间的平均多尺度高斯核相似度,为最优传输加权的交叉项;对全部类别求和即得到整体的客户端凝聚目标为:。
26、进一步的,步骤s201中,所述自集成预测误差为:
27、;
28、其中,为交叉熵损失,α ∈ [0, 1]为自集成系数,为当前轮次全局模型,为上一轮全局模型,为本地样本,为本地样本的标签;
29、所述误差重要性权重为:
30、;
31、其中,为控制数值尺度的常数;自集成预测误差越大,表明当前全局模型对该本地样本所体现的知识掌握程度越低,对应的平滑后的误差重要性权重越接近1,从而在后续采样中获得更高的权重。
32、进一步的,步骤s202中,所述新颖性得分为:
33、;
34、其中,sim(·, ·)为特征相似度度量,表示类别在第轮结束后服务端聚合的历史凝聚知识集合,为共享嵌入函数,为本地样本,s为类别在第轮结束后服务端聚合的历史凝聚知识集合中的样本;
35、若当前样本与历史凝聚知识在隐空间中高度相似,则其新颖性接近0;反之则接近1;当即首轮通信时,取1;
36、进一步的,步骤s203中,所述协同重要性得分为:
37、;
38、其中,β ≥ 0为新颖性平衡系数,为误差重要性权重,为新颖性得分;
39、所述知识选择分布为:,和均为本地样本,为客户端本地类别的样本集合,为上一轮全局模型,表示类别在第轮结束后服务端聚合的历史凝聚知识集合,为本地样本的协同重要性得分。
40、进一步的,步骤s301中,每个类别的逻辑原型为:
41、;
42、其中,为客户端上类别的本地样本,为客户端上类别的本地样本集合,为客户端上类别的本地样本数量,为去除最末softmax层的全局模型输出;
43、所述全局逻辑原型为:,为类别在所有客户端上的样本总数,为类别在客户端上的样本数。
44、进一步的,步骤s302中,所述top-k混淆类集合为:
45、;
46、其中,为全局逻辑原型,为在预测层面最容易与类别发生混淆的个类索引。
47、进一步的,步骤s303中,所述自适应拓扑边界为:
48、;
49、其中,为基础边界常数,cos(·, ·)为余弦相似度;若类别的可学习全局原型与类别h的可学习全局原型在原型空间中越接近即越易混淆,则其拓扑边界越大,对应的负样本logit会被减去更大的间隔,从而被推得更远;反之则拓扑边界更小,避免过度强行分离本就相距甚远的类对;
50、所述联合损失为:,为在当前轮次凝聚知识上的分类交叉熵损失,λ为加权系数,为自适应拓扑原型校准损失。
51、本发明的第二个目的是提供一种面向强异质数据的几何拓扑感知联邦学习系统。
52、本发明提供的一种面向强异质数据的几何拓扑感知联邦学习系统,主要包括:客户端基于最优传输的几何感知蒸馏模块、客户端基于误差-新颖性耦合的样本选择模块、服务端基于自适应拓扑边界的原型对齐模块以及面向联邦协同建模的客户端-服务端一体化训练与聚合模块;在每一轮通信(t = 1, 2, …, t)中,服务端首先将当前全局模型下发至全部参与的个客户端。每个客户端在本地数据与历史凝聚知识上首先利用ecks模块执行基于误差-新颖性耦合的样本选择:针对每个类别构造一个兼顾未掌握度与新颖性的非均匀采样分布,并据此采样真实数据小批量;随后利用ogca模块执行基于最优传输的几何感知蒸馏,即对该类别的合成知识集合进行最优传输引导的几何感知蒸馏更新;当本地所有类别的蒸馏迭代完成后,客户端计算每个类别的逻辑原型,并将更新后的凝聚知识与逻辑原型一并上传至服务端。服务端将所有客户端上传的凝聚知识聚合为,并将逻辑原型按样本数加权聚合为全局逻辑原型,进而利用atpa模块执行基于自适应拓扑边界的原型对齐:依据历史凝聚知识初始化可学习全局原型集合并使用自适应拓扑边界对全局模型与可学习全局原型集合进行联合训练。
53、本发明的第三个目的是提供一种电子设备。
54、本发明提供的一种电子设备,主要包括:处理器、通信接口、存储器和通信总线;
55、存储器,用于存储计算机程序以及用户上传的本地数据;
56、处理器,用于执行存储器中所存储的计算机程序,以实现权利要求1-8中任意一项所述的面向强异质数据的几何拓扑感知联邦学习方法的步骤;
57、通信接口,用于本发明的一种电子设备与其他设备之间的通信;
58、通信总线,用于实现处理器、通信接口和存储器之间的通信。
59、本发明的有益效果是:
60、本发明结合基于最优传输的几何感知蒸馏、基于误差-新颖性耦合的样本选择以及基于自适应拓扑边界的原型对齐,系统性地解决了联邦学习在严重非独立同分布数据与极限通信预算下面临的凝聚质量低、跨轮冗余高、判别边界弱等技术痛点。本发明的优点主要可归纳为以下几个层面:
61、(1)针对现有技术存在的严重非独立同分布场景下的客户端漂移与全局模型性能退化问题,本发明提出了基于最优传输的几何感知蒸馏机制以及基于自适应拓扑边界的原型对齐机制,力图在客户端层面构建保留局部几何结构的高质量凝聚知识,从根本上缓解分布漂移所造成的模型退化问题。
62、具体而言,本发明通过基于最优传输的几何感知蒸馏与基于自适应拓扑边界的原型对齐的双重机制,大幅提升了全局模型在严重数据异质性下的判别能力。在dirichlet浓度系数β=0.05的严重非iid设置下,fedgat在pathmnist、organsmnist、organcmnist、pneumoniamnist四个医疗影像数据集上分别相较最强基线fedvck提升9.60、1.95、10.13、8.02个百分点;在更具挑战性的β=0.02设置下进一步取得7.74、5.96、8.75、8.06个百分点的提升。在cifar-10、stl-10、imagenette三个自然图像数据集上,本发明在β=0.05下相较fedvck分别提升11.80、10.55、13.20个百分点,β=0.02下保持13.04、6.73、5.60个百分点的稳定领先,真正实现了从被动适应异质性到主动重塑判别边界的范式跨越,实现了严重非iid场景下精度的战略性提升。
63、(2)针对现有技术存在的凝聚式数据共享方法的合成质量瓶颈与跨轮次冗余开销问题,本发明提出了基于误差-新颖性耦合的样本选择机制,旨在显式优先选择当前模型尚未掌握、且与历史凝聚知识最大程度互补的真实样本进行蒸馏,从而保证每轮通信都能为全局模型注入真正有价值的新信息。具体而言,借由基于最优传输的几何感知蒸馏引导的高效凝聚与基于误差-新颖性耦合的样本选择机制,本发明成功解决了现有数据中心化联邦学习方法在通信效率上的工程瓶颈。在path、organs、pneumonia三个数据集上,本发明每轮上传通信量分别仅为1.78 mb、0.47 mb、6.24 mb,相对典型模型中心化方法(fedavg、fedprox、moon等的12.13 mb、12.20 mb、426.15 mb)分别降低6.8倍、26.0倍、68.3倍;相对最接近基线fedvck进一步降低12.7%、9.6%、47.0%。即使在通信预算被限制为10轮的极限场景下,fedgat在path、organs、organc、pneumonia上仍能保持87.13%、74.60%、88.06%、93.11%的精度,相对fedvck分别领先8.64、1.95、16.48、9.90个百分点,展现出在边缘联邦学习场景的强大部署适应性,兼顾通信效率与边缘部署友好性。
64、(3)针对现有技术存在的严重数据异质性下全局判别边界的弱化与低掌握度区域的持续漂移,本发明构建了基于自适应拓扑边界的原型对齐机制,通过为每个类别识别其top-k混淆类并定义随原型几何关系动态变化的拓扑边界,强化全局模型的类间判别能力。具体而言,本发明通过基于误差-新颖性耦合的样本选择机制实现了“难样本+新样本”的主动聚焦,同时配合服务端top-k混淆类的拓扑边界增强,使得每一轮通信都能针对当前模型最为薄弱的类间判别区域注入最大化的边际信息增益。相较于传统逐轮均匀蒸馏模式,该机制显著增强了对长期低掌握度区域的修正能力,强化了对低掌握度区域与跨轮次知识冗余的主动消除,确保了系统在严重数据异质性环境下的稳健收敛水平。
65、(4)本发明提供了隐私友好的合成知识共享并具备广泛行业适应性。本发明特别采用随机高斯噪声作为合成知识的初始化分布,使凝聚后的合成图像在视觉层面与原始真实数据存在显著差异,但在分布层面仍能传递有效的判别信号。本发明在极限通信预算(10轮)下即可获得接近完整训练精度的特性,能够显著降低跨轮次梯度暴露所带来的隐私攻击面。在organs数据集上的成员推断攻击(mia)实验结果显示,本发明取得最大auc 0.539与平均auc 0.509的优异防御指标(接近随机猜测的0.5),防御率为60%,显著优于fedavg(10%)与fedvck(50%)。鉴于其在医疗影像与自然图像数据集上同时表现出的稳健泛化能力,本发明能有效适配医疗影像联合诊断、跨银行金融建模、多工厂工业质检与多端云协同视觉计算等多种关键行业场景,展现出广阔的市场前景与社会价值。
66、(5)整体体系的高效协同与实战价值;
67、本发明通过基于最优传输的几何感知蒸馏、基于误差-新颖性耦合的样本选择以及基于自适应拓扑边界的原型对齐的系统化设计,实现了联邦学习从高带宽、模型层修正向低带宽、数据层重构的完整闭环。客户端负责生成几何结构丰富、跨轮次互补的凝聚知识,服务端则负责在异质数据条件下精准强化混淆类对的判别能力。这种系统化的技术范式不仅为医疗影像、自然图像等八个数据集上的严重非iid任务提供了平均高达13.37%的精度提升,更通过低至1.78 mb的单轮上传量(对比模型中心化方法降低6.8倍)实现了低带宽、高精度、强隐私的多目标协同,为隐私敏感行业的跨机构智能化建模提供了前瞻性的技术支撑。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com