
AI大模型跨域混合训练与混合推理协同调度方法及系统与流程
本技术涉及数据处理,尤其涉及一种ai大模型跨域混合训练与混合推理协同调度方法及系统。
背景技术:
1、近年来,人工智能大模型的规模持续扩大,对计算、存储和网络资源的需求呈指数级增长。单一数据中心或云环境往往难以独立支撑完整的训练与推理负载,尤其在企业需兼顾数据安全(倾向私有云)与弹性扩展(依赖公有云)的场景下,跨多个云环境协同执行ai(artificial intelligence,人工智能)任务成为必然趋势。因此,如何在地理分散、架构异构的多云环境中高效调度大模型的训练与推理任务,已成为提升ai基础设施效能的关键课题。
2、目前,主流的大模型跨域调度方法通常将训练与推理视为两类独立任务,分别部署于中心化gpu(graphics processing unit,图形处理器)集群与边缘节点,并通过定期模型同步实现弱耦合。在资源管理上,各云区域常被当作孤立资源池,缺乏统一视图;任务调度多采用静态规则或简单负载均衡策略,未充分考虑跨域链路的实际网络状态。此外,不同厂商gpu因软件栈差异,往往被隔离部署,难以混合使用。这种割裂式的调度方式导致资源利用率低下,且无法根据任务特性与网络条件动态优化部署位置。
3、综上,在多云异构算力环境下,实现大模型训练与推理任务的高效协同与资源统一调度,成为亟待解决的技术问题。
技术实现思路
1、本技术提供一种ai大模型跨域混合训练与混合推理协同调度方法及系统,用以解决现有技术中在多云异构算力环境下,缺乏大模型训练与推理任务的高效协同与资源统一调度方案的缺陷。
2、本技术提供一种ai大模型跨域混合训练与混合推理协同调度方法,包括如下步骤:
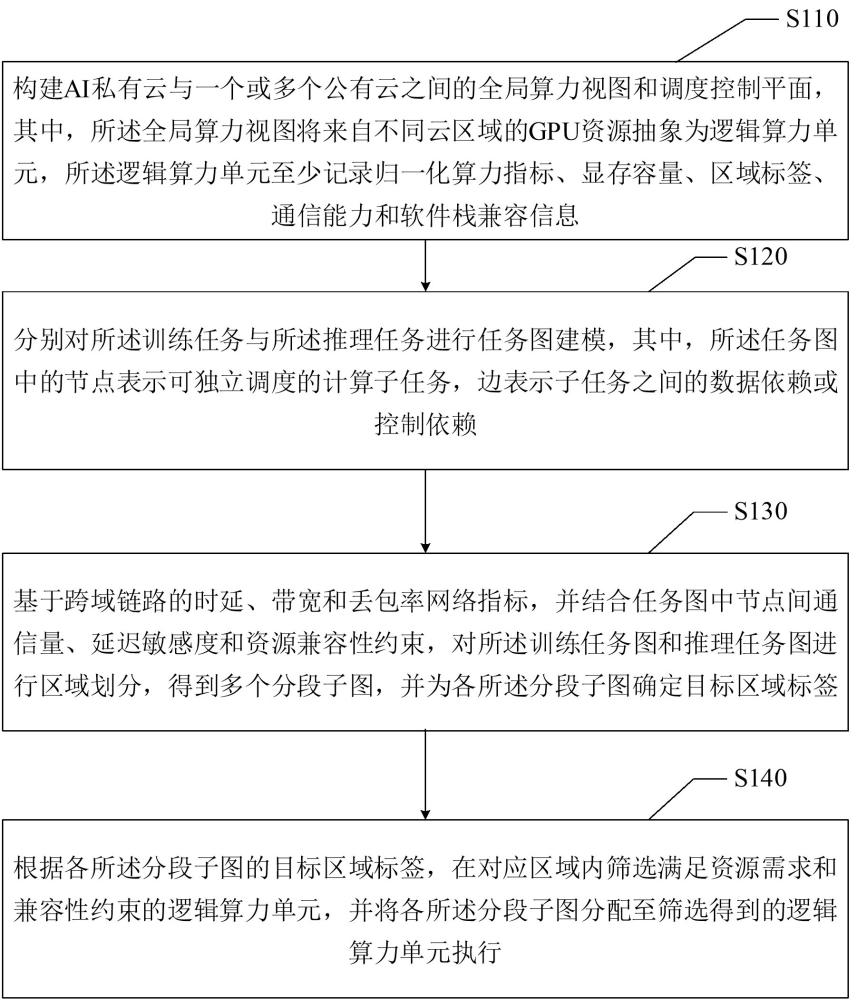
3、构建ai私有云与一个或多个公有云之间的全局算力视图和调度控制平面,其中,所述全局算力视图将来自不同云区域的gpu资源抽象为逻辑算力单元,所述逻辑算力单元至少记录归一化算力指标、显存容量、区域标签、通信能力和软件栈兼容信息;
4、分别对所述训练任务与所述推理任务进行任务图建模,其中,所述任务图中的节点表示可独立调度的计算子任务,边表示子任务之间的数据依赖或控制依赖;
5、基于跨域链路的时延、带宽和丢包率网络指标,并结合任务图中节点间通信量、延迟敏感度和资源兼容性约束,对所述训练任务图和推理任务图进行区域划分,得到多个分段子图,并为各所述分段子图确定目标区域标签;
6、根据各所述分段子图的目标区域标签,在对应区域内筛选满足资源需求和兼容性约束的逻辑算力单元,并将各所述分段子图分配至筛选得到的逻辑算力单元执行;
7、在各所述分段子图执行过程中,基于训练吞吐、推理延迟、资源利用率和网络状态,对分段子图与逻辑算力单元之间的映射关系以及跨域通信策略进行动态调整。根据本技术提供的一种ai大模型跨域混合训练与混合推理协同调度方法,所述将各所述分段子图分配至筛选得到的逻辑算力单元执行,包括:
8、将第一类分段子图分配至所述ai私有云侧的逻辑算力单元执行;
9、将第二类分段子图分配至所述公有云侧的逻辑算力单元执行;
10、其中,所述第一类分段子图的计算密集度大于所述第二类分段子图的计算密集度,所述第一类分段子图的通信量与通信频率小于所述第二类分段子图的通信量与通信频率,所述第二类分段子图的用户关联性大于所述第一类分段子图的用户关联性,所述第二类分段子图的延迟敏感度大于所述第一类分段子图的延迟敏感度,所述第一类分段子图和所述第二类分段子图是根据预设分类规则或分类模型确定的。
11、根据本技术提供的一种ai大模型跨域混合训练与混合推理协同调度方法,所述将各所述分段子图分配至筛选得到的逻辑算力单元执行,包括:
12、在满足推理任务服务水平协议和资源利用率阈值约束的条件下,以训练吞吐率、推理延迟和执行成本为联合优化目标,确定各所述分段子图的执行区域;
13、针对每一所述分段子图,在对应的执行区域中选择逻辑算力单元执行;
14、确定跨域通信的拓扑与频率。
15、根据本技术提供的一种ai大模型跨域混合训练与混合推理协同调度方法,所述ai大模型跨域混合训练与混合推理协同调度方法还包括:
16、在所述训练任务中,对梯度按重要性进行分层,第1层梯度在每个迭代步骤中进行同步,第i层梯度的同步频率大于第i+1层梯度的同步频率,i为正整数。
17、根据本技术提供的一种ai大模型跨域混合训练与混合推理协同调度方法,各层梯度的同步频率与梯度压缩比例是基于网络状态实时更新的。
18、根据本技术提供的一种ai大模型跨域混合训练与混合推理协同调度方法,所述ai大模型跨域混合训练与混合推理协同调度方法还包括:
19、将训练任务的流量标记为第一类业务流;
20、将推理任务的流量标记为第二类业务流;
21、控制所述第二类业务流的优先级高于所述第一类业务流的优先级。
22、本技术还提供一种ai大模型跨域混合训练与混合推理协同调度系统,包括:
23、全局算力视图构建模块,用于将ai私有云与一个或多个公有云中的gpu资源抽象为逻辑算力单元,并维护逻辑算力单元的区域标签、算力能力、显存容量、通信能力及软件栈兼容信息;
24、任务图建模模块,用于分别对训练任务与推理任务进行任务图建模,其中任务图中的节点表示可独立调度的计算子任务,边表示子任务之间的数据依赖或控制依赖;
25、区域划分模块,用于基于跨域链路的网络指标数据并结合任务图特征,对任务图进行区域划分,得到多个分段子图并确定各分段子图的目标区域标签;
26、调度决策模块,用于根据目标区域标签以及逻辑算力单元的能力信息,为各分段子图选择执行区域和目标逻辑算力单元;
27、跨域通信控制模块,用于确定分段子图执行过程中的跨域通信拓扑、同步频率、压缩比例及业务流优先级策略;
28、执行反馈与优化模块,用于根据训练吞吐、推理延迟、资源利用率和网络状态,对调度参数、通信参数及任务映射关系进行动态调整。本技术还提供一种电子设备,包括存储器、处理器及存储在存储器上并可在处理器上运行的计算机程序,所述处理器执行所述计算机程序时实现如上述任一种所述ai大模型跨域混合训练与混合推理协同调度方法。
29、本技术还提供一种非暂态计算机可读存储介质,其上存储有计算机程序,该计算机程序被处理器执行时实现如上述任一种所述ai大模型跨域混合训练与混合推理协同调度方法。
30、本技术还提供一种计算机程序产品,包括计算机程序,所述计算机程序被处理器执行时实现如上述任一种所述ai大模型跨域混合训练与混合推理协同调度方法。
31、本技术提供的ai大模型跨域混合训练与混合推理协同调度方法及系统,通过建立全局算力视图并将所有gpu抽象为逻辑算力单元,打破了不同云环境与硬件平台之间的资源壁垒,调度控制平面可在统一资源池中统筹分配算力,避免了因私有云与公有云资源孤立管理而导致的局部过载与整体闲置并存的问题,显著提升了全局算力资源的可见性与可调度性;通过对训练任务与推理任务进行统一的任务图建模,使得两类任务可在同一调度框架下被协同分析与优化,系统不再将训练与推理视为互不相关的负载,而是能够识别其在计算依赖、数据流和资源需求上的潜在关联,为后续联合调度奠定基础;基于网络指标数据对任务图进行区域划分,使任务子图的部署位置与底层网络条件相匹配,例如,通信开销大的子图可被约束在同一低延迟域内,而对延迟不敏感的子图则可灵活分布于远端区域,这种网络感知的划分策略有效降低了跨域通信对任务执行效率的负面影响,更能适应真实广域网环境的动态特性;将划分后的分段子图分配至不同的逻辑算力单元执行,实现了任务与资源的精细化匹配,调度控制平面可根据各逻辑算力单元的实时负载、类型与位置,将子图映射到最合适的物理节点,从而在保障任务正确执行的前提下,提升整体资源利用效率与任务完成时效。综上所述,本技术方案通过全局资源抽象、任务统一建模、网络感知划分、跨域通信协同控制与子图精准分配,显著提升了多云异构环境下ai大模型训练与推理任务的协同调度效率与资源利用率。本技术并非将训练任务和推理任务作为相互独立的两类业务分别调度,而是在统一调度控制平面下,对训练任务和推理任务进行联合建模、联合划分、联合资源分配和优先级协调。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com