
一种针对谈话内容的语篇规整方法和系统与流程
本申请涉及人工智能和自然语言处理,特别是涉及一种针对谈话内容的语篇规整方法和系统。
背景技术:
1、在会议、访谈、司法谈话等长时程录音通过自动语音识别(automatic speechrecognition,简写为asr)技术转换为文本后,如何利用大语言模型(large languagemodel,简写为llm)进行自动化整理,将其从非结构化、口语化的原始转录稿,处理成逻辑严密、语篇连贯、语言规范的正式书面文稿,是当前的技术热点。
2、相关技术中,上下文窗口限制与语义断裂问题。大语言模型的处理上下文长度存在物理限制。为处理超出该限制的长文本,传统方法通常采用“分块处理”或“滑动窗口”的策略,即将长文本切分成多个独立的文本块(chunk)并依次送入模型处理。这种方式虽然实现简单,但其破坏原文的整体语篇结构。由于每个文本块被独立处理,块与块之间的逻辑关联、上下文指代关系(如代词指代)以及长程语义依赖被切断,导致最终生成的各段规整文本在逻辑上可能彼此孤立,连贯性差,需要投入大量的人工后期编辑和修订工作才能形成一份可用的文稿。
3、因此,目前针对谈话内容生成的总结性内容语篇不连贯、事实不可靠、处理过程不可控的技术问题,尚未提出有效的解决方案。
技术实现思路
1、本申请实施例提供了一种针对谈话内容的语篇规整方法、系统、计算机设备和计算机可读存储介质,以至少解决相关技术中针对谈话内容生成的总结性内容语篇不连贯的问题。
2、第一方面,本申请实施例提供了一种针对谈话内容的语篇规整方法,所述方法包括:
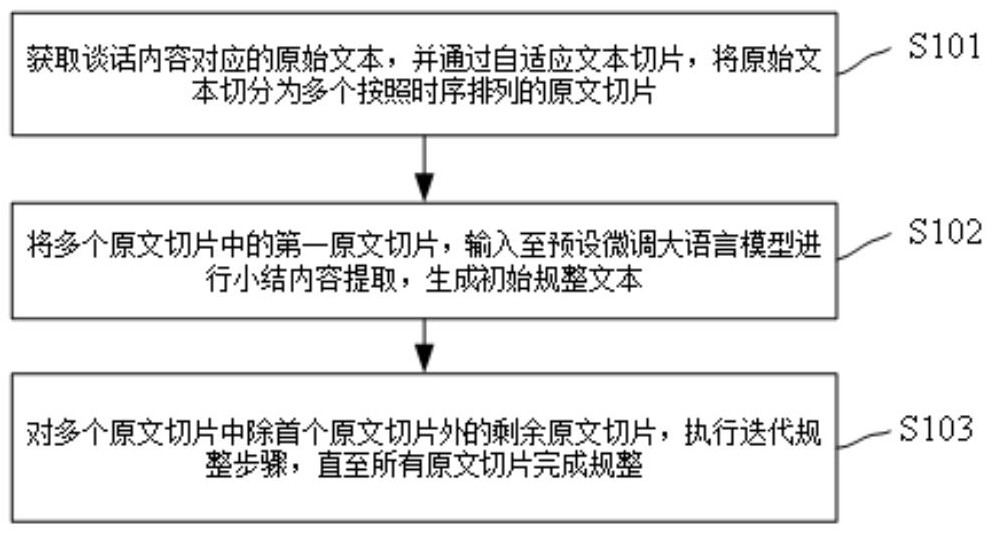
3、获取谈话内容对应的原始文本,并通过自适应文本切片,将所述原始文本切分为多个按照时序排列的原文切片;
4、将多个原文切片中的首个原文切片,输入至大语言模型进行小结内容提取,生成初始规整文本;
5、对所述多个原文切片中除首个原文切片外的剩余原文切片,执行迭代规整步骤,直至所有原文切片完成规整,所述迭代规整步骤包括:
6、通过预设段落对比大模型,基于前序规整文本与当前原文切片的语篇结构、语义逻辑进行对比分析,生成修改指令;
7、根据所述修改指令,基于所述前序规整文本和当前原文切片,还原当前待处理原文切片对应的当前规整文本。
8、在其中一些实施例中,所述预设段落对比大模型为经过领域数据微调的具备理解长程上下文结构的大语言模型,用于执行所述对比分析推理,识别与所述当前原文切片规整任务,所需基于前序规整文本中进行的修改项。
9、在其中一些实施例中,所述修改指令属于预定义的机器可读的修改指令集,所述修改指令集包括:
10、追加指令,用于添加由当前原文切片内容形成的新段落;
11、修正指令,用于修正前序规整文本中的事实错误、语病或优化语言表达;
12、插入指令,用于在特定句子之间插入补充性的上下文或解释说明;
13、合并指令,用于将逻辑关联的多个短句合并;
14、删除指令,用于删除冗余、重复和不相关的口语化表述。
15、在其中一些实施例中,还原当前待处理原文切片对应的当前规整文本,包括:
16、将前一轮迭代生成的规整文本解析为包括句子标识的结构化文本对象;
17、按顺序遍历所述修改指令集,并在所述结构化文本对象上确定性地执行所述修改指令集中的指令;
18、将所有指令执行完毕后的所述结构化文本对象,序列化为语篇连贯的所述当前规整文本。
19、在其中一些实施例中,将所述原始文本切分为多个按照时序排列的原文切片,包括:
20、利用预先提取的强边界特征,对所述原始文本进行基于规则的切分,得到多个原文切片,其中,所述强边界特征包括发言人标识符变换特征、基于asr时间戳识别的明确停顿特征和段落标记特征;
21、或者,采用轻量级序列标注模型,对所述原始文本进行标签预测,并根据预测结果确定最佳语义切分点,基于所述语义切分点将所述原始文本切分为多个原文切片,其中,所述标签包括:句首标签、句尾标签和段落边界。
22、在其中一些实施例中,所述预设段落对比大模型的训练过程包括:
23、构建微调数据集,所述微调数据集包括多个原始文本与其对应的人工规整文本的数据对;
24、针对所述数据对,通过差异对比算法,生成能够将所述原始文本,经由前述的迭代规整步骤,转换为人工规整文本的基准修改指令序列;
25、以任意一个原始文本及其对应的前序规整文本为输入,以所述基准修改指令为输出,对所述大语言模型进行监督式微调,得到所述预设段落对比大模型。
26、在其中一些实施例中,所述方法还包括:
27、基于已生成的规整文本,调整用于切分后续原始文本的切片参数;
28、其中,所述切片参数包括:每个原文切片的字数阈值、数据量和时长,以及用于过滤或替换口语化词汇的规则库。
29、第二方面,本申请实施例提供了一种针对谈话内容的语篇规整系统,所述系统包括:获取模块和规整模块,其中:
30、所述获取模块,用于获取谈话内容对应的原始文本,并通过自适应文本切片,将所述原始文本切分为多个按照时序排列的原文切片;
31、所述规整模块,用于将多个原文切片中的首个原文切片,输入至大语言模型进行小结内容提取,生成初始规整文本;
32、以及,对所述多个原文切片中除首个原文切片外的剩余原文切片,执行迭代规整步骤,直至所有原文切片完成规整,其中,所述迭代规整步骤包括:
33、通过预设段落对比大模型,基于前序规整文本与当前原文切片的语篇结构、语义逻辑进行对比分析推理,生成修改指令;
34、根据所述修改指令,基于所述前序规整文本和当前原文切片,还原当前待处理原文切片对应的当前规整文本。
35、第三方面,本申请实施例提供了一种计算机设备,包括存储器、处理器以及存储在所述存储器上并可在所述处理器上运行的计算机程序,所述处理器执行所述计算机程序时实现如上述第一方面所述的方法。
36、第四方面,本申请实施例提供了一种计算机可读存储介质,其上存储有计算机程序,该程序被处理器执行时实现如上述第一方面所述的方法。
37、相比于相关技术,本申请实施例提供的一种针对谈话内容的语篇规整方法,获取谈话内容对应的原始文本,并通过自适应文本切片,将原始文本切分为多个按照时序排列的原文切片;将多个原文切片中的首个原文切片,输入至大语言模型进行小结内容提取,生成初始规整文本;对多个原文切片中除首个原文切片外的剩余原文切片,执行迭代规整步骤,直至所有原文切片完成规整。解决了相关技术中谈话内容生成的总结性内容语篇不连贯、事实不可靠的问题。通过迭代式的预测-修正机制,将大模型的任务从自由生成转变为输出结构化的修改指令。提升了文本的全局连贯性和处理过程的可控性,实现高度自动化的文本规整,显著提升效率。
1.一种针对谈话内容的语篇规整方法,其特征在于,所述方法包括:
2.根据权利要求1所述的方法,其特征在于,所述预设段落对比大模型为经过领域数据微调的具备理解长程上下文结构的大语言模型,用于执行所述对比分析推理,识别与所述当前原文切片规整任务,所需基于前序规整文本中进行的修改项。
3.根据权利要求2所述的方法,其特征在于,所述修改指令属于预定义的机器可读的修改指令集,所述修改指令集包括:
4.根据权利要求3所述的方法,其特征在于,还原当前待处理原文切片对应的当前规整文本,包括:
5.根据权利要求1所述的方法,其特征在于,将所述原始文本切分为多个按照时序排列的原文切片,包括:
6.根据权利要求2所述的方法,其特征在于,所述预设段落对比大模型的训练过程包括:
7.根据权利要求1所述的方法,其特征在于,所述方法还包括:
8.一种针对谈话内容的语篇规整系统,其特征在于,所述系统包括:获取模块和规整模块,其中:
9.一种计算机设备,包括存储器、处理器以及存储在所述存储器上并可在所述处理器上运行的计算机程序,其特征在于,所述处理器执行所述计算机程序时实现如权利要求1至7中任一项所述的方法。
10.一种计算机可读存储介质,其上存储有计算机程序,其特征在于,该程序被处理器执行时实现如权利要求1至7中任一项所述的方法。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com