
基于大模型与动态博弈论代码化的多智能体决策方法及系统
本发明属于智能博弈,具体涉及一种基于大模型与动态博弈论代码化的多智能体决策方法及系统。
背景技术:
1、随着人工智能技术的飞速发展,多智能体系统在复杂对抗环境中的应用日益广泛,涵盖了从自动驾驶协同决策、智能电网调度到人机混合博弈等多个关键领域。特别是在面向不完全信息博弈的场景中,智能体需要在无法观测全局状态、存在隐藏信息以及其他参与者意图未知的情况下进行交互与决策。这要求智能体具备强大的逻辑推理、策略规划以及对非结构化自然语言的理解与生成能力。
2、目前,针对上述场景的智能体决策技术主要形成了三条典型的技术路径,但各自均存在显著的局限性。
3、1. 基于传统博弈论的决策方法:该类方法以反事实遗憾值最小化(counterfactual regret minimization, cfr)等算法为核心代表。其本质是一种“离线预计算,在线查表”的模式。具体实施步骤如下:首先,依赖人类专家根据游戏规则进行繁琐的人工抽象,定义所有智能体的动作空间并穷举构建确定性的收益矩阵;其次,基于预设规则构建覆盖所有可能情况的超大规模博弈树;随后,通过长时间的大规模离线迭代求解(如自我对弈),直至收敛至纳什均衡策略;最后,在实际对局中,智能体仅作为查表器,根据当前状态检索并执行预计算好的策略表中的动作。虽然这类方法在数学上具有严格的均衡性,但其极度依赖人工定义的格式化输入,无法处理自然语言交互,且博弈树的构建成本极高,一旦环境规则发生微小变动,整个模型即告失效,缺乏灵活性。
4、2. 基于纯大语言模型(llm)的决策方法:此类方法以react(reasoning andacting)、chain-of-thought(cot)等框架为代表,是当前通用人工智能领域的主流探索方向。该方法直接将博弈场景的历史信息、当前态势以及其他智能体的自然语言发言作为提示词(prompt)输入大模型,依赖模型内部蕴含的世界知识与推理能力,直接生成决策文本或动作指令。尽管纯llm方法具备了强大的语义理解能力,能够流畅地处理自然语言交互,但其决策过程本质上仍是基于语义概率的“黑箱”生成,缺乏对量化计算和严格数理逻辑的遵循。在面对需要精确计算纳什均衡、最优弃保率或概率推断的不完全信息博弈时,纯llm常出现幻觉或逻辑不一致的问题,难以保证策略的最优性与鲁棒性。
5、3. 基于llm+代码解释器的通用智能体方法:以codeact等框架为代表,这类方法试图弥补llm的计算短板,允许大模型生成代码来调用外部工具(如计算器、api、数据库)。其流程通常为:接收环境反馈、生成工具调用代码、在沙盒中执行代码获取客观结果、结合结果生成回复。然而,现有这类方法多聚焦于解决事实性问答或简单数学运算,并未针对多智能体博弈场景进行深度优化。在复杂的博弈环境中,如何从非结构化的对话中抽象出博弈模型(如识别玩家阵营、估算收益矩阵),并利用代码解释器进行博弈论求解,仍是未被有效解决的难题。
6、综上所述,现有技术方案在应对高动态、强对抗、富含自然语言交互的不完全信息博弈场景时,存在以下亟待解决的技术瓶颈:
7、第一,语义空间与符号空间的断层。 纯大模型缺乏量化计算能力,决策基于语义概率而非严格的博弈论推导;而纯博弈论方法则无法逾越自然语言的语义鸿沟。两者处于割裂状态,导致智能体要么能说不会算,要么会算不能说。例如,纯llm玩家虽能生成拟人化发言,但无法基于概率计算识破谎言;传统博弈ai虽能计算胜率,却只能读取格式化指令,无法理解玩家的自然语言欺诈。
8、第二,静态建模与动态环境的错配。传统博弈方法严重依赖人工预先定义的收益矩阵和策略空间。当环境规则发生变化或出现训练集外的突发情况时,静态模型立即失效。现有技术缺乏根据实时态势动态构建和更新博弈模型的自适应能力。
9、第三,通信与行动的割裂。 在存在欺骗和隐藏信息的博弈中,现有agent的发言往往是模仿人类语料的产物,与自身的最优行动策略脱节。发言未能作为一种“行动”被纳入统一的博弈效用函数中进行优化,导致通信内容缺乏策略性,无法实现“言行合一”的策略性信息释放。
10、因此,亟需一种能够打通语义理解与符号计算、支持动态博弈建模、并实现基于博弈最优解的智能通信决策方法,以提升多智能体在不完全信息交互场景下的整体智能水平。
技术实现思路
1、本发明提出一种基于大模型与动态博弈论代码化的多智能体决策方法及系统,可以打通语义与符号空间,由大模型动态生成博弈代码求解均衡,并以量化策略约束通信生成,实现言行合一的自适应博弈决策。
2、为实现上述目的,本发明的技术方案包括以下内容。
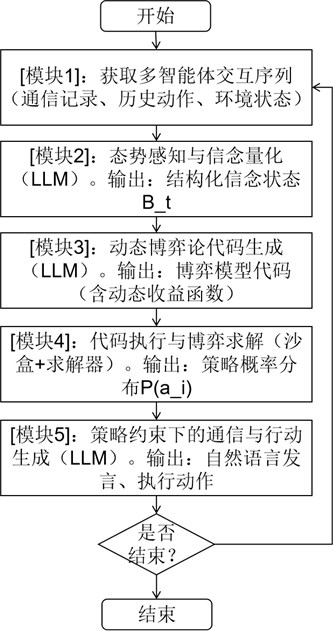
3、一种基于大模型与动态博弈论代码化的多智能体决策方法,所述方法包括:
4、针对一特定场景,采集各博弈周期中的当前环境公开状态变量、所有智能体发布的自然语言通信记录集合,以及上一博弈周期各智能体执行的显性动作集合,形成历史序列;其中,所述特定场景包括狼人杀游戏博弈场景或供应链采购博弈场景;
5、使用大模型对历史序列进行各智能体的发言动机与行动逻辑的一致性分析,生成当前博弈周期的信念状态;其中,所述信念状态为一智能体对其他智能体产生各种行为的预测概率;
6、生成博弈代码,所述博弈代码中的核心类包括参与者、策略空间和收益函数,且该策略空间定义每个参与者在当前博弈周期可执行的离散或连续动作集合,该收益函数是基于信念状态赋值的变量;
7、执行博弈代码,并获取该博弈代码在设定时间内生成的策略概率分布;
8、基于策略概率分布、当前博弈周期的信念状态和智能体的自身人设进行推理,得到该智能体在当前博弈周期中的自然语言通信记录集合与显性动作集合。
9、进一步地,在特定场景为狼人杀游戏博弈场景的情况下,所述当前环境公开状态变量基于上帝玩家宣布的其他玩家的存活状态及特殊玩家的技能状态生成,所述显性动作集合包括各智能体的夜间技能动作、白天交互动作、投票动作和特殊技能触发;
10、在特定场景为供应链采购场景的情况下,所述当前环境公开状态变量基于上一博弈周期全部智能体显性动作集合、采购标的基础参数和并行谈判架构生成,所述显性动作集合包括发函、报价调价、提出合同条款和绑定合作条件。
11、进一步地,该收益函数的构建方法包括:在博弈代码中使用if-else逻辑赋值或基于贝叶斯期望进行赋值。
12、进一步地,执行博弈代码,包括:
13、将博弈代码注入沙盒环境;
14、使博弈代码在沙盒环境中自动调用内置的博弈论求解库,以将博弈代码中的博弈问题转化为数学优化模型;
15、求解器根据博弈代码中定义的参与者、策略空间和收益函数对数学优化模型执行数值迭代、寻优、均衡求解,得到策略概率分布。
16、进一步地,基于策略概率分布、当前博弈周期的信念状态和智能体的自身人设进行推理,得到该智能体在当前博弈周期中的自然语言通信记录集合与显性动作集合,包括:
17、将求解得到的策略概率分布转换为自然语言的策略指令;
18、将该策略指令、当前博弈周期的信念状态以及智能体自身人设打包,作为提示词;
19、大模型基于该提示词,生成该智能体在当前博弈周期中的自然语言通信记录集合与显性动作集合。
20、进一步地,所述方法还包括:
21、在设定时间内未生成策略概率分布的情况下,基于当前博弈周期的信念状态和智能体的自身人设进行推理,得到该智能体在当前博弈周期中的自然语言通信记录集合与显性动作集合。
22、一种基于大模型与动态博弈论代码化的多智能体决策系统,所述系统包括:
23、数据采集模块,用于针对一特定场景,采集各博弈周期中的当前环境公开状态变量、所有智能体发布的自然语言通信记录集合,以及上一博弈周期各智能体执行的显性动作集合,形成历史序列;其中,所述特定场景包括狼人杀游戏博弈场景或供应链采购博弈场景;
24、信念生成模块,用于使用大模型对历史序列进行各智能体的发言动机与行动逻辑的一致性分析,生成当前博弈周期的信念状态;其中,所述信念状态为一智能体对其他智能体产生各种行为的预测概率;
25、代码生成模块,用于生成博弈代码,所述博弈代码中的核心类包括参与者、策略空间和收益函数,且该策略空间定义每个参与者在当前博弈周期可执行的离散或连续动作集合,该收益函数是基于信念状态赋值的变量;
26、代码执行模块,用于执行博弈代码,并获取该博弈代码在设定时间内生成的策略概率分布;
27、推理模块,用于基于策略概率分布、当前博弈周期的信念状态和智能体的自身人设进行推理,得到该智能体在当前博弈周期中的自然语言通信记录集合与显性动作集合。
28、一种计算机设备,所述计算机设备包括:处理器以及存储有计算机程序指令的存储器;所述处理器执行所述计算机程序指令时实现上述任一项所述的基于大模型与动态博弈论代码化的多智能体决策方法。
29、一种计算机可读存储介质,所述计算机可读存储介质上存储有计算机程序指令,所述计算机程序指令被处理器执行时实现上述任一项所述的基于大模型与动态博弈论代码化的多智能体决策方法。
30、一种计算机程序产品,当所述计算机程序产品在计算机设备上运行时,使得计算机设备执行上述任一项所述的基于大模型与动态博弈论代码化的多智能体决策方法。
31、与现有技术相比,本发明至少具有以下有益效果。
32、1)态势的信念量化转换机制,打通了语义空间到符号空间的壁垒,极大降低了高阶信念推理的复杂度,消除大模型的逻辑漂移。在不完全信息博弈中,智能体面临的核心难题是“高阶信念推理”(即:我认为你认为我认为......)。纯llm在自然语言空间中处理这种推理时,随着对话轮次增加,注意力机制极易分散,导致严重的逻辑漂移与幻觉。本发明通过信念量化机制,强制llm将模糊的自然语言线索压缩为确定性的概率分布(如json格式的阵营概率),实质上是将无限维的语义推理空间降维到有限的概率向量空间,阻断了误差的指数级积累,为后续的严密数学计算奠定了基础。
33、2)博弈模型的动态代码生成机制,突破了传统博弈论依赖静态人工建模的局限,实现了博弈模型的零代码动态自适应构建,赋予智能体开放环境下的泛化决策能力。传统博弈论ai的致命缺陷在于其静态性,即收益矩阵必须由领域专家预先定义,一旦环境规则或对手策略偏离预设,模型即刻失效。现有的llm+代码框架虽能生成代码,但仅用于查询客观事实,从未用于构建主观认知模型。本发明创造性地将llm作为“博弈建模器”,使其能够根据实时信念动态编写包含策略空间和收益函数的博弈代码。由于代码是由llm即时生成的,收益函数不再是常量,而是信念概率的函数(如:期望收益=信念概率条件收益),从而实现了博弈模型随交互态势实时重构。
34、3)基于均衡解的策略约束生成机制,实现了“计算引导发言”,确保自然语言通信具有严密的策略意图,大幅提升智能体在对抗环境中的胜率与反欺骗能力。在存在利益冲突的博弈中,“说什么”本身就是一种策略行动。纯llm生成的发言往往只是语料库中“看起来像人话”的统计学高频组合,缺乏深层的博弈最优性考量,极易被对手识破或诱导。本发明将博弈求解器输出的量化策略分布(如纳什均衡解)作为硬性约束注入llm,迫使llm的文本生成过程服务于数学上的最优策略。这使得智能体的发言不再是“自说自话”,而是经过收益计算后的“精确武器”,实现了从“模仿学习”到“博弈最优决策”的质变。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com