
一种基于改进YOLOv8的安格斯牛面部识别方法
本发明涉及生物识别。具体地说是一种基于改进yolov8的安格斯牛面部识别方法。
背景技术:
1、传统的牛只识别方法通常涉及对身体部位进行标识,如耳切口、耳纹、热烙铁印和耳标,然而这些方法会对动物身体造成伤害,并且随着时间的流逝可能会发生变化或被移除。射频识别(rfid)电子耳标成为一种备受关注的识别技术,其具有快速识别和高准确率的优点。然而,高昂的成本和数据安全问题限制了其在实际应用中的范围。因此,寻找一种低成本、无损伤且可靠的牛脸识别方法变得尤为重要。
2、由于成本低廉且图像获取设备简单便捷,许多国内外学者开始将诸如ssd、yolo等目标检测方法应用于畜禽个体识别的研究中。他们利用这些方法进行了相关的探索和实验。例如huang用ssd来对奶牛身体状况进行评分,李广博用yolov5s对猪脸进行识别。
3、安格斯牛的毛色通常为单一的全黑或全红,缺乏显眼的标记或花纹,导致即便是不同的个体在视觉上也极为相似。而在牧场或农场等环境中,安格斯牛的这种单色特征可能与周围的土地或其他背景元素产生混淆,进一步增加了检测和分类的难度,导致,ssd、yolov5n以及yolov8在识别过程中存在漏检现象,准确率降低。
技术实现思路
1、为此,本发明所要解决的技术问题在于提供一种基于改进yolov8的安格斯牛面部识别方法,改进的yolov8模型加强对安格斯牛面部特征提取的能力,提高对安格斯牛个体的识别准确性。
2、为解决上述技术问题,本发明提供如下技术方案:
3、一种基于改进yolov8的安格斯牛面部识别方法,包括如下步骤:
4、(1)采集安格斯牛的面部图像数据;
5、(2)对安格斯牛的面部图像数据进行处理,获得增强的面部图像数据;
6、(3)改造yolov8n模型,获得改进的yolov8n模型;
7、(4)利用改进的yolov8n模型对增强的面部图像数据进行识别;
8、(5)评估改进的yolov8n模型的性能。
9、上述一种基于改进yolov8的安格斯牛面部识别方法,在步骤(1)中,用相机采集安格斯牛的头部图像,包括不同的场景、光照条件、拍摄角度、拍摄距离以及遮挡情况;头部图像的分辨率为6000像素×4000像素。
10、上述一种基于改进yolov8的安格斯牛面部识别方法,在步骤(2)中,包括:
11、(2-1)对拍摄的安格斯牛面部图像进行筛选和处理,剔除遮挡和相似度较高的图像,并采用labelme软件进行精确标注,框选时不能包含耳标;
12、(2-2)训练过程中利用albumentations库对安格斯牛的面部图像数据进行在线数据增强,包括安格斯牛的面部图像的灰度处理、直方图均衡化、高斯噪声及高斯模糊。
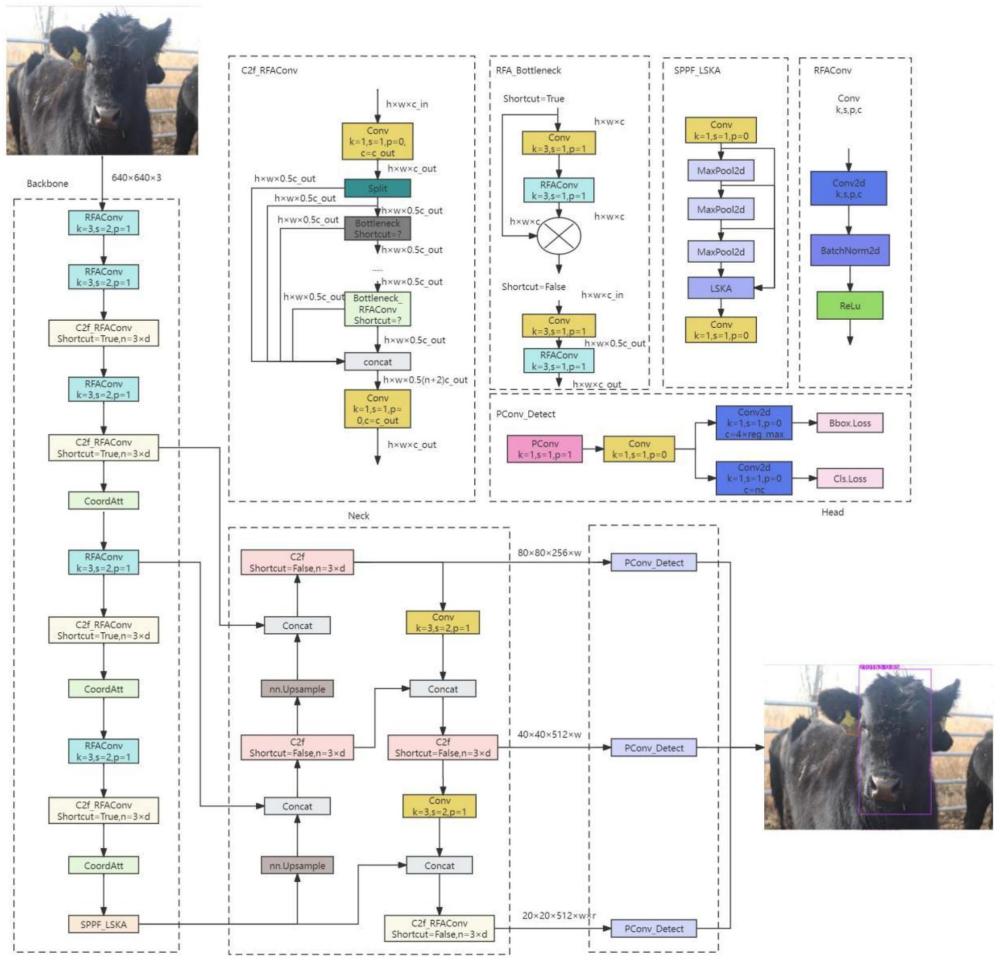
13、上述一种基于改进yolov8的安格斯牛面部识别方法,在步骤(3)中,包括对主干backbone的改进和对头部head的改进。
14、主干backbone的改进中包括:
15、(3-1)将主干中的标准卷积层conv全部替换成感受野注意力卷积rfaconv;
16、(3-2)将残差块结构bottleneck的标准卷积层conv替换成扩展感受野的卷积层rfaconv,创建新的模块rfa_bottleneck;然后将模块rfa_bottleneck应用于特征融合模块c2f中原有的bottleneck,推导出经过改良的特征融合模块c2f_rfaconv;然后将改良的特征融合模块c2f_rfaconv替换主干中原始的c2f模块;
17、(3-3)在主干中,加入注意力机制ca;注意力机制ca提高对图像中不同区域的关注,改善物体定位。加强模型对关键特征的识别能力,提升分类准确性。使模型更自适应复杂场景,无需人为设定关注点。在不增加过多复杂度的情况下,提升检测不同尺寸物体的性能。
18、(3-4)在主干中,金字塔池化层sppr中嵌入lska注意力机制,得到新型的金字塔池化层sppf_lska模块;
19、对检测头head的改进为:
20、(3-5)在每个检测头内植入一个1×1的部分卷积pconv与一个1×1的标准卷积conv,获得pconv_detect检测模型,用pconv_detect检测模型替换标准检测组件detect。
21、上述一种基于改进yolov8的安格斯牛面部识别方法,rfa感受野注意力机制的计算表示为:
22、
23、gi×i表示分组卷积,k表示卷积核的大小,g1×1表示卷积核为1×1的分组卷积;gk×k表示卷积核为k×k的分组卷积;norm代表规范化,x表示输入特征图;avgpool表示平均池化;softmax和relu为激活函数
24、f是通过将注意力图与变换的感受野空间特征相乘而获得的;
25、arf表示注意力图特征;frf表示变换的感受野空间特征。
26、上述一种基于改进yolov8的安格斯牛面部识别方法,注意力机制ca分解为两个沿着不同方向聚合特征的一维特征编码过程;
27、给定输入x首先使用尺寸为(h,1)或(1,w)的pooling kernel分别沿着水平坐标和垂直坐标对每个通道进行编码,高度为h,宽度为w的第c通道的输出分别表示为下式:
28、
29、
30、其中:为高度为h的第c通道的输出;宽度为w的第c通道的输出、xc是第c通道输入的特征图,即神经网络中前一层输出的每一个特征通道的数据集合;h和w分别表示特征图的高度和宽度;i代表宽度,范围为0到w,j代表高度,范围为0到h;h和w分别表示的是池化内核的尺寸,h指的是沿垂直坐标的内核尺寸,w则指的是沿水平坐标的内核尺寸;
31、h和w是选择进行池化操作时由用户定义的参数。例如,如果有一个池化内核尺寸为(h,1),它意味着这个内核将会覆盖垂直方向上h个像素,而在水平方向上它只覆盖单个像素。同样,尺寸为(1,w)的内核将会覆盖水平方向上w个像素而在垂直方向上它只覆盖单个像素。这样的池化操作设计用来分别在水平或垂直方向上对特征进行池化编码。每个通道被单独处理,都有自己的输出,高度为h,宽度为w的第c通道的输出是通过在该通道上执行相应的池化操作获得的。
32、池化核(pool kernel)的大小为(h,1)表示在每个通道上沿垂直方向(高度)应用高度为h的池化操作,宽度保持为1,这样就可以压缩高度,而保留宽度方向的信息,得到一个宽度方向的特征向量。池化核的大小为(1,w)指的是在每个通道上沿水平方向(宽度)应用宽度为w的池化操作,高度保持为1,从而压缩宽度,但保留高度方向的信息,得到一个高度方向的特征向量。i和j代表为1的宽度和高度。
33、这两种变换分别在两个空间维度上聚合特征,生成一对具有方向感知能力的特征图;
34、通过信息嵌入中的变换后,该部分将上面的变换进行concatenate操作,然后使用1×1卷积变换函数f1对其进行变换操作:
35、f=δ(f1([zh,zw]))。 (4);
36、然后沿着空间维数将f分解为2个单独的张量fh∈rc/r×h和fw∈rc/r×w;δ为卷积变换函数;f代表特征的张量,包含了模型对输入数据提取的特定特征信息;zh表示高度为h的输出,zw表示宽度为w的输出;c为通道数;r为缩减因子,r为实数;fh和fw分别代表经过1×1卷积变换后的特征张量在水平方向和垂直方向上的两个单独张量;
37、利用另外2个1×1卷积变换fh和fw分别将fh和fw变换为具有相同通道数的张量到输入x,得到:
38、
39、
40、在公式中,利用sigmoid激活函数并且,通过选择适当的缩减比率,降低通道数量,减少模型的计算量和复杂性;然后进行扩展操作,并将结果作为注意力权重;以下公式表示输出:
41、
42、xc(i,j)表示原始的输入特征图,是来自网络中前一层的输出,yc(i,j)表示特征输出;表示经过ca模块处理后得到的水平方向的注意力向量表示经过ca模块处理后得到的垂直方向的注意力向量。
43、信息嵌入中的变换指的就是怎样通过学习得到这样方向感知的特征表达,并将其融合或映射到适合模型学习的新特征空间,提高了模型对特定空间信息的响应能力。
44、concatenate是指将这两个输出在某个维度上进行拼接,融合成一个新的张量,使得这个新的张量包含了来自公式(4)和公式(5)输出的信息。
45、卷积变换函数是指在卷积神经网络中用来从输入数据中提取特征的操作,通过卷积核与输入数据的卷积运算来生成输出特征图,帮助神经网络学习有效特征表示。
46、上述一种基于改进yolov8的安格斯牛面部识别方法,lska首先将一个大的二维核拆分为两个独立的一维核,这两个核分别负责水平和垂直的卷积操作:
47、
48、
49、ac=w1×1*zc (10);
50、
51、lska使用了1×1卷积的普通二维大内核深度可分离卷积dw-conv和扩张深度可分离卷积dw-d-conv,给定一个输入特征图f,其中c是输入通道数,h和w分别表示特征图的高度和宽度,表示深度可分离卷积的输出,其核大小为(2d-1)×(2d-1),zc表示扩张深度可分离卷积的输出,扩张深度卷积的核大小为k代表核的最大感受野;d是扩张率;公式(8)和(9)所示,通过将深度可分离卷积和扩张深度可分离卷积的二维权核拆分为两个级联的一维可分离权核;然后使用1×1的卷积核进行卷积以获得注意力图ac,输出是注意力图ac和输入特征图fc的哈达玛积;
52、金字塔池化层sppr中的三个maxpool2d后嵌入lska注意力机制,得到新型的金字塔池化层sppf_lska模块。
53、深度可分离卷积通过独立对输入通道进行空间卷积再线性组合得到输出,输出特征图深度与输入相同;而扩张深度可分离卷积在此基础上引入扩张率,扩大卷积核的感知野,输出的特征图在空间维度会有所改变,有助于提高网络在捕捉长距离信息和全局结构上的性能。
54、上述一种基于改进yolov8的安格斯牛面部识别方法,部分卷积pconv策略性地选取第一个或最后一个连续通道作为整个特征图的代表进行计算:
55、
56、
57、h为高度,w为宽度,cp为输入特征图的通道数,k为卷积核的大小;
58、pconv_detect检测头模型为在每个检测头内植入一个1×1的部分卷积pconv与一个1×1的标准卷积conv,取代了过往配置中的四个3×3标准卷积。
59、上述一种基于改进yolov8的安格斯牛面部识别方法,在步骤(4)中,改进的yolov8n模型中:选取尺寸为640×640的图像作为输入,迭代周期epoch设置为300,批量大小设置为4,选择随机梯度下降法作为训练优化方法,初始学习率为0.01,动量因子为0.937,权重衰减系数0.0005。
60、上述一种基于改进yolov8的安格斯牛面部识别方法,在步骤(5)中,采用召回率r、平均精度均值map、分类损失cls_loss、定位损失dfl_loss、模型内存占用量和模型计算量对改进的yolov8n模型进行性能评估。
61、本发明的技术方案取得了如下有益的技术效果:
62、1、为了解决安格斯牛面部特征相对单一,导致个体识别难度较大的问题,本研究提出了一种更加精确的个体识别方法。该方法基于改进的yolov8n模型,通过无接触方式对圈养环境中的安格斯牛面部图像进行识别。首先,构建了一个大型数据集,包含109头安格斯牛在不同生长阶段的面部图像,共计7000幅。数据集按照9:1的比例划分为训练集和测试集,确保模型的泛化能力。
63、在模型改进方面,将rfa感受野注意力模块与ca坐标注意力模块相结合,提高了模型对特征的关注度。同时,对主干特征提取网络中的sppf模块进行改进,引入lska大型核可分离卷积注意力机制,增强了模型对细微特征的捕捉能力。
64、此外,在模型头部设计中,我们提出了一种新型的轻量化检测头pconv_detect,针对安格斯牛面部特征进行优化。实验结果表明,改进后的模型在平均精度均值方面达到了92.6%的高水准,相较于ssd、yolov5n、yolov8s、yolov8m等常用模型,分别提高了11.5%、3.8%、1.8%、1.9%的识别精度。
65、与原始的yolov8n模型相比,改进模型在精度上提高了3.1%。此外,改进模型在内存占用和计算量方面实现了轻量化。该模型仅占用5.72mb内存资源相较于原模型下降14%,计算量仅为6.4glops对比原模型下降33.3%,为实际应用中的实时识别提供了良好的性能。
66、2、在本研究中,为了增强yolov8n模型的能力,对yolov8n模型进行了一系列结构上的改进。模型主干采用感受野自适应卷积(receptive-field attention,rfaconv)替代标准卷积conv;进一步地,独创了一个名为c2f_rfaconv的模块来更有效地捕获多尺度的特征信息。此外,在模型主干中加入了坐标注意力(coordinate attention,ca)模块以增强对关键特征的识别。同时创新了一个新的金字塔池化sppf_lska,提升了特征提取的精细度。检测头部分我提出了一种新型的轻量化检测头pconv_detect,在做到轻量化的同时提升了模型的精度。这些优化强化了模型对视觉模式的解析力,确保了准确率和鲁棒性在计算效率允许的范围内的提升。
67、3、改进后的模型在性能评估中展现了出色的成果,召回率、map50和map50-95分别达到了85.1%、92.6%以及68.3%,这些指标远远超出了ssd、yolov5n、yolov8n、yolov8s和yolov8m模型的表现。此外,模型仅需5.72mb的内存和6.4glops的计算量,这比原始模型的要求低得多,实现了模型的轻量化,同时还大幅度提升了精度。这使得该模型易于移植和快速部署,为智能养殖环境下安格斯牛的精确个体管理提供了有力的技术支持和参考。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com