
基于NLP与知识图谱技术的热点新品量化分析方法与流程
本发明属于量化分析领域,尤其是涉及基于nlp与知识图谱技术的热点新品量化分析方法。
背景技术:
1、现有市场研究与新品洞察通常依赖问卷调研、传统统计软件、网络爬虫或者第三方报告实施。该类方法大多采用手工或半自动化数据处理流程,在多源数据融合、产品属性细粒度识别、创新产品发现、分析响应速度以及智能分析可信度等方面存在不足。
2、现有数据通常分散在产品图像系统、业务数据库、消费者购物数据库、用户标签数据库、互联网公开数据系统等不同的数据源中,缺少统一的数据关联与处理机制,难以形成产品图像、产品属性、购物行为和消费者画像之间的关联数据。产品图像、产品文本、购买量、销售额、购买渠道、购买地点、年龄层、家庭人口和消费偏好等数据的存储形式不同,导致后续分析存在数据孤岛。
3、现有产品字典的属性颗粒度通常较粗,难以对产品的口味风味、原材料、主要成分、品种产地、工艺形态、包装形态、功效宣称以及健康概念进行细粒度识别。例如,针对草莓味产品,传统产品字典通常仅保留“草莓”这一属性,而难以进一步识别红颜草莓、淡雪草莓、丹东九九草莓等细分品种信息。现有ocr识别和关键词识别技术主要用于提取文字或识别关键词,缺少面向垂直行业的语义解析、同义词归并、别称修正、歧义消除和知识关联能力。
4、同时,传统统计模型通常基于预先定义的指标和既有分类体系开展分析,难以从持续增长的产品文本、广告文本和产品图像中自动捕捉新口味、新成分、新概念、新包装形态和新视觉风格等非线性市场信号。现有全文检索主要依赖关键词匹配,向量检索虽能实现语义相似搜索,但缺乏与知识图谱、全文检索、量化指标计算和大语言模型推理的协同处理机制。
5、此外,现有分析流程往往由多个相互独立的系统分别完成数据采集、数据清洗、文本识别、图像识别、检索、统计分析和报告生成,数据处理链路较长,难以按照预设周期完成从底层数据更新到分析报告更新的自动化闭环。直接采用大语言模型生成分析结果时,如未向大语言模型提供经检索获得的结构化数据和知识图谱数据,生成内容的分析依据和可信度难以保证。
技术实现思路
1、有鉴于此,本发明旨在提出基于nlp与知识图谱技术的热点新品量化分析方法,以期解决上述部分技术问题中的至少之一。
2、为达到上述目的,本发明的技术方案是这样实现的:
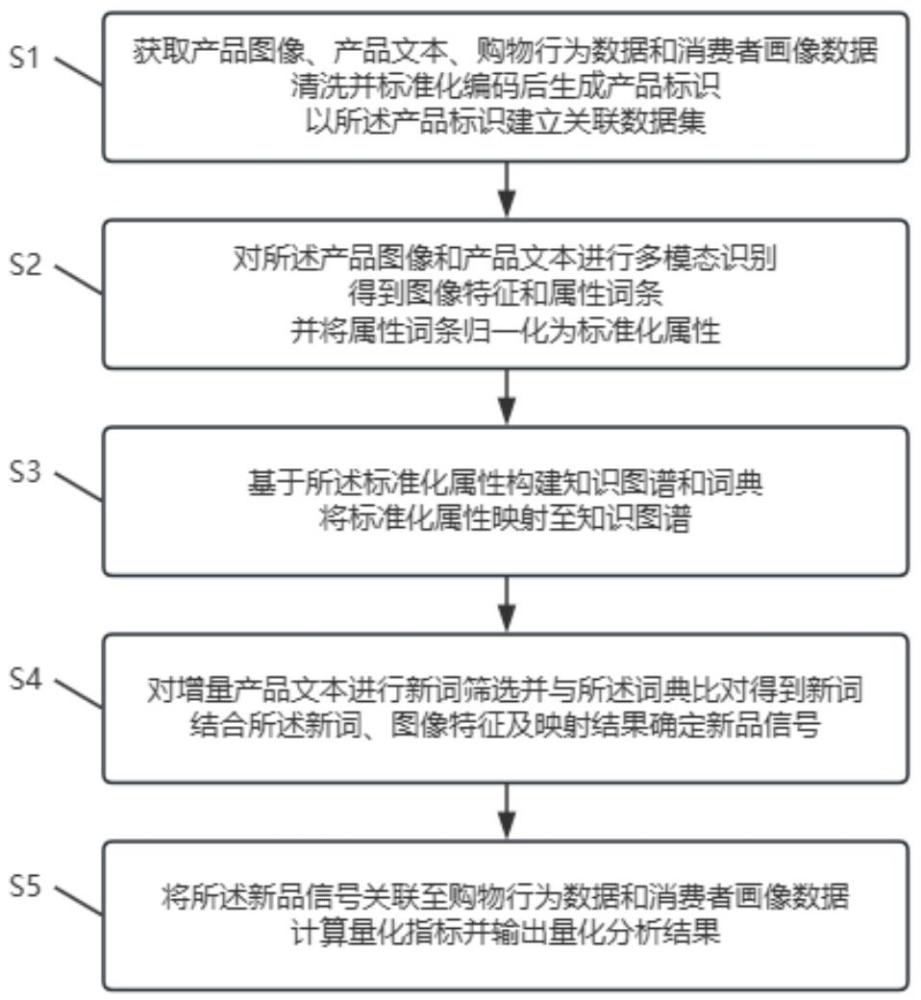
3、基于nlp与知识图谱技术的热点新品量化分析方法,包括:
4、获取产品图像、产品文本、购物行为数据和消费者画像数据,清洗并标准化编码后生成产品标识,以所述产品标识建立关联数据集;
5、对所述产品图像和产品文本进行多模态识别,得到图像特征和属性词条,并将属性词条归一化为标准化属性;
6、基于所述标准化属性构建知识图谱和词典,将标准化属性映射至知识图谱;
7、对增量产品文本进行新词筛选并与所述词典比对得到新词,结合所述新词、图像特征、知识图谱映射结果确定新品信号;
8、将所述新品信号关联至购物行为数据和消费者画像数据,计算量化指标并输出量化分析结果。
9、进一步的,所述生成产品标识并建立关联数据集,包括:
10、对清洗和标准化编码后的产品图像、产品文本、购物行为数据及消费者画像数据生成对应的产品标识;
11、依据相同的产品标识建立产品图像、产品属性、购物行为和消费者画像之间的关联关系。
12、进一步的,所述多模态识别包括:
13、对产品图像实施文字识别以获得包装文字信息;
14、对产品图像实施目标检测和图像特征提取以获得包装形态及视觉特征;
15、将所述产品图像映射为图像向量,并基于所述图像向量进行相似图像检索,获得相似产品图像;
16、基于所述包装文字信息、包装形态、视觉特征和图像向量提取图像特征及属性词条。
17、进一步的,所述将属性词条归一化为标准化属性,包括:
18、基于历史产品文本计算候选词组的点互信息值,将满足条件的候选词组加入基础分词词典;
19、将产品字典和历史复核词条加入所述基础分词词典,得到行业词典;
20、利用所述行业词典对产品文本进行分词,并通过序列标注模型校验分词边界,得到属性词条;
21、将所述属性词条按照原始词、标准词、属性大类和属性小类的对应关系进行归一化,得到标准化属性。
22、进一步的,所述构建知识图谱和将标准化属性映射至知识图谱,包括:
23、建立由属性大类、属性小类和具体关键词构成的层级本体;
24、将所述标准化属性与具体关键词进行匹配,并在未匹配到具体关键词时,依据字符串相似度或语义向量相似度确定对应的具体关键词;
25、根据所述层级本体将对应的具体关键词逐级归并至属性小类和属性大类;
26、依据产品所属品类确定具有相同词形的标准化属性对应的知识图谱节点。
27、进一步的,所述对增量产品文本进行新词筛选,包括:
28、对预设时间窗口内的增量产品文本进行n-gram切分,得到候选词串;
29、计算各候选词串的词频逆得分、关键词长度得分、词频-逆文档频率得分和点互信息得分;
30、基于各得分确定候选新词;
31、将所述候选新词与词典中的词条比对,将未存在于词典中的候选新词确定为新词。
32、进一步的,所述确定新品信号包括:
33、将新词关联至对应的产品标识;
34、确定新词与产品品牌、产品属性词条及广告文本之间的共现关系;
35、将所述共现关系与所述产品标识对应的图像特征、知识图谱映射结果进行联合判定,得到新品信号;
36、将新品信号中的新词及其知识图谱映射关系写入词典和知识图谱。
37、进一步的,所述计算量化指标包括:
38、以知识图谱中的属性关键词为分组键,对关联至所述属性关键词的购物行为数据进行聚合,得到sku体量、购买量和销售额;
39、根据购买所述属性关键词对应产品的用户数和所属品类的用户总数计算渗透率;
40、根据当前时间窗口的销售额和上一时间窗口的销售额计算增速。
41、进一步的,所述计算量化指标还包括:
42、基于新词标记分、增速归一化值和关键词长度权重分加权计算属性关键词的新颖度评分;
43、根据属性关键词在多个时间窗口内的提及频次构建时间序列并进行趋势预测;
44、以sku关联的属性关键词构建项集,基于所述项集和销售额确定频繁项集及关联规则。
45、进一步的,还包括:
46、接收查询条件,基于所述查询条件对知识图谱中的标准化属性、图像特征和量化分析结果进行全文检索和向量检索,得到检索结果;
47、将所述检索结果作为上下文输入大语言模型,生成市场洞察报告;
48、按照预设周期重新执行数据获取、多模态识别、知识图谱更新、新词筛选、新品信号确定及量化指标计算,并更新所述市场洞察报告。
49、相对于现有技术,本发明具有以下有益效果:
50、1、通过产品标识将产品图像、产品文本、购物行为数据及消费者画像数据进行关联,形成产品属性、购物行为和消费者画像之间的关联数据基础;
51、2、通过ocr文字识别、目标检测、图像特征提取、图像向量化和文本语义解析,获得包装文字、包装形态、视觉特征及细粒度属性词条;
52、3、通过行业词典、序列标注模型、语义归一化和知识图谱层级映射,实现产品属性从原始词到标准词、属性小类及属性大类的统一处理;
53、4、通过增量文本中的新词筛选、词典比对、图像特征分析和知识图谱映射,构建融合文本新词发现与视觉新特征匹配的双路新品检测机制,自动发现产品市场中出现的新词和新品信号;
54、5、通过将新品信号与购物行为数据、消费者画像数据关联,计算sku体量、购买量、销售额、渗透率、增速和新颖度评分等量化指标;
55、6、通过全文检索、向量检索和检索增强生成,为大语言模型提供与查询条件对应的结构化数据、图像特征和知识图谱数据,以生成市场洞察报告;
56、7、通过预设周期的数据更新机制,形成数据更新、多模态处理、知识图谱更新、新词发现、量化指标重算以及报告更新的自动化流程。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com