
一种长文本生成方法及装置与流程
本技术涉及人工智能(artificial intelligence,ai),尤其涉及一种长文本生成方法及装置。
背景技术:
1、网络搜索引擎是设计在万维网上进行搜索,意思是指自动从万维网搜集特定的信息,提供给用户进行查询的系统。传统搜索引擎的搜索结果通常会以行列式的链接展示。这些消息链接可能是连至网页、图像、影片、信息图表、文章、研究论文或其他类型的文件。通常搜索引擎会在这些链接下提供一小段来自这些网页的摘要信息,以帮助用户自行判断此网页是否含有自己需要的内容。然而,网络搜索引擎每天有100亿次搜索查询,但据微软研究发现其中约一半没有得到用户满意的答复。它对于查找特定的网站来说非常有用,但对于用户更复杂的问题或辅助决策来说,它经常表现不佳。随着大语言模型(large languagemodel,llm)如gpt4的新突破,我们可以迭代搜索引擎的功能。借助基础大语言模型,新型生成式搜索引擎(例如微软的copilot,谷歌的gemini)可以回答全新类型的问题,并改变信息的组织方式,以帮助用户更好地整理调研相关信息,辅助决策。考虑问题“请比较一下问界m7,理想l7和蔚来es7,并提供购买建议”。通常人类会将这问题分解为较小的问题并进行搜索,对大量搜索回来的信息进行分类,然后自己将信息整合起来。借助大语言模型,它可以帮助用户完成这些繁重的工作,生成信息量丰富的长文报告,辅助用户了解全貌,更快更轻松地进行决策。
2、但是现有的基于大语言模型的知识长文生成方案存在着一些问题,例如生成时延较长,或生成的长文本质量较低等问题。
技术实现思路
1、本技术的实施例提供一种长文本生成方法及装置,可以实现在保证长文本生成质量的基础上,降低长文本生成时延,兼顾生成长文的质量和时延要求。
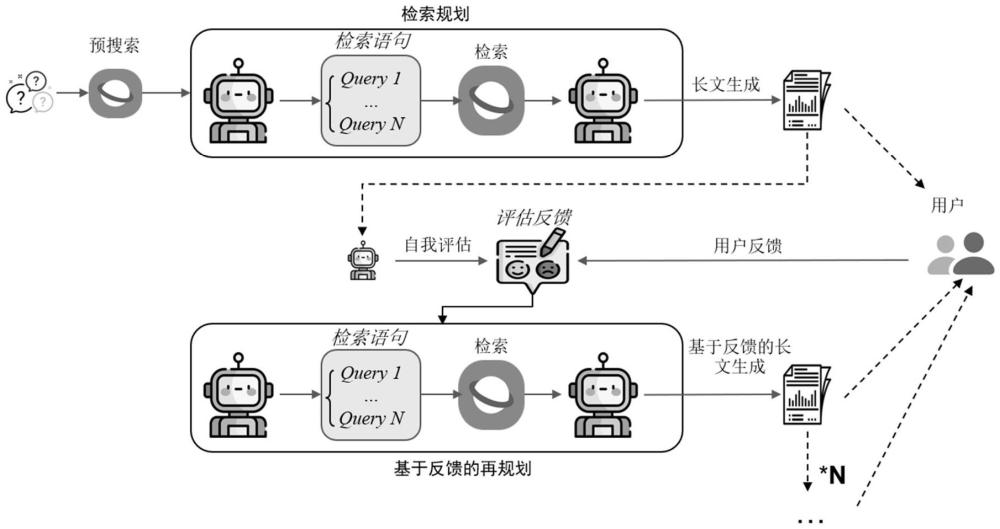
2、第一方面,本技术提供了一种长文本生成方法,包括获取查询文本;基于查询文本进行贪心式的检索规划,得到检索规划结果,检索规划结果为用于并行检索的多个检索语句;基于多个检索语句进行检索,得到相关信息,相关信息为与本次查询任务相关的信息;基于查询文本和相关信息,生成查询文本所对应的长文本应答。
3、本技术提供的长文本生成方法,采用贪心式的检索规划,是一种启发式方法,即尽可能的在一次并行搜索的机会下尽可能的收集当前查询需要的相关信息,而不考虑该选择对未来步骤的潜在影响,使得检索到与当前查询任务的相关信息尽可能的完备,然后利用检索到的相关信息一次生成完整的长文应答,如此减少生成过程中触发检索的次数,降低长文生成的时延,以及通过检索到的尽可能完备的相关信息生成长文,保证了长文生成的质量。
4、在一个可能的实现中,贪心式的检索规划的任务目标为:期望通过一轮检索得到支持完成长文本应答生成任务的相关信息。
5、相较于现有技术中通常将长文本生成任务拆解成多个子任务,检索规划时以子任务为目标,每次检索规划仅规划检索到完成一个子任务所需的检索文档,需要多轮检索才能检索到长文本生成任务所需的检索文档;本技术通过将检索规划目标优化调整为:以期望通过一轮检索得到支持完成长文本应答生成任务的相关信息,如此支持后续步骤以一轮检索得到的相关信息作为参考信息生成完整的长文本应答,无需进行多轮检索,有效降低长文本生成的时延。
6、在一个可能的实现中,基于查询文本进行贪心式的检索规划,得到检索规划结果的一种具体实现为:基于查询文本和背景知识进行贪心式的检索规划,得到检索规划结果,背景知识包括基于查询文本进行预检索得到的检索内容。
7、例如,在用户输入问题(即查询文本)后,先根据用户输入的文本进行预检索,比如根据用户输入的问题在常规搜索引擎上进行搜索得到的检索结果作为背景知识,然后利用背景知识进行贪心式的检索规划,有助于规划到更相关的检索语句。
8、在另一个可能的实现中,基于查询文本和背景知识进行贪心式的检索规划,得到检索规划结果的一种具体实现为:将查询文本和背景知识输入至第一大语言模型,以使第一大语言模型对查询文本进行问题分解,得到多个子问题;将多个子问题输入至第二大语言模型,以使第二大语言模型为多个子问题生成多个检索语句。
9、即将结合用户原问题搜索得到的检索结果作为背景知识,和用户问题一起输入大语言模型,基于大模型理解用户问题意图,并针对问题的复杂度,将用户问题分解为不同数量的更为简单的子问题,便于后续检索语句的生成;然后利用大语言模型对每一个分解的子问题生成对应便于检索的检索语句,多个检索语句可以并行检索,以便于在后续步骤中所有生成的检索语句并行检索得到检索文档,进一步降低整个长文生成的时延。
10、在另一个可能的实现中,基于查询文本和相关信息,生成查询文本所对应的长文本应答的一种具体实现为:将查询文本和相关信息作为第三大语言模型的输入,输出长文本应答。
11、第三大语言模型利用查询文本和贪心式检索规划检索到的相关信息,一次生成完整的长文应答,使得生成的长文本应答具有较好的一致性。
12、在另一个可能的实现中,相关信息包括基于多个检索语句检索得到的多个检索文档;将查询文本和相关信息作为第三大语言模型的输入,输出长文本应答的一种具体实现为:基于查询文本和多个检索文档,生成提示,该提示指示大语言模型基于多个检索文档为查询文本生成长文本应答。
13、在另一个可能的实现中,本技术提供的长文本生成方法还包括:对长文本应答进行评估,得到评估反馈信息;基于评估反馈信息,再次进行贪心式的检索规划,更新检索规划结果;基于更新后的检索规划结果进行检索,更新相关信息;基于查询文本、更新后的相关信息、评估反馈信息和长文本应答,更新长文本应答;经过若干轮次迭代,得到最终的长文本应答。
14、通过在多轮迭代中,基于针对上一轮生成的长文的评估反馈进一步规划检索语句以及检索补充相关信息,然后基于上一轮生成的长文、再规划收集的相关信息以及评估反馈信息生成新的长文本应答,改进上一轮生成的长文本应答中存在的问题,对上一轮生成的长文本应答进行优化,提高长文本应答的质量。
15、在另一个可能的实现中,评估反馈信息包括自我评估反馈信息;对长文本应答进行评估,得到评估反馈信息的一种具体实现为:将查询文本和长文本应答输入至第四大语言模型,以使第四大语言模型从至少一个维度对长文本应答进行评估,得到自我评估反馈信息。
16、利用大语言模型对上一轮生成的长文本应答从至少一个维度进行自我评估,发现当前轮次生成的长文本应答存在的问题,以便于在下一轮迭代中根据这些问题对长文本应答进行改进,提高长文本应答的质量。
17、在另一个可能的实现中,至少一个维度包括相关性维度、信息广度维度、信息深度维度和一致性维度中的一个或多个维度,如此通过多个维度的自我评估,尽可能全面的发现上一轮所生成的长文本应答存在的问题。
18、在另一个可能的实现中,评估反馈信息还包括用户反馈信息,用户反馈信息包括用户对长文本应答进行评估后所输入的反馈信息。
19、该可能的实现,支持用户反馈意见的输入,实现生成的长文可以根据用户的心意进行调整改进,提升用户体验。
20、在另一个可能的实现中,若干轮次迭代的迭代停止条件包括到达配置的迭代次数、自我评估反馈信息达标和接收到用户反馈的停止迭代指令中的任意一项。
21、通过用户配置迭代次数参数或用户反馈停止迭代指令的方式,可以动态调整长文本生成的时延和长文本的质量。例如,若感觉长文生成时延较长,可以降低迭代次数参数,或者直接下达迭代停止指令的方式控制迭代停止,得到最终生成的长文本应答,如果感觉生成的长文本质量不佳,则可以将迭代次数参数配置的大一些,经过更多次的迭代,生成质量更好的长文本应答。
22、在一个可能的实现中,第一大语言模型、第二大语言模型、第三大语言模型、第四一大语言模型、第五大语言模型为相同的大语言模型,例如都为gpt4o大语言模型。
23、在另一个可能的实现中,第一大语言模型、第二大语言模型、第三大语言模型、第四一大语言模型、第五大语言模型为不同的大语言模型。
24、第二方面,本技术还提供一种长文本生成装置,包括获取模块、检索规划模块、检索模块和生成模块,其中,获取模块用于获取查询文本;检索规划模块用于基于查询文本进行贪心式的检索规划,得到检索规划结果,检索规划结果为用于并行检索的多个检索语句;检索模块用于基于多个检索语句进行检索,得到相关信息,相关信息为与本次查询任务相关的信息;生成模块用于基于查询文本和相关信息,生成查询文本所对应的长文本应答。
25、在一个可能的实现中,贪心式的检索规划的任务目标为:期望通过一轮检索得到支持完成长文本应答生成任务的相关信息。
26、在一个可能的实现中,检索规划模块具体用于:基于查询文本和背景知识进行贪心式的检索规划,得到检索规划结果,背景知识包括基于查询文本进行预检索得到的检索内容。
27、在另一个可能的实现中,基于查询文本和背景知识进行贪心式的检索规划,得到检索规划结果的一种具体实现为:将查询文本和背景知识输入至第一大语言模型,以使第一大语言模型对查询文本进行问题分解,得到多个子问题;将多个子问题输入至第二大语言模型,以使第二大语言模型为多个子问题生成多个检索语句。
28、在另一个可能的实现中,生成模块具体用于:将查询文本和相关信息作为第三大语言模型的输入,输出长文本应答。
29、在另一个可能的实现中,相关信息包括基于多个检索语句检索得到的多个检索文档;将查询文本和相关信息作为第三大语言模型的输入,输出长文本应答的一种具体实现为:基于查询文本和多个检索文档,生成提示,该提示指示大语言模型基于多个检索文档为查询文本生成长文本应答。
30、在另一个可能的实现中,本技术提供的长文本生成装置还包括评估反馈模块、重规划模块和重生成模块,其中,评估反馈模块用于对长文本应答进行评估,得到评估反馈信息;重检索模块用于基于评估反馈信息,再次进行贪心式的检索规划,更新检索规划结果;基于更新后的检索规划结果进行检索,更新相关信息;重生成模块用于基于查询文本、更新后的相关信息、评估反馈信息和长文本应答,更新长文本应答;经过若干轮次迭代,得到最终的长文本应答。
31、在另一个可能的实现中,评估反馈信息包括自我评估反馈信息;评估反馈模块具体用于:将查询文本和长文本应答输入至第四大语言模型,以使第四大语言模型从至少一个维度对长文本应答进行评估,得到自我评估反馈信息。
32、在另一个可能的实现中,至少一个维度包括相关性维度、信息广度维度、信息深度维度和一致性维度中的一个或多个维度。
33、在另一个可能的实现中,评估反馈信息还包括用户反馈信息,用户反馈信息包括用户对长文本应答进行评估后所输入的反馈信息。
34、在另一个可能的实现中,若干轮次迭代的迭代停止条件包括到达配置的迭代次数、自我评估反馈信息达标和接收到用户反馈的停止迭代指令中的任意一项。
35、在一个可能的实现中,第一大语言模型、第二大语言模型、第三大语言模型、第四一大语言模型、第五大语言模型为相同的大语言模型。
36、在另一个可能的实现中,第一大语言模型、第二大语言模型、第三大语言模型、第四一大语言模型、第五大语言模型为不同的大语言模型。
37、第三方面,本技术实施例提供一种计算设备,包括存储器和处理器,所述存储器中存储有指令,当所述指令被处理器执行时,使得第一方面或第一方面的任一种可能的实现方式所描述的方法被实现。
38、第四方面,本技术实施例提供一种计算机可读存储介质,其上存储有计算机程序,当所述计算机程序在被处理器执行时,使得第一方面或第一方面的任一种可能的实现方式所描述的方法被实现。
39、第五方面,本技术实施例提供一种非瞬时计算机可读存储介质,其上存储有计算机程序,当所述计算机程序在被处理器执行时,使得第一方面或第一方面的任一种可能的实现方式所描述的方法被实现。
40、第五方面,本技术实施例还提供一种计算机程序或计算机程序产品,该计算机程序或计算机程序产品包括指令,当所述指令执行时,令计算机执行第一方面或第一方面的任一种可能的实现方式所描述的方法。
41、第六方面,本技术实施例还提供一种芯片,包括至少一个处理器和通信接口,所述处理器用于执行第一方面或第一方面的任一种可能的实现方式所描述的方法。
42、可以理解的是,上述第二方面至第六方面的有益效果可以参见上述第一方面中的相关描述,为了简洁,在此不再赘述。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com