
基于历史统计的大模型输出漂移检测与修复方法及系统与流程
本技术涉及人工智能与自然语言处理,具体涉及一种基于历史统计的大模型输出漂移检测与修复方法及系统。
背景技术:
1、大型语言模型(large language model, llm)在部署于生产环境后,其输出行为会随着时间的推移发生渐进性变化,这种现象被称为输出漂移(output drift)或行为漂移(behavioral drift)。输出漂移表现为模型输出在语义、风格、内容质量或格式规范等方面逐渐偏离其初始部署状态的特征分布,导致模型的可靠性和一致性随时间推移而下降。
2、输出漂移的产生原因具有多样性。首先,模型自身的迭代更新——如版本升级、参数微调或热修复——可能引入与原有行为模式不一致的输出特征。其次,用户提示词(prompt)的自然演化——包括措辞变化、格式调整或任务要求的隐性变更——也会导致模型输出分布发生偏移。此外,部署环境的变化,例如温度参数(temperature)的调整、系统提示词的修改或上下文窗口的限制变更,均可能引发模型输出的系统性漂移。在长期运行的大规模推理任务中,模型还可能因“认知定向丧失”(loss of epistemic orientation)而出现推理质量的静默退化。
3、目前,针对大模型输出漂移的检测与修复主要面临以下技术难题。
4、第一,缺乏面向生产环境的轻量级漂移检测手段。现有的漂移检测方法往往需要在推理过程中对模型的隐藏层激活值进行探测(activation probing),或者需要维护复杂的评估数据集进行周期性评测。这些方法计算开销大、侵入性强,难以在不影响模型正常推理服务的前提下实现连续、实时的漂移监测。
5、第二,现有检测方法缺乏统一、可量化的漂移判定标准。部分方案采用kl散度等统计指标衡量输出分布的变化,但未建立基于历史统计基线的动态阈值体系,导致检测结果对正常波动过度敏感,或对渐进性漂移反应迟钝。不同应用场景对输出漂移的容忍度差异较大,固定的判定阈值难以适配多样化的部署需求。
6、第三,检测与修复环节相互割裂。多数现有方案仅关注漂移的识别,在检出漂移后缺乏自动化的修复机制。操作人员通常需要手动介入——例如回滚模型版本、调整推理参数或重新设计提示词——这种人工修复方式响应速度慢、成本高,且无法及时遏制漂移的持续恶化。部分研究提出了提示词迁移(prompt migration)等修复策略,但修复决策缺乏对历史漂移模式的统计支撑,难以实现精准、自适应的修复。
7、第四,缺乏对漂移类型的精细化区分与针对性修复。输出漂移可细化为多种子类型,包括语义漂移(输出内容偏离预期含义)、风格漂移(输出语气、格式或表达方式发生变化)和事实性漂移(输出内容与事实依据不一致)等。不同类型的漂移需要采取不同的修复策略,而现有方法往往采用“一刀切”的处理方式,修复效果有限。
8、综上所述,如何提供一种能够基于历史统计分布对大模型输出漂移进行轻量级、连续化检测,并根据检测结果自动执行针对性修复的方法及系统,以提升大模型在生产环境中的输出一致性和可靠性,成为本领域亟待解决的技术问题。
技术实现思路
1、本技术提供了一种基于历史统计的大模型输出漂移检测与修复方法及系统,至少用于解决现有技术存在的问题。
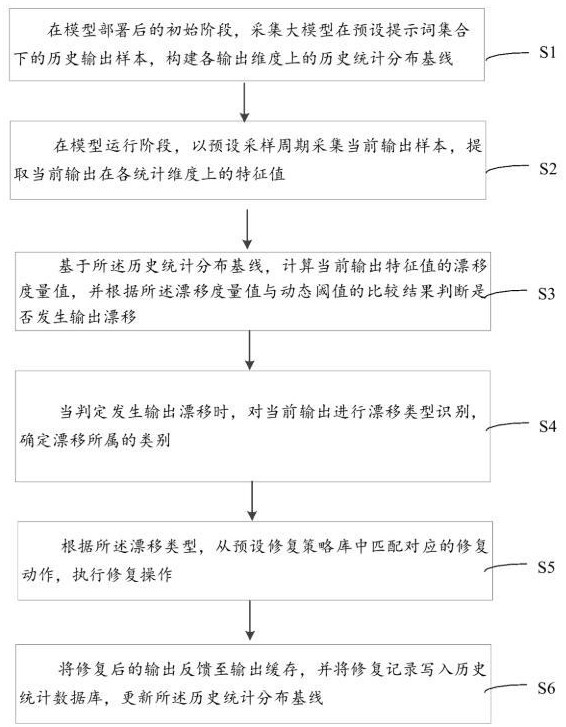
2、本技术实施例的第一方面,提供了一种基于历史统计的大模型输出漂移检测与修复方法,包括:
3、s1:在模型部署后的初始阶段,采集大模型在预设提示词集合下的历史输出样本,构建各输出维度上的历史统计分布基线;
4、s2:在模型运行阶段,以预设采样周期采集当前输出样本,提取当前输出在各统计维度上的特征值;
5、s3:基于所述历史统计分布基线,计算当前输出特征值的漂移度量值,并根据所述漂移度量值与动态阈值的比较结果判断是否发生输出漂移;
6、s4:当判定发生输出漂移时,对当前输出进行漂移类型识别,确定漂移所属的类别;
7、s5:根据所述漂移类型,从预设修复策略库中匹配对应的修复动作,执行修复操作;
8、s6:将修复后的输出反馈至输出缓存,并将修复记录写入历史统计数据库,更新所述历史统计分布基线。
9、本技术实施例中,通过在大模型部署初期建立基于历史输出样本的统计分布基线,为后续漂移检测提供了可量化的参照基准;利用动态阈值技术实现了对输出漂移的连续、轻量级监测,无需侵入模型内部结构或依赖外部标注数据;通过漂移类型识别与策略化修复的联动机制,实现了从检测到修复的自动化闭环,有效提升了大模型在生产环境中的输出一致性和长期可靠性。
10、本技术一些实施例中,步骤s1中所述构建各输出维度上的历史统计分布基线,包括:
11、s11:确定需要监测的输出统计维度,所述统计维度至少包括输出长度、词汇多样性、标点符号使用频率、句式结构分布、情感极性分布以及特定领域关键词出现频率中的一个或多个;
12、s12:针对每个统计维度,采集预设数量历史输出样本的统计值,形成该维度的历史统计值序列;
13、s13:对每个维度的历史统计值序列进行正态性检验,对于符合正态分布的维度,计算其均值和标准差作为基线参数;对于不符合正态分布的维度,采用分位数回归或核密度估计建立非参数统计基线;
14、s14:将各维度的基线参数组合存储,形成所述历史统计分布基线。
15、本技术实施例中,通过对输出进行多维度统计特征提取,能够全面刻画模型在正常状态下的输出行为模式;针对不同分布特性的统计维度采用参数化或非参数化的基线建模方法,提高了基线对不同数据分布特征的适应能力,为后续漂移检测提供了准确可靠的参照依据。
16、本技术一些实施例中,步骤s2中所述提取当前输出在各统计维度上的特征值,包括:
17、s21:将当前输出文本进行分句和分词预处理,得到结构化的文本单元序列;
18、s22:遍历所述文本单元序列,分别计算当前输出在各统计维度上的特征统计量;
19、s23:将各维度的特征统计量按照与所述历史统计分布基线相同的维度和顺序进行排列,形成当前输出特征向量。
20、本技术一些实施例中,步骤s3中所述计算当前输出特征值的漂移度量值,包括:
21、s31:对于每个统计维度,根据该维度的基线类型,计算当前特征值与基线之间的偏离程度值;
22、s32:对所述偏离程度值进行归一化处理,得到各维度的标准化偏离分数;
23、s33:对各维度的标准化偏离分数进行加权聚合,得到所述当前输出的综合漂移度量值;
24、s34:所述动态阈值的确定方式为:基于历史统计分布基线的离散程度,结合预设的容忍系数,计算得到动态阈值,所述动态阈值随基线更新而自适应调整。
25、本技术实施例中,通过计算各维度偏离程度并进行加权聚合,能够从多维度综合评估输出漂移程度,避免单一维度误判;动态阈值随基线更新而自适应调整,使得检测系统能够跟随模型输出分布的合理演化,降低误报率。
26、本技术一些实施例中,步骤s3中所述判断是否发生输出漂移,具体为:
27、当所述综合漂移度量值超过所述动态阈值时,判定当前输出发生漂移;否则,判定当前输出未发生漂移;
28、当连续预设数量个采样周期的综合漂移度量值均未超过所述动态阈值时,将当前输出样本纳入历史统计数据库,触发所述历史统计分布基线的增量更新。
29、本技术实施例中,通过连续超标判定机制避免了单次波动引发的误触发;通过正常样本的增量更新机制使基线能够缓慢追随模型输出的合理演化,避免基线老化导致的检测性能下降。
30、本技术一些实施例中,步骤s4中所述漂移类型识别,包括:
31、s41:提取当前输出在各统计维度上的偏离方向与偏离幅度,形成漂移特征向量;
32、s42:将所述漂移特征向量输入预先训练的漂移分类器,所述漂移分类器基于历史漂移样本训练得到,输出漂移属于各类别的概率分布;
33、s43:根据所述概率分布,将概率最高的类别确定为当前漂移的所属类型;
34、所述漂移的类别至少包括:语义漂移、风格漂移、事实性漂移和格式漂移。
35、本技术实施例中,通过基于漂移特征向量的分类器进行漂移类型识别,能够精细化区分不同类型的输出漂移,为后续针对性修复提供类型信息,提高修复的精准度和有效性。
36、本技术一些实施例中,步骤s5中所述预设修复策略库包含与各漂移类型对应的修复动作,包括:
37、对于语义漂移,对应的修复动作为:调整模型解码温度参数和/或top_p采样参数,并重新生成输出;
38、对于风格漂移,对应的修复动作为:在系统提示词中插入风格约束指令,并重新生成输出;
39、对于事实性漂移,对应的修复动作为:触发外部知识库检索,将检索结果作为上下文增强信息注入提示词,并重新生成输出;
40、对于格式漂移,对应的修复动作为:在生成后处理阶段应用格式规整化过滤器,对输出进行格式校正。
41、本技术实施例中,针对不同漂移类型配置差异化的修复策略,实现了“因漂施治”的精准修复;通过参数调整、提示词增强、外部知识注入和后处理过滤等多种修复手段的组合运用,提高了修复的成功率和鲁棒性。
42、本技术一些实施例中,步骤s5中所述执行修复操作后,还包括修复效果验证:
43、s51:将修复后的输出再次进行漂移检测,计算修复后输出的综合漂移度量值;
44、s52:若所述修复后输出的综合漂移度量值低于所述动态阈值,则判定修复成功,将修复后输出作为最终输出;
45、s53:若所述修复后输出的综合漂移度量值仍不低于所述动态阈值,则判定修复失败,触发备用修复策略或生成人工介入告警信号。
46、本技术实施例中,通过在修复后引入效果验证机制,形成了“检测-修复-验证”的闭环,确保修复操作确实达到了消除漂移的效果;在修复失败时及时触发备用策略或人工介入,避免了修复无效导致的输出质量问题持续存在。
47、本技术一些实施例中,步骤s6中所述更新所述历史统计分布基线,包括:
48、s61:将修复成功后的输出及其对应的原始提示词、修复动作类型和修复时间戳关联存储至历史统计数据库;
49、s62:按照预设的基线更新周期,基于历史统计数据库中的全部历史样本重新计算各维度的统计基线参数;
50、s63:将重新计算后的基线参数替换原有基线参数,完成基线的周期更新。
51、本技术实施例中,通过将修复成功样本纳入历史数据库并周期性重算基线,使基线能够持续吸收模型输出的合理演化趋势,避免基线固化导致的误检率升高;同时将修复记录存档为后续漂移模式分析和策略优化的数据基础。
52、本技术实施例的第二方面,提供一种基于历史统计的大模型输出漂移检测与修复系统,包括:
53、输出采集模块,用于采集大模型的当前输出样本;
54、统计特征提取模块,用于提取输出样本在各统计维度上的特征值;
55、基线存储模块,用于存储基于历史输出样本构建的历史统计分布基线;
56、漂移检测模块,用于根据所述历史统计分布基线与当前输出特征值计算漂移度量值,并判断是否发生输出漂移;
57、漂移类型识别模块,用于在判定发生输出漂移时识别漂移所属的类别;
58、修复执行模块,用于根据所述漂移类型从预设修复策略库中匹配对应的修复动作并执行修复操作;
59、基线更新模块,用于根据修复成功后的输出及历史样本更新所述历史统计分布基线;
60、处理器,分别与所述输出采集模块、统计特征提取模块、基线存储模块、漂移检测模块、漂移类型识别模块、修复执行模块及基线更新模块通信连接,所述处理器被配置为执行本技术的方法。
61、本技术实施例中,通过将输出采集、统计特征提取、基线存储、漂移检测、漂移类型识别、修复执行和基线更新集成为闭环系统,实现了大模型输出漂移的自动化检测与修复;处理器执行本技术方法后,能够在无需侵入模型内部结构的前提下实现轻量级、连续化的漂移监测,并根据漂移类型自动执行针对性修复,显著提升了大模型在生产环境中的输出一致性和长期可靠性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com