
面向学术文献的跨学科知识单元引用网络构建及分析系统
本发明属于知识图谱构建、科技情报分析、学术文献语义识别与跨学科知识网络分析,具体涉及一种面向学术文献的跨学科知识单元引用网络构建及分析系统。
背景技术:
1、随着科学研究问题日益复杂,跨学科知识融合已成为科学创新的重要方式。学术文献中的引用行为是知识流动的重要载体,引用不仅表示文献之间存在关联,还隐含了研究者对外部理论、方法、数据或概念的使用、扩展和比较。因此,如何从学术文献中识别具体知识内容,刻画知识内容之间的引用关系,并进一步分析跨学科知识引用路径和规律,已成为科技情报分析、知识图谱构建和跨学科研究评价中的重要技术问题。
2、现有跨学科知识分析方法多以文献、作者、机构、期刊、关键词、主题或学科类别作为基本分析对象。例如,引文分析方法可以统计不同学科文献之间的引用数量和引用方向,主题模型方法可以抽取研究主题,关键词共现方法可以分析研究热点关系,知识图谱方法可以抽取科研实体并构建实体关系网络。这些方法能够从宏观层面反映学科之间的联系,但分析粒度通常停留在文献级、主题级或关键词级,难以说明跨学科引用中具体被引用的知识内容及其在研究中的语义作用。
3、现有相关专利中,公开号为cn111241293a的专利申请公开了一种基于学术文献构建的知识图谱算法,公开号为cn120030172a 的专利申请公开了一种科技文献知识图谱构建方法、装置、设备及介质,主要面向学术文献或科技文献的知识图谱构建;公开号为cn119830157a 的专利申请公开了一种基于动态异构图融合网络的引用意图分类方法,主要利用引用句上下文和章节信息进行引用意图分类。上述方案虽分别涉及知识图谱构建和引用意图识别,但仍存在分析粒度较粗、特定领域实体识别对大规模训练集高度依赖、知识单元网络分析缺乏跨学科维度等不足。
技术实现思路
1、为了克服上述现有技术的缺点,本发明的目的在于提供一种面向学术文献的跨学科知识单元引用网络构建及分析系统,针对现有跨学科知识分析方法存在分析粒度较粗、专业领域知识单元实体识别对大规模训练集依赖较强、知识单元网络分析缺乏跨学科维度等问题,本发明采用检索增强生成技术与大语言模型融合的识别框架,在少样本条件下,通过多轮验证优化方法提高学术文献中知识单元实体识别、词汇功能分类判别和引文功能类别判别的准确性与稳定性;并在此基础上构建跨学科多语义知识单元引用网络,将跨学科知识分析对象由文献、主题或关键词细化到知识单元层面,进而通过网络结构、知识单元跨学科影响力、知识单元跨学科引用模式、跨学科知识群落和动态演化分析,揭示跨学科知识融合路径及其演化规律。本发明能够在较低人工标注成本下实现更细粒度、更高语义解释性和更具跨学科针对性的知识引用分析。
2、为了实现上述目的,本发明采用的技术方案是:
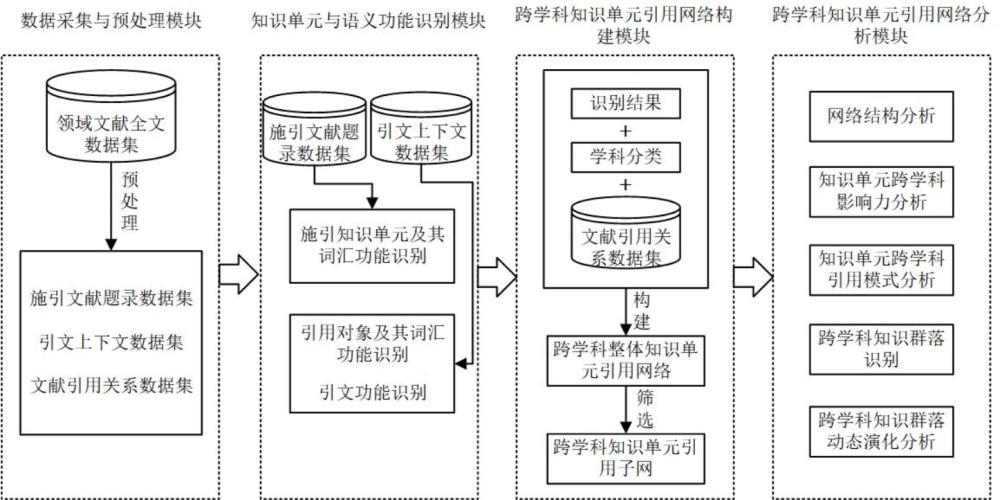
3、一种面向学术文献的跨学科知识单元引用网络构建及分析系统,包括数据采集与预处理模块、知识单元与语义功能识别模块、跨学科知识单元引用网络构建模块和跨学科知识单元引用网络分析模块;
4、所述数据采集与预处理模块,用于获取目标领域学术文献全文数据集并预处理,生成施引文献题录数据集、引文上下文数据集和文献引用关系数据集;
5、所述知识单元与语义功能识别模块,用于对预处理后的数据进行语义功能识别,分别基于施引文献题录数据集识别施引知识单元及其词汇功能、基于引文上下文数据集识别被引知识单元及其词汇功能和引文功能;
6、所述跨学科知识单元引用网络构建模块,用于将语义识别结果和学科分类信息组成复合节点,从文献引用关系数据集中提取知识单元引用关系作为边,构建跨学科知识单元引用网络,再根据施引知识单元和被引知识单元的学科属性提取跨学科知识单元引用子网;
7、所述跨学科知识单元引用网络分析模块,对构建得到的跨学科知识单元引用网络及跨学科知识单元引用子网进行网络拓扑结构分析、知识单元跨学科影响力分析、知识单元跨学科引用模式分析、跨学科知识群落识别和跨学科知识群落动态演化分析,得到目标领域跨学科知识引用结构、核心知识单元、典型引用模式、知识群落结构及其演化趋势。
8、所述目标领域学术文献全文数据集包括文献题录、正文以及该文献所引用的参考文献。
9、所述预处理包括对目标领域学术文献全文数据集进行结构化解析和两次数据清洗;
10、所述结构化解析包括从施引文献中提取题名、摘要和关键词字段,形成施引文献题录数据集,以及从施引文献正文中抽取带有参考文献标识的引文句,并记录引文句对应的参考文献编号、所在章节、发表年份和上下文信息,形成引文上下文数据集;
11、所述第一次数据清洗去除目标领域学术文献全文数据中缺失、格式异常和参考文献标识无法解析的记录;
12、所述第二次数据清洗去除施引文献题录数据集、引文上下文数据集和文献引用关系数据集中字段缺失记录、无效参考文献标识、重复引用记录和无法建立施引文献与被引知识单元对应关系的数据。
13、所述知识单元与语义功能识别的具体步骤如下:
14、对施引知识单元及其词汇功能的题录样例,以及引文功能、被引知识单元及其词汇功能的引文句样例进行人工标注,并将人工标注的样例划分为训练集、验证集和测试集;
15、基于训练集构建人工标注样例知识库并结合现有领域术语知识库,进行向量化存储;
16、所述领域术语知识库用于保存目标领域专业术语及定义;
17、当输入新的施引文献题录数据或引文上下文数据时,分别从人工标注样例知识库和领域术语知识库中检索余弦相似度最高的前个样例和术语,并进行重排序,保留重排序得分最高前个样例和术语,;
18、将新输入的施引文献题录数据、保留的样例和术语及其定义、判定规则和输出格式共同填入结构化提示词模板,并输入大语言模型进行识别,得到施引知识单元及其词汇功能、被引知识单元及其词汇功能和引文功能的结构化字段。
19、所述知识单元与语义功能识别模块还采用精确率、召回率和值评价施引知识单元及其词汇功能、被引知识单元及其词汇功能和引文功能,其中,精确率表示大语言模型正确识别结果在全部识别结果中的比例,召回率表示大语言模型正确识别结果在验证集或测试集人工标注数据的识别结果中的比例,值表示精确率和召回率的调和平均值,计算公式如(1)、(2)和(3)所示:
20、(1)
21、(2)
22、(3)
23、其中,表示大语言模型正确识别出的施引知识单元及其词汇功能、被引知识单元及其词汇功能的数量,表示大语言模型错误识别或多余生成的施引知识单元及其词汇功能、被引知识单元及其词汇功能的数量,表示大语言模型未能识别出的施引知识单元及其词汇功能、被引知识单元及其词汇功能的数量;
24、采用rouge-1、rouge-2、rouge-l和bertscore评价大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元的词汇字符相似度,其中,rouge-1用于评价大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元之间的一元词重合情况,分别基于不同粒度的词项重合或最长公共子序列计算;rouge-2用于评价大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元之间的二元词组重合情况;rouge-l用于评价大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元之间最长公共子序列的匹配情况,从而衡量大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元在词汇字符层面的相似程度;bertscore基于bert模型生成的上下文语义向量,通过计算大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元之间的语义相似度,评价大语言模型识别的被引知识单元和施引知识单元与人工标注的被引知识单元和施引知识单元在语义层面的一致性,计算公式如(4)、(5)和(6)所示:
25、(4)
26、(5)
27、(6)
28、其中,表示大语言模型识别的施引知识单元和被引知识单元经分词后得到的词元集合,表示人工标注的施引知识单元和被引知识单元经分词后得到的词元集合,表示集合中的第个词元对应的上下文语义向量,表示集合中的第个词元对应的上下文语义向量;表示集合中的词元数量,表示集合中的词元数量;表示向量与向量之间的余弦相似度;表示大语言模型识别的施引知识单元和被引知识单元中的语义向量与人工标注的施引知识单元和被引知识单元中各语义向量进行匹配后得到的最大语义相似度;表示人工标注的施引知识单元和被引知识单元中的语义向量与大语言模型识别的施引知识单元和被引知识单元中各语义向量进行匹配后得到的最大语义相似度;表示以大语言模型输出的施引知识单元和被引知识单元为基准计算得到的语义召回率,表示以人工标注的施引知识单元和被引知识单元为基准计算得到的语义精确率,表示与的调和平均值;
29、依据精确率、召回率、f1值、rouge-1、rouge-2、rouge-l和bertscore评价指标,并将大语言模型识别结果与人工标注结果进行比对,识别错误类型,包括:实体边界错误、类别误判、漏识别、多识别和输出格式错误;根据识别错误类型修正结构化提示词模板;并将该轮已完成人工标注并用于验证的题录样例和引文句样例补充到人工标注样例知识库中进行下一轮迭代;直至大语言模型识别结果与人工标注结果进行比对的精确率、召回率、f1值、rouge-1、rouge-2、rouge-l和bertscore评价指标不再提高,则将评估指标达到最高值的优化轮次确定为最优轮次,并将最优轮次的结构化提示词版本、补充后的人工标注样例知识库、原本的领域术语知识库和大语言模型结合形成最终的知识单元与语义功能识别模型。
30、所述跨学科知识单元引用网络的网络模型定义为有向加权图,其中,表示施引知识单元节点和被引知识单元节点集合,表示从文献引用关系数据集中提取的知识单元之间基于引用关系形成的有向边集合,表示边权重集合,表示节点属性和边属性集合;
31、所述施引知识单元节点或被引知识单元节点包括施引或被引知识单元实体名称及其词汇功能分类编码、学科分类编码;所述施引知识单元节点作为源节点,所述被引知识单元节点作为目标节点;所述词汇功能类别编码根据施引知识单元或被引知识单元在科学研究中的词汇功能预先设定,分别包括施引知识单元中的研究问题编码,研究方法编码,被引知识单元中的研究方法编码,数据编码,理论或概念编码;所述学科分类编码依据openalex学科分类体系中的二级学科field设定,用于标识知识单元所属学科领域,分别包括目标学科编码及外部学科分类编码;将施引或被引知识单元实体名称及其词汇功能分类编码、学科分类编码进行拼接形成节点标签。
32、所述跨学科知识单元引用子网的提取过程如下:
33、遍历跨学科知识单元引用网络中的所有有向边,根据源节点和目标节点的学科分类编码判断其是否属于跨学科引用关系;若源节点属于目标学科,且目标节点属于非目标学科,则保留该有向边及其两端节点;若边表示目标学科内部引用、外部学科之间引用,则予以剔除;筛选后,删除孤立节点,形成跨学科知识单元引用子网。
34、所述网络拓扑结构分析通过跨学科知识单元引用网络和跨学科知识单元引用子网的节点数、边数、平均度、平均加权度、网络密度、网络直径、平均路径长度、连通分量和模块度分析跨学科知识单元引用网络的连通性、稀疏性、聚集性和结构分布特征,用于刻画跨学科知识单元引用网络的引用结构;同时采用网络投影方法,分别构建跨学科知识单元引用子网的施引节点投影网络和被引知识单元节点投影网络,其中,施引节点投影网络用于表示不同施引知识单元是否共同引用相同被引知识单元,被引知识单元节点投影网络用于表示不同被引知识单元是否被相同施引知识单元共同引用,通过计算投影网络密度或平均聚类系数,分析施引知识单元之间的知识需求重叠程度以及被引知识单元之间的共同被引用关系,补充刻画跨学科知识单元引用子网的局部聚集特征;
35、所述知识单元跨学科影响力分析用于识别跨学科知识单元引用网络中的核心被引知识单元和活跃施引知识单元;根据跨学科知识单元引用网络中的节点和有向边的入度、出度、加权入度和加权出度衡量节点的活跃性和核心性,其中,入度表示指向某一节点的有向边数量,用于衡量被引知识单元节点被不同施引知识单元节点引用的次数;出度表示由某一节点指向其他节点的有向边数量,用于衡量施引知识单元节点引用外部学科的被引知识单元节点的活跃程度;加权入度表示指向某一节点的有向边权重之和,用于衡量被引知识单元节点被引用的累计强度;加权出度表示由某一节点指向其他节点的有向边权重之和,用于衡量施引知识单元节点对外部学科知识的累计引用强度;所述有向边权重由相同施引知识单元、相同被引知识单元和相同引文功能类别的引用频次聚合得到;采用网页排序算法计算施引或被引知识单元节点在网络中的重要性,依据节点的重要性判断核心知识单元及处于知识流动核心路径上的基础理论、关键方法或重要数据;同时采用超链接诱导主题搜索算法计算施引知识单元节点的权威值和枢纽值,其中,权威值用于反映被引知识单元节点作为外部知识来源的受认可程度,枢纽值用于反映施引知识单元节点吸收和组织外部知识的能力;
36、所述知识单元跨学科引用模式分析用于揭示不同词汇功能类别知识单元之间的引用组合规律;根据施引知识单元与被引知识单元的词汇功能类别,将引用关系划分为研究问题引用研究方法、研究问题引用数据、研究问题引用理论或概念、研究方法引用研究方法、研究方法引用数据以及研究方法引用理论或概念六类典型引用模式,以跨学科知识单元引用子网中的每一条有向边作为统计对象,读取该有向边的源节点词汇功能类别和目标节点词汇功能类别,并组合为一种引用模式;基于每一类引用模式,统计唯一模式数量、总引用数量和平均引用强度,其中,唯一模式数量为该模式下不重复的施引或被引知识单元实体名称的组合数量,总引用数量为该模式下所有有向边的边权重之和,平均引用强度为总引用数量与唯一模式数量的比值;
37、所述跨学科知识群落识别用于发现跨学科知识单元引用网络中连接紧密、语义关联较强的施引或被引知识单元集合;采用社群发现算法对跨学科知识单元引用网络进行划分,得到多个知识群落;将每个知识群落内部出度、加权出度、pagerank值或枢纽值排名靠前的施引知识单元确定为核心施引知识单元节点;将每个知识群落内部入度、加权入度、pagerank值或权威值排名靠前的被引知识单元确定为核心被引知识单元节点;统计知识群落内部各类引文功能类别对应的有向边数量或边权重之和,将占比最高的引文功能类别确定为该群落的主要引文功能;统计知识群落内部各类篇章位置对应的有向边数量或边权重之和,将占比最高的篇章位置确定为该群落的主要篇章位置;随后,结合核心施引知识单元节点、核心被引知识单元节点、主要引文功能和主要篇章位置,对知识群落的主题和跨学科融合类型进行解释;
38、所述跨学科知识群落动态演化分析用于从时间维度刻画知识融合模式的变化趋势,该分析构建基于固定群落结构的动态监测框架:以网络分析中识别出的核心知识群落为基准参照系,根据文献引用关系数据集中的引用时间属性,将跨学科知识单元引用网络划分为不同时间切片;通过统计各知识群落内部在不同时间切片下的引用强度变化,绘制不同跨学科融合模式的活跃度演变曲线,从而捕捉领域研究重心的宏观迁移路径,接着追踪各知识群落内部核心被引知识单元的年度更替情况,解析知识单元流动的具体内容与方向,以揭示某一外部知识单元如何从边缘的探索性引用逐渐演变为核心基础架构,或某一理论概念如何在新的技术条件下被重新激活并爆发式增长。
39、相对于现有技术,本发明的有益效果在于:
40、(1)提高跨学科知识分析的细粒度和语义解释性
41、现有跨学科分析方法多以文献、关键词、主题或学科类别作为分析对象,难以深入到具体知识内容层面。本发明通过知识单元实体识别,将施引文献中的研究问题、研究方法,以及引文句及其上下文中的研究方法、数据、理论或概念作为网络节点进行建模,使跨学科知识分析对象由文献级、主题级细化到知识单元级。因此,本发明能够更准确地说明跨学科引用中具体引用了什么知识内容,以及该知识内容在科学研究中承担的词汇功能。
42、(2)降低专业领域知识实体识别对大规模标注数据的依赖
43、现有专业领域实体识别方法通常需要较大规模的人工标注语料支撑,人工成本较高,且在术语复杂、缩写较多、引文语境多样的学术文献文本中容易出现实体边界识别不稳定的问题。本发明采用检索增强生成技术与大语言模型融合的识别框架,将少量人工标注样例知识库和领域术语知识库作为外部知识源,通过相似样例检索、相关术语检索、结构化提示词和多轮验证优化,提高大语言模型在少样本条件下的识别能力。因此,本发明能够在减少大规模人工标注依赖的同时,提高知识单元实体识别、词汇功能类别判别和引文功能类别判别的准确性与稳定性。
44、(3)增强引文网络对跨学科知识引用路径的表达能力
45、传统引文网络通常只记录文献之间是否存在引用关系或引用次数,难以表达具体知识单元之间的语义联系。本发明将知识单元实体名称、词汇功能类别编码和学科分类编码共同组成复合节点,将施引知识单元指向被引知识单元的引用行为表示为具有引文功能、引用时间、篇章位置和引用频次属性的有向加权边。因此,本发明不仅能够表示是否引用,还能够表示施引知识单元引用了哪个被引知识单元、引用发生在何种研究环节以及引用功能属于使用、扩展还是对比,从而提高跨学科知识引用路径的可解释性。
46、(4)能够区分领域内部知识结构和跨学科知识引用路径
47、现有知识图谱或主题演化方法往往难以准确区分领域内部知识引用、外部学科知识输入以及外部学科之间的无关引用。本发明先构建包含目标学科内部与外部知识引用的跨学科整体知识单元引用网络,再根据节点学科分类编码筛选目标学科施引知识单元指向非目标学科被引知识单元的引用关系,形成跨学科知识单元引用子网。因此,本发明既能够保留目标领域知识结构的整体视图,又能够聚焦分析外部学科知识流入目标学科的具体路径。
48、(5)形成从语义识别到知识引用规律分析的完整技术流程
49、现有技术通常分别进行实体抽取、主题分析、引用统计或网络可视化,分析链路相对分散。本发明将数据采集与预处理、知识单元与语义功能识别、跨学科知识单元引用网络构建、跨学科知识单元引用网络分析整合为连续流程,并通过网络拓扑结构分析、知识单元跨学科影响力分析、知识单元跨学科引用模式分析、跨学科知识群落识别和跨学科知识群落动态演化分析输出结果。因此,本发明能够系统揭示跨学科知识融合结构、核心被引知识单元和施引知识单元、典型引用模式、知识群落及其演化趋势,为科技情报分析、学科交叉评价和科研决策提供更细粒度的数据支撑。
50、综上,本发明能够在少样本条件下实现学术文献知识单元与语义功能识别,并将识别结果转化为可计算、可分析、可解释的跨学科知识单元引用网络,从而提高跨学科知识融合路径识别和演化规律分析的准确性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com