
一种基于多重筛选机制的宝玉石原石溯源方法及相关装置与流程
本发明实施例涉及宝玉石检测技术、人工智能以及信息化领域,具体涉及一种基于多重筛选机制的宝玉石原石溯源方法、装置、计算机设备及计算机可读存储介质。
背景技术:
1、在样品管理和质量控制领域,样品溯源是一个重要且具有挑战性的问题。传统的样品溯源方法主要包括:(1)基于单一特征的溯源方法。如基于重量/尺寸的溯源。基于重量/尺寸的溯源:仅通过比较样品重量、长宽高、图像来判断是否重复。这种方法简单直接,但准确率和工作效率极低,因为不同样品可能具有相同或相近的重量,针对几十至几百个样品来说问题不大,但是对于上百万的数量就显得极其耗时且无能为力了。 基于图像的溯源:对于刻面宝石去测量台面面积、测量台面最大长度和最小长度比例这种方法,这种方法会导致形状相似的宝石具有相同比例的参数。仅通过图像匹配来判断是否重复。这种方法准确率相对较高,但计算成本大,且容易受到光照、角度、遮挡等因素影响,无法实现单一的图像高精度的匹配。(2)基于多特征的简单组合方法:如将多个特征(如重量、图像等)进行简单加权组合,但缺乏系统性的筛选机制。其未考虑不同特征的计算成本和筛选效率差异,很难应用于高精度要求的实际场景。(3)基于深度学习的端到端方法:使用深度学习模型直接学习样品的相似度,但需要大量标注数据,且模型可解释性差。这使得计算资源需求大,难以在资源受限环境下部署。
2、现有技术存在以下主要缺点和不足:
3、(1)单一特征识别局限性:
4、仅依赖单一特征(如重量/尺寸或图像)进行溯源,容易产生误判。不同样品可能具有相同或相近的重量/尺寸,导致基于重量的溯源方法误报率高。仅基于图像匹配时,计算量大,且可能受到光照、角度、部分遮挡等因素影响,导致漏报或误报。
5、(2)计算效率低:
6、当样品数据库规模较大(如上万数量)时,如果对所有样品进行全量图像匹配计算,计算成本高、耗时长。图像匹配算法(单一的模型如sift、surf等模型)计算复杂度高,全量匹配难以满足实际应用的时间要求。缺乏有效的筛选机制来减少不必要的计算。
7、(3)准确率不足:
8、单一特征匹配容易受到测量误差、环境因素等干扰,导致溯源准确率不高。或者筛查出大量的数据仍然再次耗费大量人力进行筛查。实际检测过程中这样的后续人力筛查至少需要4-5个小时完成一件样品的筛查。误报率(false positive rate)和漏报率(falsenegative rate)较高,影响实际应用效果。缺乏多层次的验证机制来提高溯源可靠性。
技术实现思路
1、鉴于上述问题,本发明实施例提供了一种基于多重筛选机制的宝玉石原石溯源方法、装置、计算机设备及计算机可读存储介质,用于解决现有技术中存在的宝玉石检测溯源过程中,单一特征识别局限、计算效率低且准确率不足的问题。
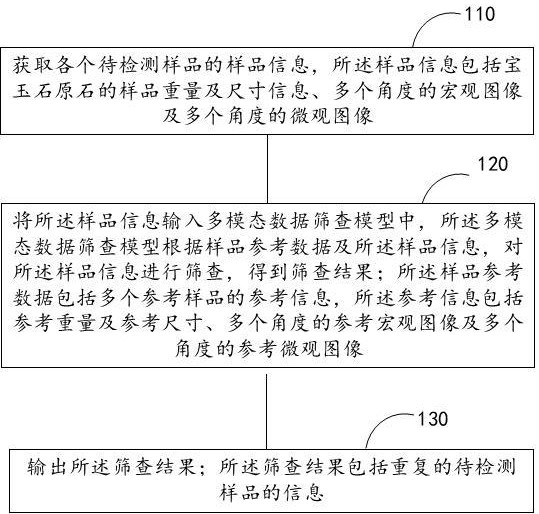
2、根据本发明实施例的一个方面,提供了一种基于多重筛选机制的宝玉石原石溯源方法,所述方法包括:
3、获取各个待检测样品的样品信息,所述样品信息包括宝石的样品重量及尺寸信息、多个角度的宏观图像及多个角度的微观图像;
4、将所述样品信息输入多模态数据筛查模型中,所述多模态数据筛查模型根据样品参考数据及所述样品信息,对所述样品信息进行筛查,得到筛查结果;所述样品参考数据包括多个参考样品的参考信息,所述参考信息包括参考重量及参考尺寸、多个角度的参考宏观图像及多个角度的参考微观图像;
5、输出所述筛查结果;所述筛查结果包括重复的待检测样品的信息。
6、在一种可选的方式中,所述将所述样品信息输入多模态数据筛查模型中,所述多模态数据筛查模型根据样品参考数据及所述样品信息,对所述样品信息进行筛查,包括:
7、所述多模态数据筛查模型根据各个参考样品的参考重量及参考尺寸,以及所述样品重量及尺寸信息,对各个待检测样品进行初筛,得到初筛样品集;
8、所述多模态数据筛查模型根据各个参考样品的多个角度的参考宏观图像,对所述初筛样品集中的各个样品的宏观图像进行筛选,得到宏观筛查样品集;
9、所述多模态数据筛查模型根据各个参考样品的多个角度的参考微观图像,以及所述微观筛查样品集中各个样品的微观图像,进行筛查,得到筛查结果。
10、在一种可选的方式中,所述多模态数据筛查模型根据各个参考样品的参考重量及参考尺寸,以及所述样品重量及尺寸信息,对各个待检测样品进行初筛,得到初筛样品集,进一步包括:
11、计算各个待检测样品的样品重量与各个参考样品的参考重量之间的第一绝对误差,以及各个待检测样品的最大尺寸与各个参考样品的参考最大尺寸之间的第二绝对误差;
12、若第一目标待检测样品对应的所述第一绝对误差小于预设重量容差阈值,且所述第二绝对误差小于预设尺寸容差阈值,将所述第一目标待检测样品加入初筛样品集;所述第一目标待检测样品为各个待检测样品中的一个。
13、在一种可选的方式中,所述多模态数据筛查模型根据各个参考样品的多个角度的参考宏观图像,对所述初筛样品集中的各个样品的宏观图像进行筛选,得到宏观筛查样品集,包括:
14、使用图像匹配算法计算各个参考宏观图像与所述初筛样品集中的第二目标待检测样品的各个宏观图像之间的各个第一基础内点数;
15、根据第一分布均匀性系数及第一一致性系数,修正各个所述第一基础内点数,得到各个第一修正内点数;
16、根据第一加权匹配分数及第一置信度因子,计算匹配对的第一匹配分数;所述第一匹配分数根据各个第一修正内点数对应的第一最大内点数、第一平均内点数及第一有效匹配对数量确定;
17、根据第一基础内点数阈值及所述初筛样品集中所述第一绝对误差和/或第二绝对误差,动态调整第一内点数阈值;
18、若所述第一匹配分数大于所述第一内点数阈值,则确定第二目标待检测样品加入宏观筛查样品集中;所述第二目标待检测样品为所述初筛样品集中多个待检测样品中的一个。
19、在一种可选的方式中,所述多模态数据筛查模型根据各个参考样品的多个角度的参考微观图像,以及所述微观筛查样品集中各个样品的微观图像,进行筛查,得到筛查结果,包括:
20、使用图像匹配算法计算各个参考微观图像与所述宏观筛查样品集的第三目标待检测样品的各个微观图像之间的各个第二基础内点数;
21、根据第二分布均匀性系数及第二一致性系数,修正各个所述第二基础内点数,得到各个第二修正内点数;
22、根据第二加权匹配分数及第二置信度因子,计算匹配对的第二匹配分数;所述第二匹配分数根据各个第二修正内点数对应的第二最大内点数、第二平均内点数及第二有效匹配对数量确定;
23、根据第二基础内点数阈值及第一基础内点数阈值及所述初筛样品集中所述第一绝对误差和/或第二绝对误差,动态调整第二内点数阈值;
24、若所述第二匹配分数大于所述第二内点数阈值,则确定第三目标待检测样品加入微观筛查样品集中;所述第三目标待检测样品为所述初筛样品集中多个待检测样品中的一个。
25、在一种可选的方式中,所述方法还包括:汇总各个阶段的筛查结果,并根据筛查结果生成溯源报告。
26、根据本发明实施例的另一方面,提供了一种基于多重筛选机制的宝玉石原石溯源装置,包括:
27、获取模块,用于获取各个待检测样品的样品信息,所述样品信息包括宝石的样品重量及尺寸信息、多个角度的宏观图像及多个角度的微观图像;
28、筛查模块,用于将所述样品信息输入多模态数据筛查模型中,所述多模态数据筛查模型根据样品参考数据及所述样品信息,对所述样品信息进行筛查,得到筛查结果;所述样品参考数据包括多个参考样品的参考信息,所述参考信息包括参考重量及参考尺寸、多个角度的参考宏观图像及多个角度的参考微观图像;
29、输出模块,用于输出所述筛查结果;所述筛查结果包括重复的待检测样品的信息。
30、在一种可选的方式中,所述将所述样品信息输入多模态数据筛查模型中,所述多模态数据筛查模型根据样品参考数据及所述样品信息,对所述样品信息进行筛查,包括:
31、所述多模态数据筛查模型根据各个参考样品的参考重量及参考尺寸,以及所述样品重量及尺寸信息,对各个待检测样品进行初筛,得到初筛样品集;
32、所述多模态数据筛查模型根据各个参考样品的多个角度的参考宏观图像,对所述初筛样品集中的各个样品的宏观图像进行筛选,得到宏观筛查样品集;
33、所述多模态数据筛查模型根据各个参考样品的多个角度的参考微观图像,以及所述微观筛查样品集中各个样品的微观图像,进行筛查,得到筛查结果。
34、根据本发明实施例的另一方面,提供了一种计算机设备,包括:处理器、存储器、通信接口和通信总线,所述处理器、所述存储器和所述通信接口通过所述通信总线完成相互间的通信;
35、所述存储器用于存放至少一可执行指令,所述可执行指令使所述处理器执行所述的基于多重筛选机制的宝玉石原石溯源方法的操作。
36、根据本发明实施例的又一方面,提供了一种计算机可读存储介质,所述存储介质中存储有至少一可执行指令,所述可执行指令在计算机设备上运行时,使得计算机设备执行所述的基于多重筛选机制的宝玉石原石溯源方法的操作。
37、本发明实施例通过获取各个待检测样品的样品信息,所述样品信息包括宝石的样品重量及尺寸信息、多个角度的宏观图像及多个角度的微观图像;将所述样品信息输入多模态数据筛查模型中,所述多模态数据筛查模型根据样品参考数据及所述样品信息,对所述样品信息进行筛查,得到筛查结果;所述样品参考数据包括多个参考样品的参考信息,所述参考信息包括参考重量及参考尺寸、多个角度的参考宏观图像及多个角度的参考微观图像;输出所述筛查结果,能够有效融合样品的物理属性(重量+尺寸)和视觉特征(宏观图像、微观图像),充分利用多维度信息进行综合判断。采用"先快速筛选,再精确匹配"的计算策略,避免对全量(千万级数据量)数据库进行高计算成本的图像匹配。通过逐级缩小候选集,将计算复杂度从o(n)降低到o(k),其中k< 38、进一步地,在第二重和第三重筛选中,将参考样品的每张图像与候选样品的每张图像进行全量两两匹配。记录所有匹配对中的最大内点数,作为该候选样品的匹配度指标,确保不遗漏最佳匹配。最大内点数系通过盲样验证集里面,重复与不重复样品筛选的100%正确为依据(例如,盲样数据集中分为两类,重复即在库,不重复即不在库,在库数据100件拥有1000条宏观+围观图像)。模型要求100%将在库的判断为有重复,不在库的100%判断为不重复。重量容差、宏观图像内点数阈值、微观图像内点数阈值等关键参数可根据应用场景灵活配置。支持不同精度要求和计算资源限制下的参数调整,提高系统的适应性和实用性。其中,在任一筛选阶段,如果候选集为空,立即终止流程,避免不必要的计算。通过条件判断实现计算资源的优化利用。 39、进一步地,本发明实施例根据第一重筛选中的重量绝对误差,动态调整第二重和第三重筛选的内点数阈值;重量误差越小,说明样品越相似,可以适当降低图像匹配阈值。形成重量与图像匹配的协同机制,进一步提高筛选精度和效率。 40、在宏观图像以及微观图像的匹配筛选中,不仅统计内点数,还评估匹配质量:计算匹配点的空间分布均匀性和匹配点对的几何一致性;基于质量评估结果,对内点数进行修正,使得有效提高判断的准确性和鲁棒性,避免仅依赖内点数数量带来的误判。 41、上述说明仅是本发明实施例技术方案的概述,为了能够更清楚了解本发明实施例的技术手段,而可依照说明书的内容予以实施,并且为了让本发明实施例的上述和其它目的、特征和优点能够更明显易懂,以下特举本发明的具体实施方式。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com