
一种基于跨模态融合的软件漏洞检测方法及存储介质
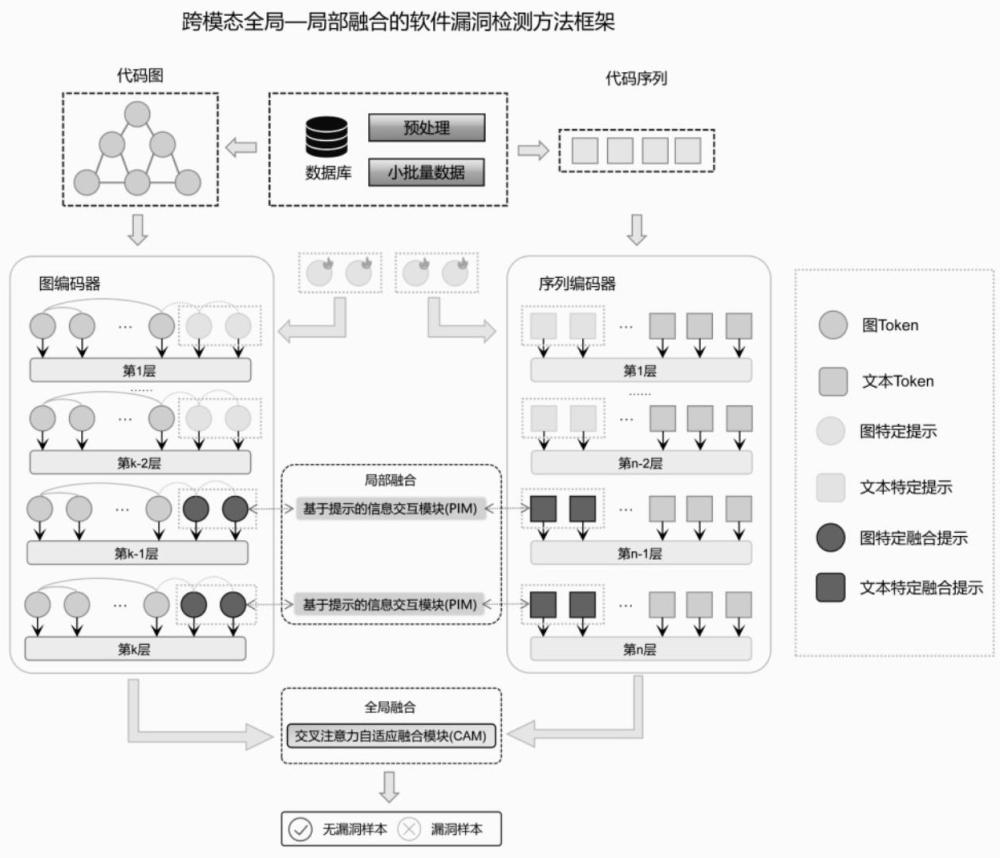
本发明主要涉及到软件开发与设计,特指一种基于跨模态融合的软件漏洞检测方法及存储介质。
背景技术:
1、软件漏洞(software vulnerability)是指软件在设计、编码或配置阶段引入的安全缺陷,可能被恶意攻击者利用以实现非授权访问、数据泄露、拒绝服务等恶意目的,造成重大经济损失乃至社会安全威胁。当前基于深度学习的漏洞检测方法已在学术界和工业界得到广泛关注,主要包括:
2、基于序列的代码漏洞检测方法,其将源代码视为自然语言文本序列,通过词法分析(分词)将代码切分为token序列输入神经网络模型进行特征提取和漏洞预测。如循环神经网络(rnn/lstm)方法:早期代表工作vuldeepecker开创性地使用长短期记忆网络(lstm,long short-term memory)对代码片段进行建模,成功检测多种真实世界漏洞,相比传统静态分析工具展现出显著更优的检测精度。lstm通过门控机制(输入门、遗忘门、输出门)解决普通rnn的长程梯度消失问题,但其序列化处理方式仍难以捕获跨越长距离程序结构的语义依赖。sysevr采用双向lstm(bi-lstm)结合注意力机制处理代码序列,前向lstm捕获从左到右的上下文,后向lstm捕获从右到左的上下文,注意力机制则通过计算序列中不同位置的相关性得分,自适应地加权聚合全局信息,有效提升了语义特征的表达质量。又如预训练代码大语言模型方法:随着大规模预训练语言模型在代码理解任务中展现出巨大潜力,研究者开始将预训练代码模型应用于漏洞检测。linevd在漏洞数据集上微调codebert模型,利用其在代码语料上预训练获得的语义知识基础,通过微调适应漏洞检测的下游任务,实现了更细粒度的漏洞特征提取。codebert基于transformer编码器架构,采用掩码语言建模(mlm,masked language modeling)和替换token检测(rtd,replaced token detection)的双任务联合预训练,在自然语言和编程语言双模态数据上进行训练,具备较强的代码语义理解能力。unixcoder是一种统一跨模态预训练模型,通过掩码注意力矩阵和前缀适配器控制模型行为,利用抽象语法树和代码注释作为跨模态内容增强代码表征,在多项代码相关任务上取得最优性能;unixcoder采用12层的堆叠transformer架构,通过掩码语言建模和代码-注释对齐等代理任务的联合优化进行预训练。在生成式大语言模型的探索方面,有研究者通过人工设计的多样化提示模板驱动chatgpt完成漏洞识别任务,验证了生成式模型在该领域的可行性;vul-rag通过检索增强生成技术进一步展示了大语言模型在漏洞检测场景中的潜力。
3、基于图的代码漏洞检测方法,其是将源代码转换为图结构表示,以代码图作为模型输入,利用图神经网络学习图拓扑和节点/边特征,捕获代码的结构化依赖关系。其中:
4、代码图表示类型一般包括:
5、·抽象语法树(ast,abstract syntax tree):编译器对源代码进行词法分析和语法分析后生成的树状结构,节点表示语法单元(表达式、语句、声明等),边表示语法单元之间的父子包含关系。ast完整保留了代码的语法结构信息。
6、·控制流图(cfg,control flow graph):以基本块为节点、控制转移关系为边的有向图,表示程序执行过程中所有可能的执行路径。基本块是一段不存在分支的连续指令序列。cfg揭示了程序的执行顺序和分支结构。
7、·数据依赖图(ddg,data dependence graph):表示程序中变量定义和使用之间的依赖关系。若语句s1对变量v进行定义,语句s2使用该定义,则存在一条从s1到s2的数据依赖边。数据依赖关系对追踪数据传播路径(如污点分析)至关重要。
8、·程序依赖图(pdg,program dependence graph):融合控制依赖图(cdg)和数据依赖图(ddg),以语句或基本块为节点,边同时表示控制依赖和数据依赖两种关系,完整反映了程序的依赖结构。
9、·代码属性图(cpg,code property graph):将ast、cfg和pdg的信息融合为统一的异构图结构,节点保留语法特征(变量类型、操作符等)和上下文信息,边标注控制流、数据流或语法关系。cpg提供了全方位的代码结构和语义视角。
10、图神经网络(gnn)方法一般包括:
11、devign将代码转换为ast、cfg、ddg和自然代码序列图,使用门控图神经网络(ggnn)从多种代码图中提取结构知识,并结合卷积神经网络(cnn)进一步提升特征提取能力。ggnn通过门控循环单元(gru)递归地更新节点隐藏状态,但每次迭代仅聚合邻接节点的信息。ample针对gnn在大型代码图上的失效问题,提出基于规则的图简化策略——通过去除与特定分析无关的节点和边,降低图规模,然后使用基于注意力的gnn从简化后的图结构中提取知识。reveal将代码转换为代码属性图,使用gru和ggnn进行特征提取,专注于检测代码中的深层逻辑缺陷。coca利用对比学习增强基于gnn的漏洞检测,通过最大化同类型漏洞样本之间的特征相似度、最小化与异类样本之间的相似度,学习更具判别力的代码表征。
12、graph transformer:为解决经典gnn在建模全局图结构方面的限制,graphtransformer被引入代码图学习。graph transformer采用transformer风格的架构,核心由结构感知的多头自注意力机制和前馈神经网络(ffn)构成。结构感知的自注意力首先聚合邻居节点的特征,然后基于跨所有节点的自注意力分数进行加权聚合。graph transformer在更新每个节点表示时,通过计算全局注意力分数同时关注其直接邻居和图中远距离节点,隐式捕获全局依赖信息;在结构感知自注意力和ffn之间引入残差连接,缓解深层graphtransformer中梯度弥散的潜在问题。
13、但现有方法仍面临两个核心困境:其一,基于代码序列的单模态方法(以代码大语言模型为代表)难以捕获代码的结构化语义依赖(如控制依赖和数据依赖);其二,基于代码图的单模态方法(以图神经网络为代表)缺乏对代码文本语法粒度和上下文程序逻辑的深层语义理解。已有实证研究表明,序列模型更擅长检测与语法相关的漏洞类型(如格式化字符串外部控制cwe-134),而图模型更擅长识别具有结构依赖特征的漏洞类型(如资源未正确关闭或释放cwe-404)。
14、为了解决上述单模态方法的固有限制,研究者开始探索多模态学习策略,同时提取代码序列特征和代码图结构特征进行融合检测。如多模态学习方法,该方法旨在融合llm的语义理解能力和gnn的结构理解能力,实现更全面的漏洞检测。基本原理是将预训练llm和gnn构造为两个独立分支,分别从代码序列和代码图中提取特征,然后通过加和或拼接等方式组合两种编码表示,输入多层感知机进行漏洞预测。
15、然而,现有跨模态融合方案存在两方面的根本性缺陷:
16、一是跨模态交互浅层化,在特征提取阶段各模态分支相互孤立,仅在节点初始化的浅层环节进行交互,丧失了在深层特征提取过程中持续相互引导的机会;编译/解析过程将代码从文本转化为图结构时,丢失了细粒度的语义上下文信息→预训练代码llm仅被用于初始化图节点嵌入——为每个节点分配一个初始特征向量→llm分支和gnn分支随后进入完全独立的深层特征提取阶段→在多层transformer编码过程中,llm分支的序列表示逐步融合更深层的上下文语义,但无法感知代码图结构(如数据依赖边指向、控制流分支条件等)作为语义约束→同时,gnn分支的节点表示在聚合邻接信息时无法感知节点对应token的深层语义意图和上下文关系→两种模态的互补知识无法在特征提取的递进过程中持续交换和增强→llm分支可能对结构可疑但语义表面正常的模式漏检;gnn分支可能对图结构合法但语义异常的操作误判→跨模态交互浅层化导致互补信息利用率低下,深层特征缺乏跨模态引导,检测精度受限。
17、二是决策融合静态化,采用固定权重策略融合不同模态的表示,忽略了不同漏洞类型对不同模态的敏感度存在显著差异——语法敏感型漏洞的漏洞模式主要体现在语义特征中,而结构依赖型漏洞则高度依赖基于图的数据流分析。漏洞类型的多样性和模态敏感性差异是代码安全领域的固有属性→语法敏感型漏洞的检测信号主要存在于代码文本token序列的表面模式中(如格式化字符串参数来自外部输入)→结构依赖型漏洞的检测信号主要存在于程序的依赖关系和拓扑结构模式中(如资源获取和释放的配对关系)→固定权重融合本质上是对全局数据集的单一模态重要性估计,不能针对单个输入样本的特征动态调整→在语法敏感型漏洞样本上,序列分支应获得更高权重但其权重被固定为0.2,结构分支噪声被放大→在结构依赖型漏洞样本上,图分支应获得更高权重但其权重已固定,序列分支的语义噪声无法抑制→静态固定权重导致不同漏洞类型上的融合非最优,部分类型性能退化甚至劣于单模态方法。
18、也就是说,现有技术仍存在以下技术不足之处:
19、1、跨模态特征提取阶段缺乏深层双向交互机制;现有跨模态漏洞检测方法(如vul-lmgnn)将代码大语言模型(llm)和图神经网络(gnn)构造为两个独立分支进行特征提取。在特征提取的核心阶段,llm分支无法感知图结构的引导信息(如数据依赖流向),gnn分支无法感知语义上下文信息(如变量语义意图),导致两种模态的知识不能相互促进、互为补充。llm分支缺失的结构约束使其可能将语义上正确但结构上可疑的模式(如未验证的指针使用)漏检;gnn分支缺失的语义上下文使其可能将结构上合法但语义上异常的操作(如格式化字符串参数来源不明)误判为安全。
20、这是因为现有方法的跨模态信息交互被限制在节点初始化的单一环节。vul-lmgnn在构建代码属性图后,仅利用预训练代码语言模型初始化图中的节点嵌入,随后llm和gnn分支即进入相互独立的特征提取过程。在这一设计中,交互发生在节点嵌入初始化的浅层阶段,而非核心特征提取阶段。从模态互补机制的技术本质分析,语义特征和结构特征的互补价值应当在多层特征提取的递进过程中持续发挥作用——低层特征需要语义引导来区分相似结构的不同含义,高层特征需要结构约束来过滤语义可能的偏差。将交互仅置于初始化环节,等同于在特征提取的初始时刻注入一次跨模态信息后,便让两个分支沿各自的轨迹独立演化。由于语义表征空间和结构表征空间在分布特性上存在显著差异(语义空间关注符号共现和上下文模式,结构空间关注拓扑关系和邻接传递),在无持续交互的情况下,二者的特征表示逐渐“漂移”,互补性逐步减弱,最终在高层语义表示中已难以保持跨模态的协同效用。
21、2、跨模态决策融合采用静态固定权重策略;以vul-lmgnn为代表的方法在决策阶段采用固定权重融合策略——通过一个调谐参数λ=0.8赋予图分支0.8的权重,赋予代码序列分支0.2的权重。这种“一刀切”的固定权重设计忽略了一个关键事实:漏洞模式具有模态特异显著性。语法敏感型漏洞的检测信号主要体现在语义特征中(序列分支应被赋予更高权重),结构依赖型漏洞的检测信号主要体现在图结构特征中(图分支应被赋予更高权重)。固定权重无法根据输入样本的特征动态调整,导致在不同类型漏洞上的检测性能既不稳定也不最优。
22、这是因为静态融合的数学形式隐含地假定了所有输入样本遵循同一模态重要性分布。vul-lmgnn的固定插值融合机制隐式地假设了所有代码样本的模态重要性服从完全相同的先验分布。从统计学习角度分析,此假设在漏洞检测场景中不成立——cwe分类体系下不同类型的漏洞在多模态特征空间中的分布模式迥异:对于语法主导型漏洞(如格式化字符串漏洞cwe-134),漏洞特征集中在代码文本表面的异常模式(如用户可控数据直接流向格式化函数),序列模态信噪比远高于图结构模态;对于结构主导型漏洞(如资源泄露cwe-404),漏洞特征隐藏在跨函数的资源获取-释放配对关系和异常路径的模式组合中,图结构模态信噪比远高于序列模态。用单一固定权重去匹配这两类截然不同的任务分布,必然导致至少一类任务的预测信息折损和检测精度退化。
23、3、在特定漏洞类型上存在性能退化甚至优于单模态方法极少的窘境;由于上述两个缺陷的叠加效应,现有跨模态方法在部分漏洞类型上不仅未能体现多模态融合的互补优势,反而出现性能退化。vul-lmgnn在cwe-125(越界读取)和cwe-476(空指针解引用)等特定类型上的检测精度低于单一序列方法svuld或单一图方法deepdfa,其根本原因在于不充分的跨模态融合机制无法建立有效的模态间语义关联,在需要同时依赖语义推理和结构追踪的复杂漏洞场景中整合能力欠佳。
24、这是因为浅层交互与静态融合的复合效应导致多模态整合不完全,互补信息未被充分利用。在同时存在浅层交互和静态融合的系统中,两类缺陷会产生复合效应,使得特定漏洞类型的检测性能相较单模态方法出现退化。以空指针解引用(cwe-476)为例:有效检测需要llm识别“指针在使用前未经验证”的语义模式,同时需要gnn追踪从指针初始化失败点到使用点的数据依赖路径。在浅层交互的设计下,llm在深层特征提取阶段无法获得图结构关于数据依赖路径的持续“引导”,可能导致语义异常信号被无关上下文的表征所“稀释”;gnn在深层阶段无法基于语义信息对图路径进行剪枝,导致关键路径淹没在图结构噪声中。而在静态融合阶段,固定的模态权重又无法根据cwe-476的模态敏感性(语义和结构同等重要)进行动态调节,最终整合决策时两个模态的互补信息均部分丧失,检测效果甚至不如一个优秀的单模态模型。
25、4、传统图神经网络在捕获代码长距离依赖方面存在表达能力瓶颈;在代码图表示学习方面,经典gnn(如ggnn、gat)的内置消息传递机制在每次迭代中仅能捕获一阶邻居特征,在多跳场景中易产生过平滑(over-smoothing)和性能退化问题,难以对代码图中跨越多个节点的长距离控制和数据依赖关系进行有效建模。
26、这是因为传统gnn的归纳偏置限制了其建模全局图拓扑的能力。ggnn等经典gnn的归纳偏置(inductive bias)是基于定域性(locality)假设设计的——它们通过递归地聚合局部邻域信息来更新节点表示,使得每个节点的感知域受限于迭代层数内的邻域范围。对于程序依赖图(pdg)中以跨越多个函数调用层次和复杂控制流分支的长距离依赖关系,经典gnn需要堆叠极深的层数才能捕获,而深厚的gnn层数又容易引发过平滑问题(所有节点表示趋同)和梯度弥散,最终反而损害了区分性特征的提取能力。graph transformer通过结构感知的多头自注意力机制计算图中任意节点对的注意力分数,为每个节点提供全局的感知域,有效解决长距离依赖建模问题。传统gnn的消息传递机制基于定域性归纳偏置设计→每个节点在单次迭代中仅聚合其一阶邻居的特征信息→对于代码图中跨越多个函数调用层级的依赖路径(如污点源在函数a、经函数b中转、最终到达函数c的汇聚点),有效感知需堆叠与路径长度成正比的gnn层数→深厚的gnn层数引发过平滑问题(所有节点表示趋于一致)和梯度弥散(反向传播信号逐层衰减)→模型难以区分远距离依赖路径上的关键节点与无关节点,所有节点的高层表示高度同化→传统gnn对代码长距离依赖的建模能力不足,复杂漏洞的依赖路径特征难以被有效提取。
技术实现思路
1、本发明要解决的技术问题就在于:针对现有技术存在的技术问题,本发明提供一种原理简单、适用范围广、精度高的基于跨模态融合的软件漏洞检测方法及存储介质。
2、为解决上述技术问题,本发明采用以下技术方案:
3、一种基于跨模态融合的软件漏洞检测方法,其包括:
4、代码双模态表示,将输入的源代码函数转换为代码序列token和程序依赖图pdg两种模态表示;
5、代码序列表示学习,以预训练代码大语言模型llm为序列编码器,从代码序列中逐层提取深层语义特征;
6、代码图表示学习:以graph transformer为图编码器,从程序依赖图中逐层提取结构特征;
7、基于提示的局部信息交互pim:在llm分支和graphtransformer分支的最后层分别注入可学习提示token,通过交叉注意力机制实现两种模态之间的深层双向知识交换;
8、交叉注意力自适应全局融合cam,在特征提取完成后,通过专门的交叉注意力机制动态计算语义表示和结构表示的重要性分数,基于输入代码特征自适应调节不同模态在最终决策中的融合权重。
9、作为本发明的进一步改进:在代码双模态表示的步骤中包括:
10、步骤s101:使用基于字节对编码bpe的子词分割算法对源代码函数进行分词处理;
11、步骤s102:将分词结果转换为token索引序列,作为代码序列表示;在序列首部添加特殊分类token([cls]),用于后续提取全局序列语义特征;
12、步骤s103:调用静态分析工具joern(v4.0.95)解析源代码函数,生成程序依赖图pdg;pdg的节点表示程序语句或表达式,边表示控制依赖或数据依赖关系;joern通过docker容器化部署,以dot格式导出图数据;
13、步骤s104:对pdg进行形式化表示:,其中为节点集合,每个节点具有原始代码文本属性;为边集合,表示边类型;
14、步骤s105:使用unixcoder的分词器对每个图节点的源代码文本进行编码,获得节点初始嵌入表示。
15、作为本发明的进一步改进:在代码序列表示学习的步骤中包括:
16、步骤s201:将token索引序列输入unixcoder预训练模型的嵌入层,得到初始token嵌入矩阵;
17、步骤s202:通过12层堆叠transformer进行前向传播;每层执行的操作包括:
18、·多头自注意力mhsa:每个token的表示通过计算与序列中所有token的注意力分数进行加权聚合;
19、·层归一化:对自注意力输出进行归一化,稳定训练过程;
20、·前馈神经网络ffn:两层全连接网络,中间使用gelu激活函数;
21、·残差连接:在mhsa和ffn的输出上分别添加残差连接;
22、步骤s203:记录每一层的输出隐藏状态,特别是最后层的输出,用于pim模块的跨模态信息交互;
23、步骤s204:最终层输出的[cls]位置对应的隐藏向量作为全局序列语义表示。
24、作为本发明的进一步改进:在代码图表示学习的步骤中包括:
25、步骤s301:根据节点初始嵌入构建graphtransformer的输入;
26、步骤s302:每一层graphtransformer执行以下操作:
27、(a)结构感知多头自注意力:
28、对每个节点,设其隐藏状态为;
29、对于每个注意力头,计算查询,键,值();
30、注意力分数:;
31、聚合输出:;
32、(b)残差连接与层归一化:;
33、(c)前馈神经网络:;
34、(d)残差连接与层归一化:;
35、步骤s303:记录每一层的输出隐藏状态,特别是最后层的输出,用于pim模块;
36、步骤s304:对最终层输出的所有节点隐藏状态进行平均池化,得到全局图结构表示向量。
37、作为本发明的进一步改进:在基于提示的局部信息交互pim的步骤中包括:
38、步骤s401:提示token定义与初始化;
39、步骤s402:交叉注意力融合操作,在最后层的每一层执行;
40、步骤s403:逐层递归执行。
41、作为本发明的进一步改进:所述步骤s401中,定义三类可学习提示token,初始化为服从的随机向量:
42、:文本特定提示,用于从llm分支抽象聚合文本语义特征;
43、:图特定提示,用于从graphtransformer分支抽象聚合图结构特征;
44、:模态交互提示,作为模态无关的查询向量,在跨模态交互中同时关注两类模态的聚合表示。
45、作为本发明的进一步改进:所述步骤s402中,对于第层(,对应的graphtransformer层为),包括:
46、(2a)提示聚合——提取各模态的紧凑表示:
47、使用作为query,作为key和value,通过多头交叉注意力聚合文本模态紧凑特征:
48、
49、使用作为query,作为key和value,聚合图模态紧凑特征:
50、
51、(2b)跨模态查询——模态交互提示同时关注两类模态:
52、使用作为query,分别对两类紧凑表示进行交叉注意力,获得跨模态的语义补充:
53、
54、
55、(2c)融合提示生成——mlp生成注入各模态的提示向量:
56、通过两层mlp将跨模态信息转换为可注入的融合提示:
57、
58、(2d)提示注入——将融合提示注入对应分支:
59、在llm分支的下一层输入中,将添加到token序列的最前方,与原始token序列拼接后作为下一层transformer的输入;
60、在graphtransformer分支的下一层输入中,将作为额外的键值对加入自注意力的k和v矩阵中。
61、作为本发明的进一步改进:在交叉注意力自适应全局融合cam的步骤中包括:
62、步骤s501:特征投影;
63、分别使用可学习投影矩阵将两种模态的表示映射到同一查询空间:
64、
65、其中为可学习参数矩阵,维度;
66、步骤s502:交叉注意力计算,动态重要性评分;
67、步骤s503:自适应融合权重计算;
68、通过门控机制自动计算最终的动态融合权重:
69、
70、其中为可学习参数,为偏置项,表示向量拼接;的取值范围为;
71、步骤s504:动态加权融合;
72、
73、步骤s505:漏洞预测;
74、将融合表示输入多层感知机分类器:
75、第一全连接层:linear(),激活函数relu;
76、第二全连接层(分类头):linear(),激活函数softmax。
77、作为本发明的进一步改进:所述步骤s502中,使用交叉注意力机制计算两种模态相互之间的重要性评分:
78、(a)语义→结构注意力:以为query,为key和value:
79、
80、(b)结构→语义注意力:以为query,为key和value:
81、。
82、本发明还提供了一种存储介质,所述存储介质能够被计算机或处理器读取,所述存储介质中存储有用来执行上述任意一项所述方法的计算机程序。
83、与现有技术相比,本发明的优点在于:
84、1、本发明的基于跨模态融合的软件漏洞检测方法及存储介质,原理简单、适用范围广、精度高,本发明是一种在特征提取阶段实现深层跨模态交互、在决策融合阶段实现自适应权重调节的跨模态漏洞检测方法,对于提升自动化漏洞检测的精度和覆盖率、增强软件系统的安全保障能力,具有极其重要的理论价值和现实意义。
85、2、本发明的基于跨模态融合的软件漏洞检测方法及存储介质,设计了一种深层跨模态双向信息交互机制,在llm分支和gnn分支的多层特征提取过程中持续进行知识交换——将llm分支各层的语法语义知识注入gnn分支以引导结构聚合,同时将gnn分支各层的结构依赖知识注入llm分支以约束语义表征,从特征提取的源头解决跨模态交互浅层化的问题。
86、3、本发明的基于跨模态融合的软件漏洞检测方法及存储介质,设计了一种基于输入内容自适应的跨模态动态权重融合机制,根据输入代码样本的模态敏感特征自动调节不同模态分支在最终决策中的贡献权重——对于语法敏感型漏洞自动提升序列分支权重,对于结构依赖型漏洞自动提升图分支权重,从决策融合层面解决静态融合的模态错配问题。
87、4、本发明的基于跨模态融合的软件漏洞检测方法及存储介质,采用了graphtransformer代替传统ggnn作为图结构编码器,利用其结构感知的全局自注意力机制突破传统消息传递的定域性限制——通过计算图中任意节点对的注意力分数实现对跨越任意距离依赖关系的全局建模,缓解过平滑和长距离依赖捕获的难题。
88、5、本发明的基于跨模态融合的软件漏洞检测方法及存储介质,通过局部融合和全局融合的协同作用,使多模态互补信息在特征提取和决策融合两个层面得到充分整合,在各种漏洞类型上实现一致且显著的精度提升,避免特定类型上的性能退化。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com