
三维混合键合与可重构数据流大模型推理加速架构及方法与流程
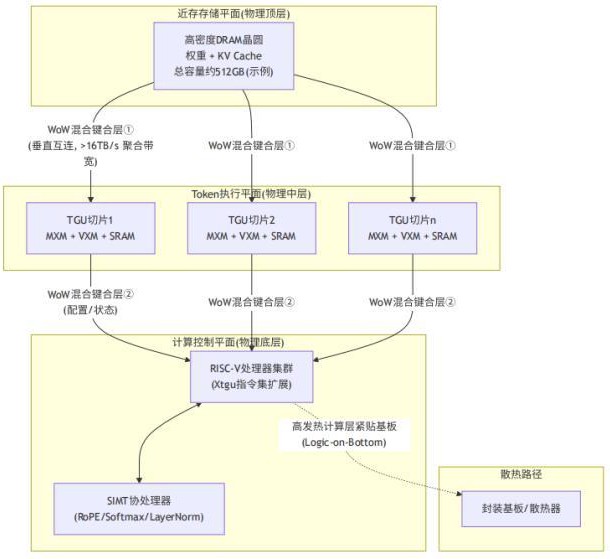
本发明属于集成电路设计与人工智能计算,具体涉及三维混合键合与可重构数据流大模型推理加速架构及方法。
背景技术:
1、随着gpt-4、deepseek、qwen等大语言模型参数量持续增长,业务对上下文窗口需求已达1m tokens级别,现有通用gpu与专用推理芯片存在四大核心问题:
2、1、存储墙瓶颈:推理kv缓存随上下文长度线性扩张,传统gpu依赖hbm 与片外总线,带宽、容量无法支撑百万级上下文;片外dram与计算单元间频繁数据搬运造成巨大功耗损耗。
3、2、阶段计算效率失衡:transformer推理分为预填充(prefill)、解码(decode)两阶段,prefill为矩阵密集运算,decode为访存密集、单批量负载;gpu 统一硬件架构无法同时适配两类异构负载,计算单元利用率偏低。
4、3、先进工艺与封装受限:cowos封装、hbm存储器等核心技术存在出口管制;国内制程、片上存储、先进封装存在代差,仅依靠工艺迭代难以追平国际性能。
5、4、数据流固化、适配性差:现有专用语言处理单元采用静态数据流架构,编译后硬件拓扑不可更改,无法快速适配transformer网络结构迭代与多样化控制算子。
6、综上,行业亟需一套适配国产工艺、缓解存储墙、兼顾高低访存负载、具备动态重构能力的大模型推理硬件架构。
技术实现思路
1、本发明的目的在于提供三维混合键合与可重构数据流大模型推理加速架构及方法,以解决上述背景技术中提出的现有技术存储带宽不足、两阶段推理硬件适配差、先进封装受限、数据流灵活性不足的问题。
2、为实现上述目的,本发明提供如下技术方案:三维混合键合与可重构数据流大模型推理加速架构:
3、近存存储平面,设于物理顶层,集成高密度dram晶圆,用于存储模型权重与kvcache;
4、token执行平面,设于物理中间层,包含多组令牌生成单元tgu切片,单个tgu切片集成矩阵乘阵列mxm、向量运算单元vxm与本地sram;所述tgu为软件可重构硬件,支持prefill、decode两种数据流模式切换;
5、计算控制平面,设于物理底层,包含risc-v处理器集群与simt协处理器;
6、混合键合互连层,采用晶圆对晶圆wow混合键合技术垂直互连三层平面,层间聚合互连带宽大于16tb/s。
7、优选的,所述tgu在prefill模式配置为脉动阵列拓扑,提升矩阵乘法吞吐;在decode模式配置为广播-归约拓扑,降低单token解码延迟。
8、优选的,所述risc-v集群搭载自定义xtgu指令集扩展,包含配置tgu模式的cfg_tgu指令、设置矩阵运算维度的set_tgu_shape指令、发起数据搬运的tgu_dma指令、计算同步的wait_tgu指令。
9、优选的,还包含片内ucie互连,将多颗计算裸片网格互联构建统一uma地址空间,各裸片tgu可跨裸片访问全部dram存储。
10、优选的,还包含片间yes link互连,搭载多路serdes端口并兼容类rdma协议,构建胖树或环形多卡互联拓扑,实现跨卡直接内存访问。
11、优选的,所述risc-v与simt协处理器在decode阶段负责 rope、softmax、layernorm非规整算子运算,tgu仅执行矩阵、向量规整运算,实现异构硬件分工计算。
12、优选的,整体采用logic-on-bottom倒置堆叠结构,高发热的计算控制平面、token执行平面贴近封装基板布置,优化散热性能。
13、另一方面,三维混合键合与可重构数据流大模型推理加速方法,应用权利要求1-7任一项所述架构,其特征在于,包含prefill步骤与decode步骤:
14、prefill步骤:risc-v集群对模型权重分块,通过ucie互连将权重加载至tgu本地sram,配置tgu为脉动阵列模式,借助wow互连读取输入数据完成批量矩阵运算,生成kvcache存入顶层dram;
15、decode步骤:risc-v与simt处理当前token位置编码,切换tgu至广播归约模式,tgu通过wow互连随机读取历史kv cache,自回归运算生成输出token并更新kv缓存。
16、优选的,prefill步骤采用sram双缓冲机制,tgu执行当前分块运算时并行预加载下一分块权重,计算与数据传输并行重叠。
17、优选的,通过xtgu指令集实现硬件数据流软件管控,编译器将深度学习算子转换为由cfg_tgu、set_tgu_shape、tgu_dma、wait_tgu构成的指令序列。
18、与现有技术相比,本发明的有益效果是:
19、(1)wow 混合键合互连密度较传统tsv提升10倍,层间带宽突破16tb/s,皮秒级垂直访问延迟,完美适配decode阶段海量随机小包kv缓存读取,单会话可稳定运行1m token超长上下文推理。
20、(2)倒置堆叠散热结构降低芯片工作温度;垂直铜铜键合寄生参数极低,大幅削减数据传输i/o功耗;硬件分层分工规避gpu缓存一致性协议开销,整体系统能效比相较通用gpu提升明显。
21、(3)依托risc-v自定义xtgu指令集动态切换tgu硬件拓扑,摆脱传统专用推理芯片静态数据流固化缺陷,快速适配各类transformer变体、新算子迭代,软硬件协同灵活度高。
22、(4)采用“多小计算裸片+wow先进封装”系统级创新路线,无需依赖最先进逻辑制程;依托国内成熟7nm逻辑工艺、国产晶圆混合键合封装即可实现对标国际高端芯片的推理性能,突破cowos、hbm管制限制。
23、(5)tgu专门负责token生成核心规整运算,控制平面处理不规则算子,软硬边界明确;ucie裸片互联、yes link多卡互联可灵活扩展存储与算力,支持单机超大模型、多机分布式推理。
1.三维混合键合与可重构数据流大模型推理加速架构,其特征在于,
2.根据权利要求1所述的三维混合键合与可重构数据流大模型推理加速架构,其特征在于,所述tgu在prefill模式配置为脉动阵列拓扑,提升矩阵乘法吞吐;在decode模式配置为广播-归约拓扑,降低单token解码延迟。
3.根据权利要求1所述的三维混合键合与可重构数据流大模型推理加速架构,其特征在于,所述risc-v集群搭载自定义xtgu指令集扩展,包含配置tgu模式的cfg_tgu指令、设置矩阵运算维度的set_tgu_shape指令、发起数据搬运的tgu_dma指令、计算同步的wait_tgu指令。
4.根据权利要求1所述的三维混合键合与可重构数据流大模型推理加速架构,其特征在于,还包含片内ucie互连,将多颗计算裸片网格互联构建统一uma地址空间,各裸片tgu可跨裸片访问全部dram存储。
5.根据权利要求1所述的三维混合键合与可重构数据流大模型推理加速架构,其特征在于,还包含片间yes link互连,搭载多路serdes端口并兼容类rdma协议,构建胖树或环形多卡互联拓扑,实现跨卡直接内存访问。
6.根据权利要求1所述的三维混合键合与可重构数据流大模型推理加速架构,其特征在于,所述risc-v与simt协处理器在decode阶段负责 rope、softmax、layernorm非规整算子运算,tgu仅执行矩阵、向量规整运算,实现异构硬件分工计算。
7.根据权利要求1所述的三维混合键合与可重构数据流大模型推理加速架构,其特征在于,整体采用logic-on-bottom倒置堆叠结构,高发热的计算控制平面、token执行平面贴近封装基板布置,优化散热性能。
8.三维混合键合与可重构数据流大模型推理加速方法,其特征在于,应用权利要求1-7任一项所述架构,其特征在于,包含prefill步骤与decode步骤:
9.根据权利要求8所述的三维混合键合与可重构数据流大模型推理加速方法,其特征在于,prefill步骤采用sram双缓冲机制,tgu执行当前分块运算时并行预加载下一分块权重,计算与数据传输并行重叠。
10.根据权利要求8所述的三维混合键合与可重构数据流大模型推理加速方法,其特征在于,通过xtgu指令集实现硬件数据流软件管控,编译器将深度学习算子转换为由cfg_tgu、set_tgu_shape、tgu_dma、wait_tgu构成的指令序列。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com