
基于智能语音检索的影视素材拷贝及分类索引建立方法与流程
本发明涉及影视素材管理,尤其涉及一种基于智能语音检索的影视素材拷贝及分类索引建立方法。
背景技术:
1、影视素材管理是影视制作、广告创意及短视频二创领域的核心环节,后期人员需要从海量原始拍摄素材中快速定位目标片段并完成归类整理。当前行业内普遍采用的工作流程是先将存储卡中的素材拷贝至工作站固态硬盘,待拷贝全部完成后,由后期助理或场记人员根据场记单手动对素材进行分类标注,标注完成后导入媒体资产管理软件建立索引,此后才能开始检索和剪辑。这一流程中,拷贝、分类和检索三个环节完全串行,拷贝过程本身不产生任何索引数据,全部素材的分类和标注均依赖人工在拷贝完成后逐一完成,导致从拍摄结束到素材可用之间存在显著的时间空窗。在检索手段方面,现有系统主要依赖文件名搜索、元数据字段筛选或基于自动语音识别技术将音轨转为文本后进行关键词匹配。
2、然而,文件名搜索要求用户对素材命名规则有精确了解,元数据筛选仅能覆盖摄像机型号、拍摄日期等有限维度,无法支持对画面内容和对话语义的检索需求。当用户对素材仅有模糊印象,例如只记得某个角色的声音特质、大致的拍摄场景或部分对话片段时,现有系统缺乏有效的模糊检索和候选指引能力,用户往往需要反复试错或通篇浏览才能定位目标。上述不足使得现有技术难以满足影视后期工作中对素材快速定位和高效管理的实际需求,亟需一种能够在拷贝过程中同步完成分类索引建立,并支持用户以自然语音进行精确查找与模糊指引相结合的方法。
技术实现思路
1、本发明克服了现有技术的缺陷,提供了一种基于智能语音检索的影视素材拷贝及分类索引建立方法。
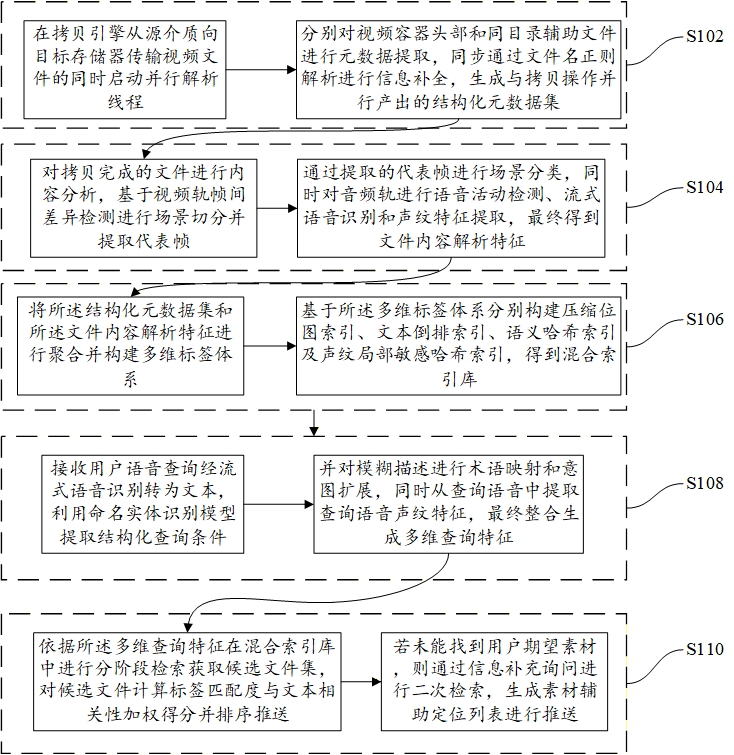
2、为实现上述目的本发明第一方面提供了一种基于智能语音检索的影视素材拷贝及分类索引建立方法,包括:
3、s102,在拷贝引擎从源介质向目标存储器传输视频文件的同时启动并行解析线程,分别对视频容器头部和同目录辅助文件进行元数据提取,同步通过文件名正则解析进行信息补全,生成与拷贝操作并行产出的结构化元数据集;
4、s104,对拷贝完成的文件进行内容分析,基于视频轨帧间差异检测进行场景切分并提取代表帧,通过提取的代表帧进行场景分类,同时对音频轨进行语音活动检测、流式语音识别和声纹特征提取,最终得到文件内容解析特征;
5、s106,将所述结构化元数据集和所述文件内容解析特征进行聚合并构建多维标签体系,基于所述多维标签体系分别构建压缩位图索引、文本倒排索引、语义哈希索引及声纹局部敏感哈希索引,得到混合索引库;
6、s108,接收用户语音查询经流式语音识别转为文本,利用命名实体识别模型提取结构化查询条件,并对模糊描述进行术语映射和意图扩展,同时从查询语音中提取查询语音声纹特征,最终整合生成多维查询特征;
7、s110,依据所述多维查询特征在混合索引库中进行分阶段检索获取候选文件集,对候选文件计算标签匹配度与文本相关性加权得分并排序推送,若未能找到用户期望素材,则通过信息补充询问进行二次检索,生成素材辅助定位列表进行推送。
8、本方案中,所述s102,具体包括:
9、在拷贝引擎从源介质向目标存储器传输视频文件时,通过与数据搬运流水线并行的元数据解析线程,拦截每个视频文件的文件头数据块,根据容器格式分派至对应解析器提取时间码轨道、拍摄日期、编码格式、分辨率和设备标识,生成容器头部元数据字段;
10、将容器头部元数据字段以文件标识符为键存入内存哈希表,同步扫描源介质同目录下的辅助文件,对场记文件以制表符分隔建立列索引映射并逐行提取卷号、场景号、镜次号及起始时间码,对工程文件以流式读取方式遍历元素树提取元数据键值对;
11、将场记文件提取的起始时间码与容器头部提取的时间码轨道进行最近邻搜索对齐,当差值小于预设阈值时将对应场记条目的场次号和镜头号关联至同一文件标识符的内存哈希表条目中;
12、对每个文件的文件名应用预置正则表达式模板集合进行模式匹配,提取机位标识、场次号、镜头号和拍摄次数,将文件名解析结果与内存哈希表中已有元数据字段以加权投票方式进行合并,已有值保留并以文件名解析结果交叉验证,缺失字段直接补入;
13、经过容器头部解析、场记文件对齐和文件名正则补全后,基于内存哈希表中每个文件标识符对应的元数据键值集合生成结构化元数据集。
14、本方案中,所述s104,具体包括:
15、对已落盘的文件进行内容分析,以预设稀疏采样率进行视频抽帧解码,将每帧转换至hsv空间并统计色相分量的归一化直方图,计算相邻采样帧直方图之间的巴氏系数作为帧间差异度量,并通过滑动窗口计算各帧间差异值的均值和标准差;
16、基于帧间差异值的均值和标准差生成动态阈值,将当前帧间差异值与动态阈值进行比较,超过阈值时判定检测到场景切换并标记场景起止位置,对每个场景片段取时间中点对应的帧作为候选代表帧,计算候选代表帧的拉普拉斯方差作为清晰度指标;
17、若候选代表帧的清晰度指标小于预设清晰度阈值,则以候选代表帧为中心向场景片段的首尾两端逐帧搜索,直至找到拉普拉斯方差超过预设清晰度阈值的帧作为当前场景的合格代表帧;
18、将合格代表帧送入轻量级卷积神经网络场景分类器,所述场景分类器以倒残差结构堆叠而成,每个倒残差块包含逐点升维卷积、深度可分离卷积、压缩激励模块和逐点降维卷积,末端经全局平均池化后由全连接层输出各场景类别标签;
19、从视频文件中提取音频流,以预设帧长和帧移提取梅尔频率倒谱系数及一阶差分和二阶差分,拼接为声学特征向量序列后送入基于双向长短期记忆网络的语音活动检测器,经中值滤波和双阈值滞后比较后合并语音段并剔除语音碎片,得到语音片段集合;
20、将每个语音片段的声学特征向量序列送入流式语音识别模型,编码器由多层卷积增强自注意力块堆叠组成,每层包含前馈模块、多头自注意力模块和卷积模块,解码器联合连接时序分类和注意力机制输出带词级时间戳的对白文本;
21、将每个语音片段的声学特征向量序列送入声纹嵌入模型,所述声纹嵌入模型以扩展卷积残差网络为骨干,堆叠多层扩展卷积层并通过注意力统计池化将帧级特征加权聚合为声纹嵌入向量,最终结合场景类型标签和对白文本生成文件内容解析特征。
22、本方案中,所述s106,具体包括:
23、以文件标识符为主键将结构化元数据集与文件内容解析特征关联合并构建多维标签向量,所述多维标签向量包括日期标签、场次标签、镜头标签、设备来源标签及场景类型标签;
24、为所述多维标签向量中的每个离散值建立压缩位图实例,位图内部按文件标识符高位进行分桶,桶内依据数据密度自适应选择数组或位图存储低位,遍历全部文件将标识符设置到对应标签位图中,完成压缩位图索引构建;
25、将每个文件的内容关键词标签列表中的实词作为词典条目,词典以b加树结构组织,每个词条指向按文件标识符升序排列的跳跃表,跳跃表节点记录所述实词在对应文件中的出现频次,得到文本倒排索引;
26、对每个文件的完整对白文本计算固定位数的信息指纹,将文本中各词语哈希值按词权重逐位加权累加后经符号判定生成二值码,等分为多段短码,以每段短码为键建立倒排映射并存储文件标识符及完整二值码,得到语义哈希索引;
27、预生成一组服从标准正态分布的随机投影向量并划分为若干组,将声纹嵌入向量计算与组内各投影向量进行点积运算获取二值码,以二值码为桶标识符将文件标识符及声纹嵌入向量存入对应桶中并构建声纹局部敏感哈希索引;
28、整合所述压缩位图索引、文本倒排索引、语义哈希索引和声纹局部敏感哈希索引生成混合索引库。
29、本方案中,所述s108,具体包括:
30、采集目标用户的语音检索指令,对所述语音检索指令执行声学预处理,对语音检索指令提取梅尔频率倒谱系数、一阶差分和二阶差分,拼接为声学特征向量序列并送入与预构建的流式语音识别模型中进行分析;
31、由所述流式语音识别模型的编码器经多层卷积增强自注意力块处理,解码器联合连接时序分类与注意力机制输出查询文本序列,同时将所述声学特征向量序列并行送入声纹嵌入模型,经扩展卷积残差网络和注意力统计池化聚合为查询语音声纹特征;
32、将查询文本序列以字符嵌入和影视领域预训练词嵌入拼接后送入命名实体识别模型,经双向长短期记忆网络对上下文进行正向和反向时序建模,由条件随机场层结合标签转移矩阵进行全局最优解码,输出初步查询条件;
33、对初步查询条件中各实体逐一执行术语映射,基于术语映射后的查询条件集合进行意图扩展,将缺失或宽泛的维度标记为通配,将匹配到上位标签的场景条件沿同义词图下位扩展,将待定的角色指代条件标定为不启用过滤,形成由确定标签集合和模糊标签集合构成的查询标签结构体;
34、将所述查询标签结构体、查询文本序列及暂存的查询语音声纹特征整合为多维查询特征。
35、本方案中,所述s110,具体包括:
36、基于多维查询特征提取确定标签集合、模糊标签集合和查询文本序列,从混合索引库的压缩位图索引中取出确定标签集合内每个标签值对应的压缩位图实例并执行交集运算,得到基础候选位图,若确定标签集合为空,则将基础候选位图初始化为全集位图;
37、随后处理模糊标签集合,对模糊标签集合中每个模糊标签取值范围内的所有候选标签值对应的压缩位图执行并集运算,生成模糊候选位图,将基础候选位图与所述模糊候选位图进行交集运算,得到标签过滤候选位图;
38、将查询文本序列分词并去除停用词后得到查询关键词列表,对于查询关键词列表中的每个关键词,从混合索引库的文本倒排索引中拉取每个关键词对应的跳跃表,当存在多个查询关键词时,对多个跳跃表执行多路归并求交操作,得到精确匹配文件标识符集合;
39、同时计算查询文本的信息指纹,通过语义哈希索引检索并筛选汉明距离满足预设阈值的文件标识符组成模糊匹配集合,将精确匹配集合与模糊匹配集合取并集后与标签过滤候选位图进行交集运算,得到最终候选文件集;
40、以目标候选文件的多维标签向量中与确定标签集合和模糊标签集合成功匹配的标签数量占查询条件中总标签数量的比值作为标签匹配度分值,基于查询关键词在文件中的词频和逆文档频率加权求和获得文本相关性分值;
41、将标签匹配度与文本相关性按预置权重加权求和得到综合得分并降序排列,将排序后的文件列表及对应的综合得分、场景类型标签、日期标签和代表帧缩略图组装为检索结果页面,推送至用户界面展示。
42、本方案中,所述s110,还包括:
43、若用户浏览检索结果后通过界面反馈未找到期望素材,则启动信息补充询问流程,从当前查询标签结构体中提取已失效或宽泛维度,生成针对拍摄时间段、设备型号、场景环境及角色特征的补充提问,同时询问是否授权启用目标用户的声纹进行匹配检索;
44、接收用户反馈后将用户补充信息经术语映射转换为补充标签条件后与原始有效条件合并,重新执行位图剪枝和文本匹配召回,生成补充候选文件集;
45、若用户授权启用声纹匹配,则从多维查询特征中取出查询语音声纹特征,通过声纹局部敏感哈希索引定位对应哈希桶,提取桶内存储的声纹嵌入向量及关联文件标识符,逐一计算余弦相似度后截取相似度最高的若干文件标识符作为声纹匹配候选集,
46、将补充候选文件集与声纹匹配候选集合并去重后重新计算综合得分并排序,生成素材辅助定位列表进行二次推送。
47、与现有技术相比,本方案通过将素材拷贝操作与多维分类索引构建深度融合,打破了传统工作流程中拷贝、分类、检索三者串行执行的固有模式。提出了“边拷边分类”的技术理念,在拷贝引擎从源介质向目标存储器传输视频文件的同时,并行启动元数据解析线程与内容分析流水线,使得文件拷贝完成之际,其对应的多维标签和混合索引已全部就绪,用户无需任何等待即可直接进行检索,显著压缩了从拍摄素材到可用状态的时间窗口。
48、在索引构建层面,本方案将传统方法中相互孤立的元数据索引与内容特征索引有机整合,构建了涵盖日期标签、场次标签、镜头标签、设备来源标签、场景类型标签、伪说话人标签和内容关键词标签的多维标签体系,并在此基础上建立混合索引库,使得素材画像从单一的文件属性描述扩展为包含拍摄设备信息、场记信息、画面场景类型、对白内容及声纹身份的多维度完整刻画。在检索机制方面,本方案针对现有技术中语音检索手段单一、对模糊查询缺乏支持的问题,设计了基于自然语言理解的多维查询解析流程,能够从用户的语音描述中自动识别电影行业特有术语,并对模糊描述进行术语映射与意图扩展,实现精确查找与模糊指引的有机结合。此外,本方案还在用户对首轮检索结果不满意时引入了信息补充询问与声纹匹配的深层检索机制,进一步提升了素材定位的召回率与准确性,为影视后期素材管理提供了一套从拷贝到检索全链路自动化且兼具灵活性的技术方案。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com