
一种流量控制耦合的多通道AXI直接存储器访问控制器及数据流调度方法与流程
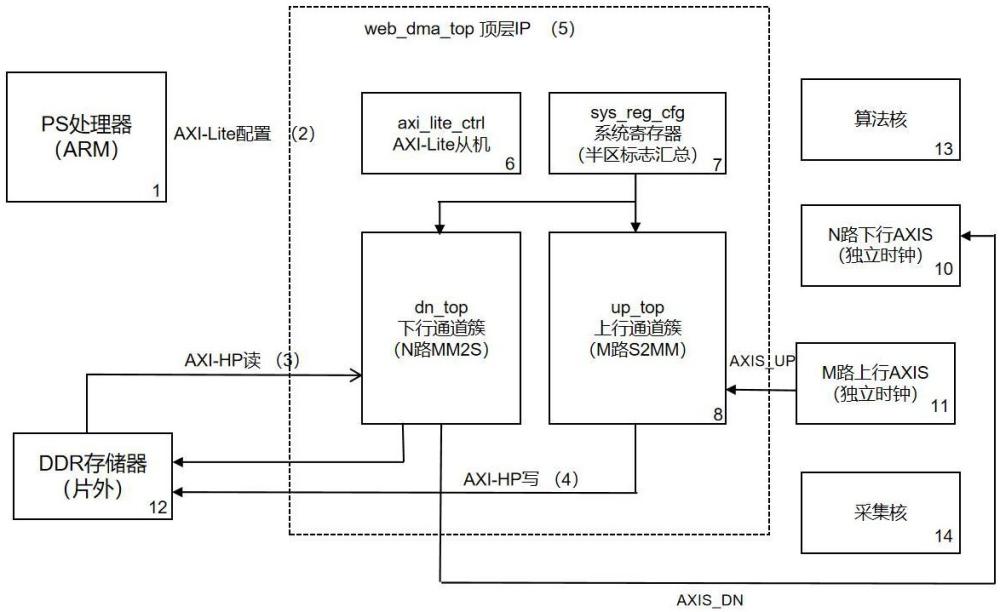
本发明属于集成电路设计与高性能数据搬移,具体涉及一种应用于片上系统(soc)及现场可编程门阵列(fpga)中、连接外部存储器与多路可编程逻辑流式数据通道的多通道直接存储器访问(dma)控制器及数据流调度方法,尤其涉及一种将端到端流量控制信息耦合进多通道仲裁决策、以单一共享存储总线端口为多路流式通道提供数据搬移服务的dma引擎。本发明可广泛应用于多路视频、雷达、5g基带、工业传感器等异构数据流的高速实时搬移场景。
背景技术:
1、直接内存访问(dma)技术允许数据在存储器与外设之间搬移而无需中央处理器(cpu)逐字节参与,是提升数据吞吐率、降低处理器负载的关键手段。在xilinx zynq等异构片上系统中,arm处理器核与可编程逻辑(pl)共享同一物理存储(如ddr存储器),通常通过高性能(hp)axi总线端口由pl侧的dma引擎访问ddr,而处理器通过通用(gp)axi总线端口对dma引擎进行寄存器配置。
2、随着系统数据通道数量的增加,单端口、多通道的dma架构成为主流。在这种架构中,多路独立的流式数据通道(通常采用axi-stream协议)需要竞争同一个共享的axi存储总线主端口以访问ddr。现有技术中,对该共享端口的访问通常采用固定优先级仲裁、轮询仲裁或加权轮询仲裁等方式来决定在某一时刻由哪一路通道占用总线。然而,现有的多通道dma方案在仲裁、描述符管理、上行握手、跨时钟域与突发长度处理等方面仍存在显著技术缺陷。
3、缺陷一,仲裁决策与下游接收能力脱节,导致共享总线带宽浪费及缓冲溢出风险。在存储器到流式通道(下行读出)方向上,现有仲裁器通常仅依据该通道是否存在待处理的传输任务来产生总线请求。但是,即使某通道存在待处理描述符,若其下游axi-stream接收逻辑当前处于反压状态、该通道的数据缓冲fifo已接近写满,则dma引擎从ddr读出的数据将无处存放,轻则造成数据缓冲fifo溢出、数据丢失,重则迫使dma引擎在读出过程中停顿,白白占用本可服务其他通道的共享总线带宽。
4、缺陷二,生产者与消费者之间缺乏无锁协同,存在数据被覆盖的风险。在流式通道到存储器(上行写入)方向上,dma引擎作为数据生产者将流式数据写入ddr中的某块存储区域,处理器作为消费者从该区域读取数据。现有技术多依赖软件维护读写指针、并使用互斥锁或内存屏障来保证生产者不会覆盖消费者尚未读取的数据。这种方式在高速、连续、多通道场景下存在锁开销大、实时性差、易因软件疏忽而发生数据覆盖等问题。此外,每完成一次dma传输,需要cpu读取状态寄存器并更新描述符链,中断频率高,cpu负载重。
5、此外,在仲裁机制方面,已公开的中国专利cn102231142b提出了一种带有仲裁器的多通道dma控制器,该控制器包含通道仲裁器,可以在多个dma通道同时发起dma请求时根据各通道的优先级选择下一个进行数据传输的通道。然而,该方案仍属于基于优先级的传统仲裁范畴,仲裁决策仅依据通道优先级,并未将各通道的端到端流量控制状态(如下游接收端的反压状态、通道数据缓冲的占用情况、环形缓冲区的消费进度等)作为仲裁请求的有效门控条件。当某通道下游处于反压状态或其数据缓冲fifo接近写满时,该方案仍可能为该通道分配总线带宽,导致读出数据无处存放或fifo溢出。
6、缺陷三,描述符管理依赖外部ddr访存,效率低。传统dma方案多采用"寄存器逐次配置"或"描述符链驻留ddr"两种模式:前者每次传输都需cpu写寄存器、产生频繁中断,cpu占用率高;后者描述符链存放于ddr,dma需反复读描述符,引入额外访存、链路管理复杂且出错后难恢复。cn113986533b公开了一种数据传输方法,采用读写通道分离的axi总线同时进行数据写入及描述符获取,但其描述符仍驻留于ddr内存,dma需反复通过axi读通道从内存获取描述符,额外占用ddr带宽和axi总线资源。cn121029654b公开了一种基于fpga的多通道dma实现方法,采用门铃寄存器进行描述符链的自动管理,并提出中断聚合与加权公平队列,但其描述符链仍驻留于ddr,依赖门铃机制触发dma从ddr读取描述符链。cn112835829b公开了一种多通道dma传输测控信号的方法,外部设备数据通过pl单元缓存处理后使用axi-bus写入ps外挂ddr,更新pl入队指针并通过中断通知ps单元,该方法仍依赖中断机制进行数据传输完成通知。
7、缺陷四,跨时钟域的数据完整性与传输单元边界难以兼顾。fpga中配置接口时钟、存储总线时钟与各路流式通道时钟往往互不同源、频率各异。现有设计在跨时钟域搬移数据时,常常难以在以突发为单位的高效存储访问与以数据包为单位的流式传输边界(如tlast信号)之间取得平衡,容易出现包边界丢失、长度信息错配等问题。
8、在环形缓冲区管理方面,已公开的中国专利cn112765054a提出了一种基于fpga的高速数据传输采集系统,采用环形缓冲区存储数据,通过读写指针沿环形缓存转动的机制进行数据管理。然而,该方案仍需由软件维护读写指针、由上层应用调用dma驱动进行读取操作,本质上仍属于软件参与的传统环形缓冲管理方式,未解决生产者与消费者之间的无锁协同问题,存在因软件疏忽导致数据覆盖的风险。相比之下,本发明采用硬件置位、软件异或清除的半区完成标志实现无锁生产消费协同,从根本上杜绝了数据覆盖。
9、缺陷五,长包传输需软件拆分。axi协议将单次突发(burst)长度上限限制为256拍(beats),长包传输需软件拆分,效率与实时性受限。
10、此外,在公开学术文献方面,《基于pcie的链式dma控制器设计与实现》(《计算机研究与发展》2024年)针对国产fpga pcie异构加速器场景,提出了独立描述符控制器+共享数据搬移器+链式描述符+tag乱序重组的多通道dma架构,但仍以主机内存中的链式描述符为前提,依赖描述符中断与pcie tag机制,与本发明的端到端流量耦合仲裁、片上描述符fifo、环形乒乓无锁握手等技术路线存在本质差异。商用方案方面,xilinx公司提供的多通道dma(mcdma)ip其多通道支持已被标记为弃用(deprecated),且相关驱动支持有限;cast公司推出的多通道流式dma控制器(mc-sdma)虽支持多路双向通道,但其公开资料未披露流量耦合仲裁、片上描述符fifo、硬件自描述符回写与异或清除握手等机制。
11、综上,现有方案均未同时实现:①单ip多通道双向并发低资源开销;②下行描述符驻留片上fifo免ddr访问;③上行硬件自回写描述符与环形乒乓半区标志无锁低开销握手;④流量控制感知仲裁(即将端到端反压状态耦合进仲裁门控);⑤每通道独立时钟跨域桥接;⑥超长传输自动突发拆分。因此,亟须一种能够将端到端流量控制信息直接耦合进仲裁决策、在保证数据完整性与无覆盖的前提下最大化共享存储总线利用率的多通道dma方法及装置。
12、在学术研究方面,《基于crossbar的多通道dma控制器设计与实现》(《中国集成电路》2013年z1期)提出了一种基于crossbar的多通道dma控制器设计方案,通过交叉开关矩阵实现多通道间的数据路由,但未公开流量控制感知仲裁机制,其仲裁决策仍以通道请求的存在性为依据,未将下游反压或缓冲占用状态纳入门控条件。《一种高速多通道dma控制器设计》(《中国集成电路》2016年06期)介绍了一种基于标准axi接口的多通道dma控制器硬件设计,但未涉及片上描述符缓存或硬件自描述符回写机制。上述学术文献均未公开本发明的完整技术方案。
技术实现思路
1、针对现有技术中仲裁决策与下游接收能力脱节、生产者与消费者缺乏无锁协同、描述符管理依赖ddr访存、跨时钟域包边界难以兼顾、长包传输受限等技术问题,本发明提供了一种流量控制耦合的多通道直接存储器访问(dma)控制器及数据流调度方法。
2、本发明要解决的技术问题包括以下三个层次。
3、第一层,通用dma技术缺陷:(1)多通道实现依赖dma多例化,导致逻辑与互联资源冗余;(2)跨时钟域数据搬移需外挂时钟或位宽转换ip,增加延迟与资源消耗;(3)长包传输需软件拆分axi突发,效率与实时性受限。
4、第二层,多通道流式传输固有缺陷:(4)仲裁决策与下游接收能力脱节,反压通道仍占用总线导致带宽浪费及fifo溢出风险;(5)描述符管理依赖ddr访存,额外占用存储总线带宽且链路管理复杂;(6)跨时钟域条件下存储侧大突发访问与流式侧包边界完整性难以兼顾。
5、第三层,高速连续多通道场景下的综合缺陷:(7)生产者与消费者缺乏无锁协同,高速连续多通道场景下锁开销大、实时性差、易因软件疏忽发生数据覆盖;(8)每完成一次dma传输需cpu中断处理,多通道场景下中断频率高、cpu负载重,影响系统实时性。
6、为实现上述目的,本发明采用如下技术方案。
7、一种流量控制耦合的多通道直接存储器访问装置,包括:配置接口单元、描述符缓冲单元、流量控制感知仲裁单元、共享存储总线访问单元以及多个通道数据缓冲单元。所述配置接口单元通过配置总线(axi4-lite)接收来自处理器针对每一通道下发的传输描述符及通道基地址;所述描述符缓冲单元与每一通道一一对应,跨时钟域缓存传输描述符,并向仲裁单元提供描述符空/非空状态;所述共享存储总线访问单元通过单一存储总线主端口(axi3/axi4 hp)访问外部存储器(ddr),根据被选中通道的描述符执行存储读或存储写操作。
8、所述流量控制感知仲裁单元为本发明的核心,用于在产生每一通道的总线请求时,将该通道的端到端流量控制状态作为请求有效条件之一进行门控,并依据门控后的各通道请求在多个通道间进行仲裁,选中当前能够有效推进且不会造成数据丢失或覆盖的通道占用所述共享存储总线主端口。
9、在下行读出方向上,所述通道数据缓冲单元包括设置于存储总线时钟域与流式通道时钟域之间的异步数据fifo(例如64位宽、1024深度),该fifo提供表征其占用量已达到预设阈值的近满指示信号(本实施例阈值设为512,即约总容量一半)。所述流量控制感知仲裁单元产生下行通道总线请求的门控条件为:该通道描述符缓冲非空,且该通道异步数据fifo未处于近满状态。由此,当某通道下游流式接收端反压、其数据fifo接近写满时,该通道自动退出对共享读端口的竞争,避免读出的数据无处存放。
10、在上行写入方向上,每一通道在外部存储器中分配有一段环形存储区,该环形存储区被划分为至少两个子区(本实施例为前半区和后半区)。所述流量控制感知仲裁单元为每一通道维护一个17位写指针addr_point、一个3位写入轮次计数des_cycle,以及与各子区一一对应的2位数据就绪标志up_flow_updata。所述数据就绪标志由硬件(dma写引擎)在写满对应子区时置位,由软件(处理器)在消费完对应子区数据后清除。上行通道总线请求的门控条件为:该通道有待处理数据包(长度fifo非空),且写指针当前所指向子区的数据就绪标志处于未置位状态。由此构成硬件置位、软件清除的无锁生产与消费协同,dma引擎绝不会向尚未被消费的子区写入数据,从根本上杜绝数据覆盖。
11、所述数据就绪标志的清除采用异或清除握手:标志的更新按(置位值异或清除值)与置位值的逻辑进行,使得软件可通过写入与当前置位相对应的清除位来精确清除已消费的子区标志,而不会误清其他子区或其他通道的标志。所述共享存储总线访问单元在上行写入方向将每一数据包及其自描述信息一并写入所述环形存储区。所述自描述信息至少包括表征该数据包所属写入轮次的轮次字段des_cycle以及表征该数据包长度的长度字段des_len。
12、具体地,所述axi写ddr引擎采用8状态有限状态机,包括axi_widle(空闲)、axi_winfor(读取长度信息)、axi_wraddr(发送写地址)、axi_wdat(发送写数据)、axi_wresp(接收写响应)、axi_des_wraddr(描述符回写-发送写地址)、axi_des_wdat(描述符回写-发送写数据)和axi_des_wresp(描述符回写-接收写响应)状态。数据传输完成后自动进入后三个描述符回写状态,将包含轮次和长度的64位自描述字回写到ddr中对应数据块起始位置,无需cpu干预即可形成完整的自描述信息链。在默认64位数据位宽实施例中,自描述字bit[63:61]为des_cycle,bit[44:32]为des_len。
13、所述传输描述符为32位定长字,其字段包括:低16位[15:0]为偏移字段(表示数据包相对通道基地址的偏移,以4kb为粒度,硬件将其左移12位参与地址运算);位[28:19]为10位长度主计数(以8字节为单位);位[18:16]为余量标志(非0时总长度计数值加1)。所述共享存储总线访问单元将基地址与偏移字段按存储区粒度左移预定位数后拼接得到目标物理地址。
14、所述共享存储总线访问单元在单次描述符对应的数据量超过存储总线协议规定的单次突发最大拍数(axi协议incr突发最大256拍)时,将该次传输自动分段为多次突发。每次突发之间使目标地址按单次突发最大拍数乘以数据位宽对应字节数自增(在64位位宽下为0x800=2048字节),并在全部突发完成后产生操作完成标志。
15、所述共享存储总线访问单元在存储总线数据与通道数据之间进行字节序重排,将存储总线宽字的各字节按相反次序重排后写入或读出通道数据缓冲,以适配流式通道的字节序约定。上行写入ddr前进行64位小端到大端的字节序翻转,下行从ddr读出后进行大端到小端的翻转。
16、所述下行读出方向的通道数据缓冲单元包括相互独立的数据fifo(64位宽,1024深度)与长度fifo(13位宽,256深度):数据fifo缓存数据拍,长度fifo缓存对应数据包的长度。流式通道发送控制器先自长度fifo取得数据包长度,再自数据fifo逐拍读出数据,并依据所述长度在正确的数据拍上产生流式传输包尾(tlast)指示,同时将该长度携带于流式用户自定义字段(tuser)中。当下游反压时,发送控制器停止从数据fifo读取数据并保持当前输出不变,待就绪后继续发送,避免数据丢失。
17、所述流量控制感知仲裁单元在下行方向采用旋转优先级公平仲裁器,采用两阶段优先级编码策略:第一阶段将输入请求与轮转屏蔽指针进行按位与运算,在屏蔽范围内进行优先级编码;第二阶段在全部请求范围内进行优先级编码作为后备。每次授权后更新旋转指针,使被授权通道在下一轮被屏蔽,从而实现多通道的公平轮转调度。所述仲裁单元在检测到有通道被选中时进入操作进行状态,并在收到操作完成标志后释放总线、返回仲裁空闲状态。
18、所述dma控制器采用跨时钟域三级异步fifo架构:配置接口时钟域(axi_slite_clk)、存储总线时钟域(axi_clk)和每通道独立的流式通道时钟域(axis_up_clk/axis_dn_clk)。所有通道的数据fifo、长度fifo和描述符fifo均为异步fifo,支持独立的读写时钟,实现三个时钟域之间的安全数据传输,无亚稳态风险。
19、所述上行通道支持软件复位自动清除机制:当软件写入复位寄存器后,首先清除通道使能标志停止dma操作;当检测到该通道处于空闲状态(fifo为空且无进行中的操作)时,自动清除复位标志和使能标志,并触发统计计数器清零,无需软件二次写入清除复位标志。
20、所述装置还包括系统寄存器单元,所述系统寄存器单元汇总全部上行通道的半区完成标志并将其映射为只读寄存器,处理器通过单次寄存器读取操作即可获取全部通道的半区数据消费状态,减少了寄存器访问次数并降低了软件轮询开销。
21、本发明还提供一种流量控制耦合的多通道直接存储器访问方法,包括:接收并跨时钟域缓存每一通道的传输描述符;在每一仲裁周期,依据各通道的端到端流量控制状态对总线请求进行门控——其中下行读出方向将通道数据缓冲近满作为抑制请求的条件,上行写入方向将写指针所指子区的数据就绪标志已置位作为抑制请求的条件;对门控后的各通道请求进行仲裁,选中能够当前有效推进的通道;由被选中通道占用共享存储总线主端口,依据其描述符执行存储读或存储写操作;在操作完成后释放总线并返回仲裁。
22、本发明还提供一种片上系统,包括处理器、存储器和可编程逻辑,所述可编程逻辑中实现有上述装置,所述处理器通过所述配置接口单元下发描述符并通过清除所述数据就绪标志消费数据。
23、有益效果
24、第一,基于流量控制感知仲裁,共享总线带宽利用率显著提升。通过将通道数据缓冲近满及环形半区占用状态耦合进仲裁请求门控,仲裁器仅放行可无丢失推进的通道,使共享存储总线带宽始终服务于能够真正推进的传输,避免反压通道空占总线带宽。
25、第二,基于片上异步描述符fifo,描述符获取不占用存储总线带宽。下行传输描述符由处理器经配置总线一次性下发至片上异步fifo,dma引擎从片上读取,消除描述符访存与数据访存之间的竞争,多路数据并行采集不抢占存储资源。
26、第三,基于上行乒乓半区硬件置位与异或清除握手,实现无锁协同且杜绝数据覆盖。上行方向由硬件在写满子区时自动置位标志,软件消费后以异或方式清除,无需互斥锁或内存屏障;dma绝不向未消费子区写入数据,从根本上杜绝数据覆盖,同时大幅降低cpu中断与轮询频次。
27、第四,基于硬件自描述符回写,降低软件负担。硬件在写入数据包的同时回写包含写入轮次与长度的自描述信息,软件无需与硬件实时交换读写指针即可正确解析数据包边界与顺序,简化驱动与固件设计。
28、第五,基于单ip双向多通道架构与三级异步fifo跨时钟域桥接,降低硬件资源开销并简化系统设计。单一ip核内置独立的下行簇与上行簇,无需多例化dma即可实现多通道双向并发;每通道独立时钟经异步fifo原生桥接,无需外挂时钟或位宽转换ip。
29、第六,基于硬件axi突发自动拆分与字节序适配,降低软件开发难度。单次传输超过axi协议突发上限时由硬件自动分段,软件无需处理协议分片;存储总线与流式通道之间的字节序由硬件重排,适配存储器小端格式与流式通道数据格式。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com