
一种大模型长文本算力优化与幻觉抑制分层调度方法与流程
本发明涉及深度神经网络、算力自适应调度、长文本自然语言处理,具体为一种长文本推理与离线预训练通用分层调度方法,可适配稠密、moe、mamba、多模态大模型的离线预训练、在线推理全流程优化。
背景技术:
1、当前稠密transformer、moe、mamba各类主流大模型,无论离线预训练还是在线长文本推理场景,处理百万字长文档、海量训练语料时均存在三类同源底层核心短板,也是训练算力昂贵、推理频发逻辑幻觉的根本原因:
2、第一,无前置全局判别调度单元,算力分配固定一刀切。所有长短训练语料、长短输入文本统一执行全量token两两交互运算,计算量随文本长度呈平方级暴涨;常规moe专家路由固定,无法根据文本体量、语义关联度、预估任务难度动态调整计算规模。简单单句推理、小规模训练集也会空载消耗显存与电力,超长文本极易出现显存溢出;同时全局、局部数据流共用缓存算力,高并发推理、批量训练场景下资源抢占严重,运算波动剧烈。
3、第二,仅单层粗粒度文本过滤,缺少分层轻重记忆与分层计算机制。现有轻量化优化仅能成片合并文本,无法区分核心关键信息、时序关联内容、无价值冗余铺垫;训练语料、推理上下文全部特征混杂存储,每次运算都需要完整重算全部文本,无法提炼轻量化摘要单独留存,既无法分领域并行推理,也不能分批次分层训练,持续产生大量无效算力开销。
4、第三,单向线性运算,缺少分段校验、样本自主迭代闭环。在线推理过程中出现数值、条款矛盾无法实时拦截;离线预训练中混杂冲突事实的样本会直接参与梯度计算,造成模型拟合偏差。无论训练还是推理,出现逻辑错误后都需要完整重跑整条链路,幻觉、拟合偏差只能人工修正;优质、异常样本无法自动回流微调调度规则,模型迭代成本高。
5、以上三类缺陷在训练、推理场景同时存在,现有优化方案大多只能单独适配推理或单独适配训练,缺少一套架构通用的分层调度体系。人脑在信息处理中天然具备任务预判、分层筛选、分区并行与结果复盘的分层逻辑,本发明借鉴该分层逻辑作为设计灵感,提出标准化三层调度体系,使训练与推理复用同一套分层过滤与算力调度逻辑,同步解决长文本场景下训练与推理两阶段的算力开销过高,以及预训练拟合偏差与推理逻辑幻觉两类同源可靠性问题。
技术实现思路
1、针对现有单层transformer、moe、mamba仅做单点轻量化优化,缺少训推通用分层调度体系、长文本训练算力开销高、长文本推理易产生逻辑幻觉、训推两套逻辑割裂的技术缺陷,本发明提供一种大模型长文本算力优化与幻觉抑制分层调度方法。
2、本发明所称“分层调度”借鉴人脑信息处理的分层逻辑作为设计灵感——人脑生理结构不属于实现本发明的必要技术特征,实施本方案无需对大模型基座开展任何仿生底层改造。
3、各模块与人脑认知单元功能对应对照表
4、
顶层全局调度模块
背外侧前额叶
统筹全部推理任务,量化文本复杂度、下发全局算力调度指令
分层筛选调度模块
丘脑
过滤冗余、低关联语义表征模块
局部子网运算模块集群
海马 / 视觉 / 语言皮层等
分领域、分功能并行处理细分推理任务,原始表征本地留存,仅汇总精简摘要向上传递
逻辑异常回流校验流程
人脑复盘反思机制
识别逻辑、数值矛盾,回溯重推导
5、稠密、moe、多模态通用大模型均可叠加本套分层调度架构;依托分层过滤、子网并行、异常回流、lora轻量化迭代机制,同时降低离线预训练、在线推理两类场景的算力消耗,减少逻辑冲突,适配法律、金融、代码、医疗等多行业长文本业务。
6、本方案所述顶层全局调度模块、分层筛选调度模块、局部子网运算模块为适配大模型预训练、在线推理双场景的通用软件功能模块,可单独用于离线预训练流程,也可单独用于线上推理流程,还可支持训推同步联动运行,训练、推理阶段复用同一套分层过滤调度逻辑。
7、本发明包含一套基础分层算力调度流程及在此基础上增加的逻辑异常回流校验闭环流程。
8、基础分层算力调度流程包含标准化三层分层调度结构与双隔离传输机制:
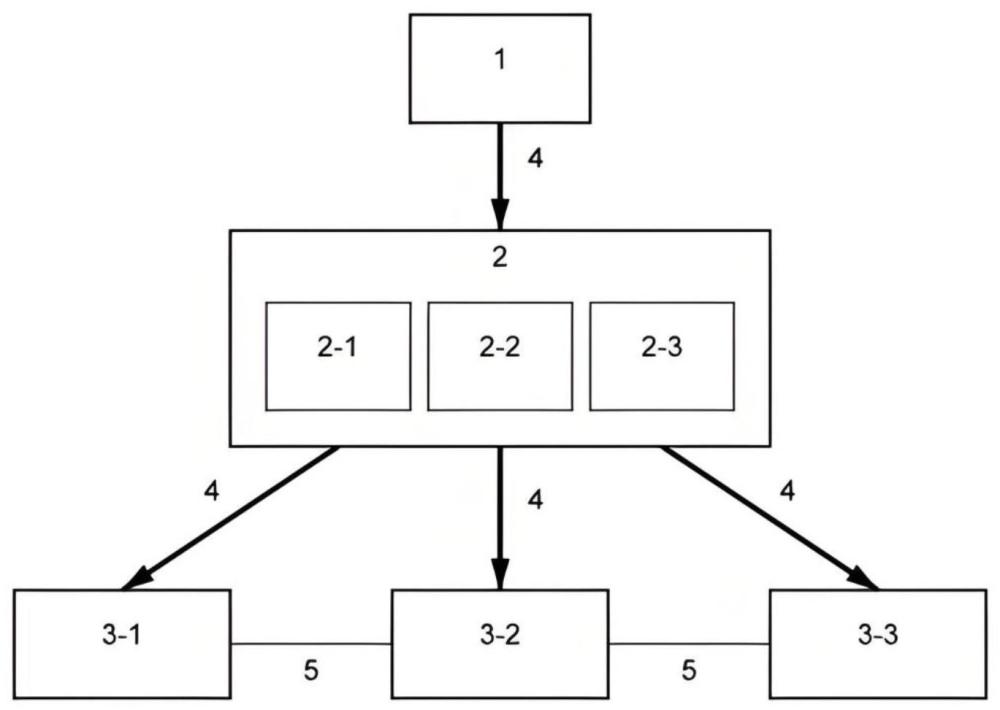
9、1.三层分层调度模块层级划分(1)顶层全局调度模块(1):内置三层任务打分模块,统计文本长度、向量关联度、预估推理/训练步数,输出差异化算力调度权重;(2)分层筛选调度模块(2):并行设置全局块压缩分支(2-1)、细粒度token精选分支(2-2)、短时滑动窗口分支(2-3),预训练、推理阶段均可同步启用,过滤无价值冗余表征;(3)局部子网运算模块集群(3):拆分为领域子网(3-1)、逻辑验算子网(3-2)、通用归纳子网(3-3),支持多组子网并行开展训练、推理运算。
10、2.全局-局部双隔离传输链路全局管控链路(4)配置独立运算与缓存资源,单向传输顶层调度指令、各子网精简摘要;局部自主链路(5)配置子网私有轻量化缓存,仅用于单子网内部原始特征交互,两类链路算力、缓存资源相互隔离,不存在资源抢占冲突。
11、3.算力优化运行逻辑顶层全局调度模块(1)下发调度指令→分层筛选调度模块(2)过滤冗余表征→局部子网运算模块集群(3)分层并行运算,仅精简摘要向上汇总至顶层,全程规避全局全量token两两交互。在典型部署工况下,全局交互计算规模由传统o(n²)收敛至o(kn),k为筛选后有效表征数量,通常为原始文本5%-15%。
12、在基础分层调度流程之上增设逻辑异常回流通道(6),即可形成带校验闭环的拓展调度方案,完整执行流程如下:
13、s1 标准化三层分层调度模块层级划分,统一各模块功能边界;
14、s101 配置顶层全局调度模块(1),内置三层任务打分模块,依据预设的文本长度阈值、向量相似度阈值及预估处理步数阈值输出文本体量、语义关联度、预估处理步数三类打分指标,生成全局调度指令;
15、s102 配置分层筛选调度模块(2),设置全局块压缩分支(2-1)、细粒度token精选分支(2-2)、短时滑动窗口分支(2-3)三条并行筛选分支,过滤冗余、低关联语义表征模块;
16、s103 搭建局部子网运算模块集群(3),按领域、处理功能拆分为领域子网(3-1)、逻辑验算子网(3-2)、通用归纳子网(3-3)多组并行运算子网;
17、s2 自上而下分层调度:顶层全局调度模块(1)依据复杂度打分控制各筛选分支启用强度、子网激活数量,简单任务启用少量运算子网,长文本完整启用全部筛选分支与运算子网;
18、s3 各子网分层并行处理并汇总局部摘要至顶层全局调度模块(1),整合生成全局处理输出;
19、s4 划分两套资源隔离的传输链路:全局管控链路(4)配置独立运算与缓存资源,单向传输顶层调度指令、子网精简摘要;局部自主链路(5)配置本地缓存,仅用于单子网内部语义交互,完整语义表征仅在局部自主链路(5)内部交互,两类链路缓存、计算资源相互隔离,互不抢占;
20、s5 执行逻辑异常回流通道(6)闭环流程:局部子网、分层筛选分支检测数值、信息、逻辑冲突时,生成异常标识沿全局管控链路(4)回流至顶层全局调度模块(1);顶层调整筛选规则、子网激活策略,重新分发表征二次推导,直至无冲突后汇总全局结论。
21、回流标准化细化流程:子网识别数值、文本逻辑冲突后生成异常标识,沿全局管控链路(4)回传顶层全局调度模块(1);顶层下调冲突文本关联权重,控制分层筛选调度模块(2)补充关联上下文、剔除矛盾表征,重新下发至子网完成二次运算,无冲突后输出最终结果。
22、本方案配套两类辅助标准化流程:
23、第一,外部工具联动流程:顶层全局调度模块(1)判断当前文本信息不足时,沿全局管控链路(4)下发调用指令,启动检索、数值计算外部工具,工具输出表征送入分层筛选调度模块参与分层运算;
24、第二,轻量化迭代流程:单次推理、单批次训练完成后,顶层全局调度模块(1)划分优质样本、异常冲突样本,通过lora轻量化迭代模块(7)微调各分层调度模块,无需完整基座重训即可更新分层筛选、算力调度规则。
25、相较于现有技术,本发明具备多项技术优势:
26、第一,训推通用算力优化。分层筛选机制提前剔除冗余文本,脱离传统o(n²)全量交互模式,硬件双隔离链路消除算力抢占损耗,离线预训练、在线推理场景均可大幅削减无效运算量。
27、第二,内置逻辑冲突自检闭环,同步解决训练拟合偏差、推理幻觉问题,降低人工复核修正成本。
28、第三,算力按需自适应调配。顶层打分模块区分任务轻重,轻量化任务闲置冗余子网,减少空载硬件功耗。
29、第四,训推逻辑一体化。分层筛选调度模块训练、推理复用同一套运算逻辑,无需分别搭建两套处理管线,降低二次开发成本。
30、第五,低成本轻量化迭代。仅通过lora微调分层调度单元,无需重训完整大基座,样本迭代算力消耗更低。
31、第六,多行业、多模态兼容,新增专属领域子网即可适配法律、金融、医疗、代码等垂直长文本业务。
32、本领域技术人员应当理解,本发明所述顶层全局调度模块(1)的复杂度打分方式、分层筛选调度模块(2)的筛选分支类型及数量、局部子网运算模块集群(3)的子网划分方式均为示例性说明。采用其他能够实现基本相同功能、达到基本相同效果的替代手段(包括但不限于不同的打分算法、不同的筛选分支组合、不同的子网划分方式),且无需创造性劳动即可想到的,均属于本发明的等同技术方案。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com