
基于增强型脉冲Transformer的口腔图像分类方法
本技术属于口腔图像分类,具体涉及一种基于增强型脉冲transformer的口腔图像分类方法。
背景技术:
1、随着边缘智能设备、dvs(dynamic vision sensor,动态视觉传感器)及微型嵌入式视觉终端的大规模普及,低功耗、低延迟、轻量化的图像分类算法成为行业刚需。传统图像分类方法主要依赖ann(artificial neural network,人工神经网络)、cnn(convolutional neural network,卷积神经网络)及标准transformer(变换器)模型,这些方法依靠密集的浮点矩阵乘加运算进行特征提取与推理,计算量大、功耗高,在电池供电、算力受限的小型终端设备上落地困难。与此同时,神经形态视觉传感器(如动态视觉传感器)产生的稀疏事件流数据,传统视觉分类模型难以高效处理,亟需一种兼具低功耗特性和强时空特征表达能力的轻量化图像分类解决方案。
2、在现有图像分类技术中,snn(spiking neural network,脉冲神经网络)模拟生物神经元脉冲放电机制,采用事件驱动稀疏计算,仅当输入膜电位超过阈值时才产生脉冲输出,天然具备低功耗、适配神经形态硬件、擅长处理时序事件信号的优势,已成为边缘视觉分类任务的主流研究方向。spikformer(zhou z, zhu y, he c, et al. spikformer:when spiking neural network meets transformer[j]. arxiv preprint arxiv:2209.15425, 2022.)是首个将脉冲神经元与transformer自注意力机制结合的脉冲视觉分类模型,使用lif(leaky integrate-and-fire,泄漏积分发放神经元模型)的脉冲神经元替换标准transformer的激活函数,通过ssa(spiking multi-head self-attention,脉冲自注意力)将查询、键、值矩阵转化为0/1二进制脉冲序列,取消softmax浮点运算,依靠脉冲稀疏性降低计算能耗;采用sps(spiking patch splitting,脉冲图像块分割)模块完成图像分块、卷积下采样与脉冲位置嵌入,搭建多层脉冲自注意力编码器实现图像分类,适用于静态图像与dvs神经形态数据集。此外,se-resnet(hu j, shen l, sun g. squeeze-and-excitation networks[c]//proceedings of the ieee conference on computer visionand pattern recognition. 2018: 7132-7141.)通道注意力网络通过全局平均池化挤压全局通道特征,利用双全连接层建模通道间依赖关系,输出权重校准特征图,并搭配残差连接缓解深度网络梯度消失问题,已广泛应用于提升各类图像分类网络的通道特征表达能力。循环矩阵轻量化线性层circulant_linear(tang y, han k, xu c, et al. augmentedshortcuts for vision transformers[j]. advances in neural informationprocessing systems, 2021, 34: 15316-15327.)则利用循环矩阵的周期性与对称性拆分全连接权重矩阵,以一维参数向量循环生成权重矩阵,可大幅削减全连接层参数量,为图像分类模型的轻量化部署提供了有效技术路径。
3、然而,上述现有图像分类方法仍存在以下缺陷。第一,spikformer的sps特征嵌入模块采用全局最大池化进行下采样,仅保留局部最强响应特征,丢失了全局平均统计信息,导致微弱判别特征被过滤,对于低对比度、低照度或目标细粒度差异小的图像分类任务,识别精度严重受限;同时,传统se模块仅采用单一平均池化,仅捕获全局统计特征而忽略局部峰值判别特征,应用于脉冲图像分类网络时无法适配脉冲阈值带来的特征衰减问题,通道特征校准能力不足。第二,现有脉冲transformer图像分类模型需要较长的时间步(通常t≥4)才能完成时序信息编码,模型参数量冗余,部署至边缘设备难度增大,占用较多内存资源,而缩短时间步后模型时序特征提取不充分,分类准确率断崖式下跌,难以满足准确性要求严苛的边缘视觉分类场景。第三,常规图像分类模型的轻量化手段(如削减网络层数、压缩通道数)会大幅降低分类准确率,轻量化与识别性能难以兼顾;且现有脉冲transformer图像分类模型仅依靠单一流脉冲自注意力提取特征,特征表达维度单一,参数量冗余,必须依赖深层网络结构及长时序步长才能保证分类精度,限制了其在资源受限终端上的部署。第四,现有spikformer模型在特征嵌入、编码器及mlp(multilayer perceptron,多层感知机)阶段均未引入通道注意力机制,统一lif脉冲阈值对所有特征通道采用相同的发放标准,无法区分关键特征通道与噪声通道,面对包含复杂背景、噪声干扰或光照变化的图像输入时,模型难以自适应地增强有效特征并抑制无关信息,分类鲁棒性差,泛化能力不足。
技术实现思路
1、为了解决现有技术中存在的上述问题,本技术提供了一种基于增强型脉冲transformer的口腔图像分类方法。本技术要解决的技术问题通过以下技术方案实现:
2、一种基于增强型脉冲transformer的口腔图像分类方法包括:
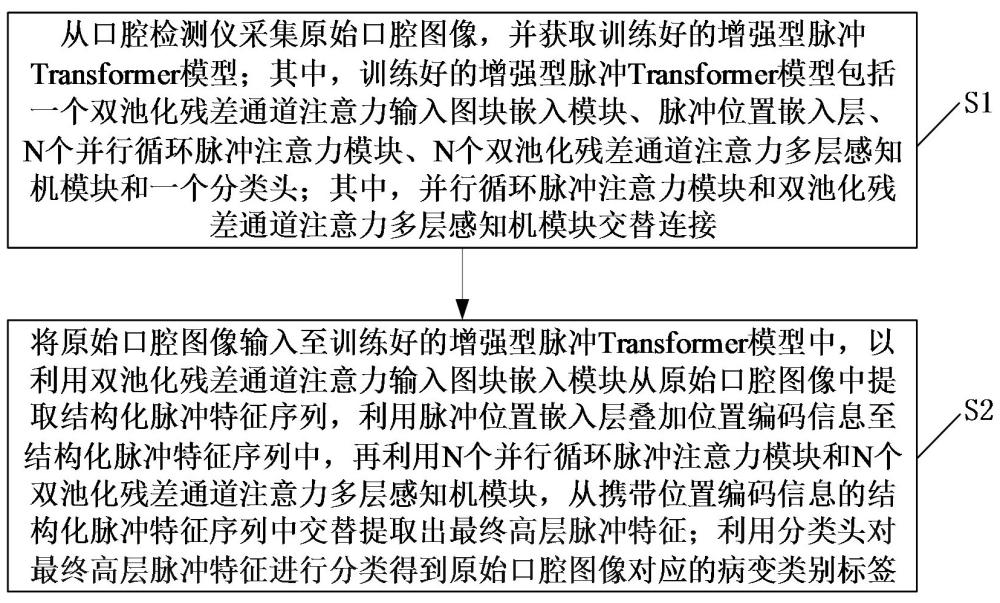
3、s1,从口腔检测仪采集原始口腔图像,并获取训练好的增强型脉冲transformer模型;其中,所述训练好的增强型脉冲transformer模型包括一个双池化残差通道注意力输入图块嵌入模块、脉冲位置嵌入层、n个并行循环脉冲注意力模块、n个双池化残差通道注意力多层感知机模块和一个分类头;其中,所述并行循环脉冲注意力模块和双池化残差通道注意力多层感知机模块交替连接;
4、s2,将所述原始口腔图像输入至训练好的增强型脉冲transformer模型中,以利用所述双池化残差通道注意力输入图块嵌入模块从所述原始口腔图像中提取结构化脉冲特征序列,利用所述脉冲位置嵌入层叠加位置编码信息至所述结构化脉冲特征序列中,再利用所述n个并行循环脉冲注意力模块和所述n个双池化残差通道注意力多层感知机模块,从携带位置编码信息的结构化脉冲特征序列中交替提取出最终高层脉冲特征;利用所述分类头对所述最终高层脉冲特征进行分类得到所述原始口腔图像对应的病变类别标签。
5、本技术与现有技术相比,具有以下有益效果:
6、(1)本技术设计双池化残差通道注意力模块,并行融合全局平均池化与全局最大池化两种池化策略,使网络对特征的感知从单一的全局平均响应扩展至全局-局部特征的多层次表达,克服了单一池化方式造成的特征丢失问题,生成更具区分度的通道权重,显著增强了对复杂特征的自适应校准能力。同时,本技术在特征嵌入、特征变换等全链路中嵌入该模块,通过通道权重向量对各通道进行逐通道重标定,强调关键特征通道、抑制噪声通道,有效改善了现有脉冲transformer因统一脉冲阈值无法区分关键特征与噪声的缺陷,增强了模型对低对比度、复杂背景及噪声干扰场景下的分类鲁棒性。
7、(2)本技术设计并行循环脉冲注意力模块,采用恒等映射、脉冲自注意力和循环线性变换三条支路并行提取特征并逐元素相加融合。循环线性变换支路依托循环矩阵的权重共享机制,以一维参数向量为循环基底生成权重矩阵,大幅缩减全连接层参数量,以极低参数量提供额外的特征表达维度;配合恒等映射支路保留原始信息,弥补了短时序步长下脉冲信息不足的问题,使模型在不依赖长时序迭代的条件下即可充分提取判别特征,大幅降低了模型所需的时序步长与推理延迟,实现了参数量与精度的协调可控。
8、(3)本技术采用n个并行循环脉冲注意力模块与n个双池化残差通道注意力多层感知机模块交替连接的结构,使网络能够在不同层级反复进行特征交互与非线性变换,逐级深化特征表达,充分挖掘图像的空间与时序信息,最终提取出更具判别力的高层脉冲特征,为资源受限的部署场景提供了灵活的轻量化调控方案。
9、(4)本技术依托lif泄漏积分发放脉冲神经元实现事件驱动稀疏计算,增强型脉冲transformer模型中的各模块均以二进制的脉冲序列为处理对象,无需依赖浮点矩阵乘加运算,天然具备低功耗、适配神经形态硬件的优势;所设计的脉冲自注意力支路利用脉冲序列非负特性直接进行特征相似度度量,省略softmax浮点运算,在此运算过程中进一步降低了计算开销。本技术通过各模块紧密衔接,从特征提取、特征交互到特征变换、分类决策形成完整的技术闭环,各创新模块协同优化,在有效控制参数量的前提下显著提升口腔图像病变分类的准确率,为口腔图像辅助诊断及更广泛的视觉分类任务提供了一套完整、高效、可部署的技术方案。
10、以下将结合附图及实施例对本技术做进一步详细说明。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com