
一种算力芯片缓存调度方法及硬件架构与流程
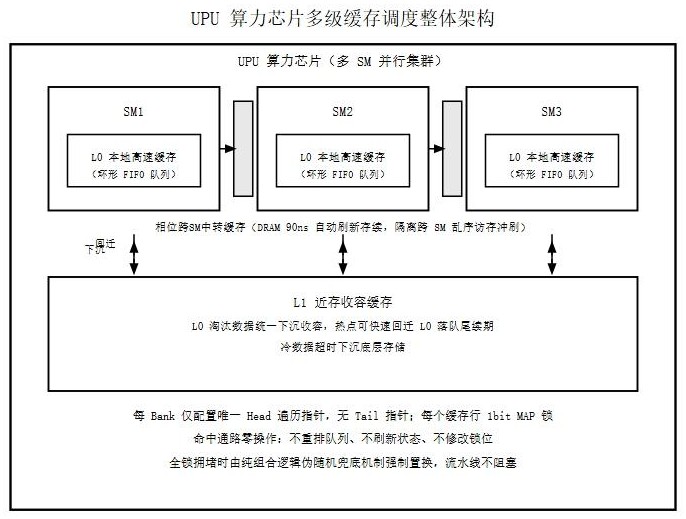
本发明涉及人工智能算力芯片、高速缓存存储架构及缓存替换调度,具体涉及一种面向多sm并行算力架构的极简硬件开销、零命中开销、软件可控热点常驻的l0缓存调度方案。术语定义(本发明统一法定释义,适配全文及审查规范)1、upu算力芯片:特指面向ai推理、ai算力迭代运算的专用串并行统一处理器芯片,内部集成多组独立sm算力单元、多级分层缓存架构,采用规整化数据流调度,区别于通用cpu、gpu架构。2、map锁(软件map锁):为本发明独创的1bit行级软件可控锁标记机制,每一条l0缓存行独立配置1bit锁位,由上层软件主动配置读写,用于精准标记核心热点缓存行、硬件配合实现常驻保护,是软硬件协同的热点映射锁定机制,简称map锁。3、相位ttl中转缓存:部署于多sm算力单元之间、用于跨单元数据隔离转发的dram介质中转缓存;本发明中ttl并非软件计数生存期,而是依托dram硬件固有物理特性形成的90ns超短自动刷新存续窗口。该缓存无需配置、无需软件维护超时计数,硬件每90ns周期自动完成整行电荷刷新与数据重写,维持跨sm转发数据短时有效;超过90ns未被读取转发的滞留数据,判定为无效滞留数据,硬件自动冲刷下沉至l1近存缓存,同时缓存溢出数据同步下沉l1。用于天然隔离跨单元乱序访存、屏蔽外部数据流对l0高速缓存的队列冲刷干扰,实现无开销、纯硬件自适应的跨层流量规整。4、状态清零(关键歧义定义):本发明中所有缓存行「状态清零」操作,仅清零缓存行的临时时序状态、有效标记、脏状态等辅助状态位,不修改、不触碰map锁lock锁定位;锁定行的lock位永久保留软件配置状态,彻底规避热点数据误解锁、误淘汰矛盾。
背景技术:
1、现有高端算力芯片、cpu、gpu的高速缓存普遍采用lru、plru或clock时钟类近似lru替换算法。这类算法能够依靠硬件时序统计实现冷热数据区分,具备较好的命中率表现,但存在无法规避的硬件缺陷:
2、1、lru/plru需要大量状态寄存器、时序矩阵、优先级编码逻辑,硬件面积、功耗、布线开销大,不利于超大容量l0缓存与多sm集群规模化部署;
3、2、所有lru类算法均需要在缓存命中时刷新时序状态,产生高频动态功耗与关键路径延迟,无法满足l0极致低时延的设计诉求;
4、3、传统fifo架构硬件极简,但存在热点误驱逐、队列颠簸、belady异常等缺陷,无法用于高端算力l0高速缓存;
5、4、现有缓存架构无法支持软件精细化热点管控,硬件盲判冷热、任务适配性差,针对规整ai算力场景资源浪费严重;
6、5、当软件对大量核心数据上锁常驻时,现有架构缺乏全锁拥堵兜底机制,极易出现缓存队列卡死、流水线阻塞的稳定性问题。
7、综上,现有技术无法同时满足「极低硬件开销、零命中延迟、软件可控热点、高稳定性、量产友好」的算力芯片l0缓存需求。
技术实现思路
1、本发明目的在于克服现有lru、近似lru、传统fifo的各类缺陷,提供一种单head唯一指针、无tail指针、零命中开销、软件锁可控、遍历续期、全锁容错、l1层级兜底的极简l0缓存调度架构,在硬件开销远低于传统算法的前提下,实现接近lru的热点命中率,同时具备更强的工程量产性与任务适配性。
2、本发明核心创新技术方案
3、本发明公开一种基于单指针遍历的零开销l0缓存调度方法,应用于多sm隔离的upu算力芯片,芯片包含多级缓存:l0本地高速缓存、相位跨sm中转缓存、l1近存收容缓存;每个sm包含若干独立bank,bank内部采用环形fifo队列结构,仅配置唯一head遍历指针,取消全部tail指针,整体包含如下核心机制:
4、1、单指针统一遍历队列重整机制
5、本发明全局仅保留唯一head指针作为遍历与淘汰基准,无tail指针。缓存满需要置换时,从head指针开始环形向后逐行扫描,所有被扫描到的缓存行统一执行状态清零、变队尾、head指针自增下移,仅通过lock标记位区分是否淘汰数据,队列逻辑高度统一、硬件分支极少。
6、2、1bit软件map锁冷热区分与被动续期机制
7、每个缓存行配置1bit软件可控lock标记:lock=1为软件锁定热点行,lock=0为普通可淘汰行。
8、当head扫描命中lock=1锁定行:不淘汰数据,仅清零临时辅助状态位(lock=0)、head指针自增下移自动变队尾,实现热点数据被动续期延后淘汰,无需命中移位、无需命中状态刷新,访问命中全程只读、零功耗、零延迟开销。
9、当head扫描命中lock=0普通行:将该行数据下沉搬运至l1近存缓存,清空该行并写入新数据,新数据默认lock=0并head指针自增下移当前位置自动变队尾,完成置换。
10、3、全锁拥堵极简硬件兜底容错机制
11、若单次完整环形遍历后所有缓存行均为lock=1锁定状态,无可用淘汰行,判定为队列拥堵卡死。硬件启用纯组合逻辑伪随机淘汰机制:通过head指针与当前访存地址低位异或运算生成随机下标,强制随机选中一条锁定行,清零lock状态、下沉数据至l1、写入新数据,保证流水线不因全锁拥堵而阻塞。随机生成逻辑无新增寄存器、单周期完成、无时序负担。
12、4、三级缓存协同容错架构
13、跨sm数据交互统一经过相位ttl中转缓存,该缓存为dram介质架构,依托硬件固有90ns自动刷新存续机制管控跨单元数据流:90ns刷新周期内未完成转发的滞留数据自动失效并下沉l1近存缓存,溢出数据同步下沉,有效隔离外部乱序访存对l0队列的冲刷干扰;l0所有淘汰数据统一进入l1近存收容缓存,不直接落盘,热点数据可快速回迁l0并自动落队尾续期,彻底抹平极简fifo架构的微小误淘汰缺陷。
14、5、前置防拥堵软件硬件联动保护
15、硬件设置单bank上锁容量阈值,上限默认80%总容量,预留永久可淘汰空间;上锁占用达到75%时主动上报告警,软件提前解锁闲置热点,从源头规避全锁拥堵极端场景。
16、本发明有益效果
17、1、硬件开销极致降低:取消tail指针、取消lru时序矩阵、取消命中状态刷新逻辑,仅保留单指针+1bit锁位,面积、功耗、时序开销显著低于传统lru、plru算法;
18、2、命中零开销:所有读写命中均为纯只读操作,无任何寄存器改写、无关键路径延迟增加,适配l0纳秒级超低延迟定位;
19、3、热点保护效果对标lru:通过软件精准上锁+遍历自动续期,核心热点长期驻留队尾,普通热点误淘汰可l1回迁续期,整体命中率接近lru;
20、4、稳定性极强:独创全锁随机兜底机制,有效解决软件全量上锁导致的缓存卡死、流水线阻塞问题;
21、5、量产适配性强:模块极简标准化,适配多sm超大l0集群横向扩展,
22、6、软硬件协同高度可控:软件可根据ai任务动态定义冷热热点,比硬件盲判冷热更精准、更贴合算力业务特征。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com