
一种面向合规审查的多知识库构建与自动推理方法及系统
本发明涉及合规审查,尤其是一种面向合规审查的多知识库构建与自动推理方法及系统。
背景技术:
1、现有合规审查工作(如建筑防火审查、消防设施查验、工程质量验收等)通常需要依据法律法规、行业标准、审查细则及历史经验,对海量的设计文件、查验报告等进行逐项核对。随着工程复杂度的提升,传统依赖人工翻阅标准或简单关键词检索的审查方式已无法满足海量数据的实时核查需求。
2、实际业务中,法规文本采用高度抽象的约束表达(如:“当建筑高度大于50m时,应采用防烟楼梯间”);而审查报告偏向于具象的事实记录(如:“1#楼地上高度55米,设置了封闭楼梯间”)。这种文本结构和维度的不对等,导致法规与审查材料之间存在巨大的“语义鸿沟”。
3、现有的单一向量检索方案在合规审查场景下面临严重挑战:一是含有特定数值或反向违规状态的业务事实,在向量空间中极易与真实的合规基准产生特征排斥,偏离正确法规;二是审查文本中充斥着诸如“符合规范要求”、“运行正常”、“完备”等评价性废话,这些高频的干扰词会极大地破坏特征提取器对核心实体向量的表征分布,导致检索依据的准确率断崖式下降。
4、此外,现有方法缺乏对多参数联合约束及复杂条件逻辑的建模能力,实际合规判定通常涉及建筑高度、建筑面积、使用性质、防火等级、消防设施配置等多个参数的联合约束,并包含“当满足条件 a 且条件 b 时,应执行 c;当满足条件 a 但不满足条件 b 时,应执行 d”等条件逻辑。现有基于单一文本相似度的向量检索方法仅能完成浅层语义匹配,无法对多源合规数据之间的拓扑关系进行有效建模,也难以支撑上述复杂条件逻辑下的自动化联合判定。
技术实现思路
1、为了解决上述问题,本发明提供一种面向合规审查的多知识库构建与自动推理方法及系统,能够缩短法规抽象表达与审查具象记录之间的语义距离,实现复杂条件逻辑下的联合约束判定,解决了复杂工程约束下大模型容易产生幻觉、推理能力不足的问题。
2、为了实现上述目的,本发明采用的技术方案为:
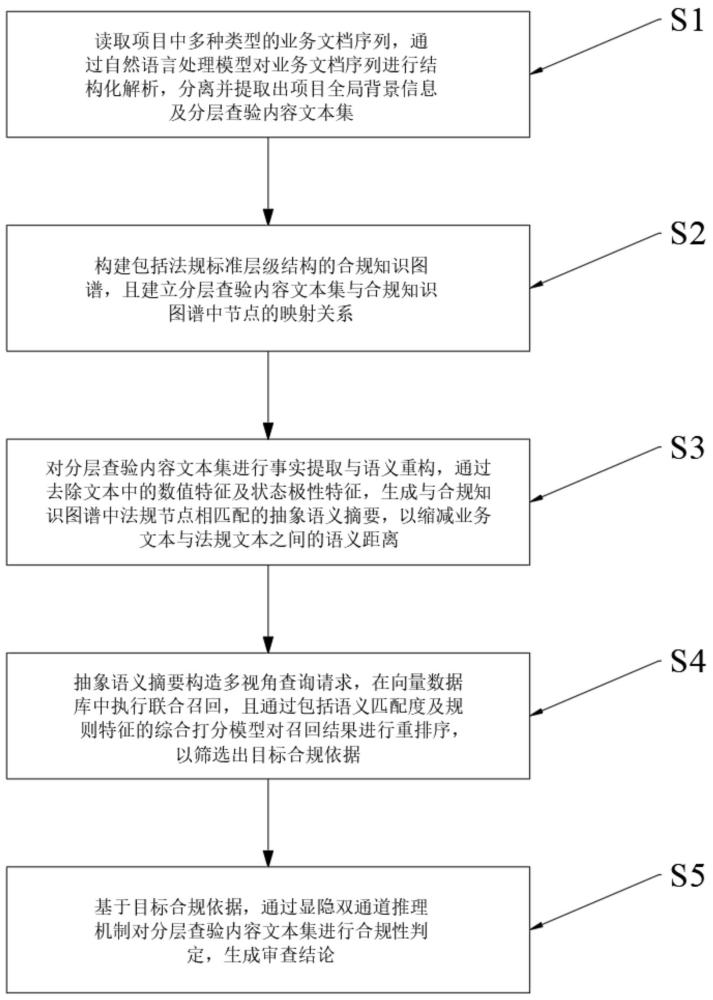
3、一种面向合规审查的多知识库构建与自动推理方法,包括下述步骤:
4、s1. 读取项目中多种类型的业务文档序列,通过自然语言处理模型对所述业务文档序列进行结构化解析,分离并提取出项目全局背景信息及分层查验内容文本集;
5、s2. 构建包括法规标准层级结构的合规知识图谱,且建立所述分层查验内容文本集与所述合规知识图谱中节点的映射关系;
6、s3. 对所述分层查验内容文本集进行事实提取与语义重构,通过去除文本中的数值特征及状态极性特征,生成与所述合规知识图谱中法规节点相匹配的抽象语义摘要,以缩减业务文本与法规文本之间的语义距离;
7、s4. 对所述抽象语义摘要构造多视角查询请求,在向量数据库中执行联合召回,且通过包括语义匹配度及规则特征的综合打分模型对召回结果进行重排序,以筛选出目标合规依据;
8、s5. 基于所述目标合规依据,通过显隐双通道推理机制对所述分层查验内容文本集进行合规性判定,生成审查结论。
9、进一步地,在步骤s1中,通过读取多层嵌套word 或pdf的文档,以还原文档排版顺序,对于所述文档中的表格数据,提取为带列分隔符的markdown 字符流,且在首尾插入边界标识符以保留单元格的行列拓扑结构;
10、调用自然语言处理模型结合json格式化约束条件,提取所述业务文档序列中项目全局背景信息,且提取按大类及小节树状结构解析的分层查验内容文本集;
11、通过容错解析引擎对自然语言处理模型输出的json结构进行正则匹配修复。
12、进一步地,在步骤s2中,在离线阶段时,将规范性文档解析为包含多层级节点的知识图谱节点,以构建所述合规知识图谱,通过语义分析及规则匹配,生成节点之间的显式层级关系及隐式依赖关系边;在线审查时,通过动态图查询将所述业务标题映射至所述合规知识图谱的目标节点。
13、进一步地,在离线阶段时,通过将国家标准及规范录入图数据库,构建具有有向属性图的所述合规知识图谱,且所述知识图谱节点包括一级标题节点、二级标题节点、正文条款节点、表格节点及公式节点;
14、对于所述显式层级关系通过 has_chapter、has_section、has_clause 关联边建立,对于所述隐式依赖关系边通过大语言模型批量分析构建 dependency 边,并通过正则表达式扫描条款文本中关联的图表编号,跨层级生成 has_table、has_formula 边;
15、在线审查时,所述动态路径查询采用图谱变长路径递归查询,过滤并向下贯穿至没有子节点的叶子节点,以将提取到的文档标题向所述合规知识图谱发起动态映射。
16、进一步地,在步骤s3中,通过大语言模型为所述合规知识图谱中每条法规生成提炼宏观场景的广义摘要、提取具体约束参数精度摘要,且所述广义摘要、所述精度摘要及对应的条款原文,存储至向量数据库;
17、对所述分层查验内容文本集,通过噪声词过滤集合与关键实体集合对所述结构化事实的特征进行清洗,以获得二元组事实,将所述二元组事实进行去数值化重构桥接,生成抽象语义摘要,以使所述抽象语义摘要与所述广义摘要及所述精度摘要对齐至相同的抽象语义空间。
18、进一步地,在步骤s3中,对所述分层查验内容文本集进行事实提取与语义重构的步骤包括:
19、s3.1 将所述分层查验内容文本集切分为独立短句,且提取短句中的查验点及对应的实测值或状态;
20、s3.2 预设的黑名单和白名单对提取结果进行清洗过滤,以获得所述所述二元组事实,所述黑名单包含评价性词汇,所述白名单包含实体专业词汇;
21、s3.3 对所述二元组事实的查验点及对应的实测值或状态进行去数值化处理,调用大语言模型生成描述查验主题的去数值化的所述抽象语义摘要。
22、进一步地,在步骤s4中,所述多视角查询请求包括原始长句、带有章节标题的结构化短句、去数值化的语义摘要、增强复合句、纯查验点提炼句;在向量数据库中对包含不同颗粒度摘要的子向量集合发起联合召回,以将返回的碎片化文本根据其所属的统一条款id 进行哈希归并拼接,且获得召回结果,所述子向量集合包括广义集合、精度集合、原文集合;
23、对所述召回结果进行重排序的步骤包括:
24、s4.1 通过交叉编码器计算候选条款的深层语义得分;
25、s4.2 计算候选条款的关键字规则特征得分,所述关键字规则特征得分基于查询文本的术语集合在候选条款中的命中频次、查询视角宽度、数据源交叉深度及小节标题命中情况确定;
26、s4.3 融合所述深层语义得分与所述关键字规则特征得分,计算得到综合总得分并进行排序。
27、进一步地,在步骤s4.2中所述关键字规则特征得分的计算方法为:
28、 公式(1)
29、其中,为关键字规则特征得分;为该术语集合在候选文档内容及各级标题中命中的有效频次;为命中该候选文档的不同查询视角数量,表示对应特征宽度的泛化能力;为命中的子集合数量,表示广义集合、精度集合、原文集合,对应知识源的置信深度;为当前小节标题是否命中候选文档内容的布尔指示变量,其中命中取1,否则取0;0.45 为规则特征的强制截断上限,以防字面匹配分数过高淹没神经网络的语义判定;0.05、0.02、0.03、0.05为各特征项的权重;
30、在步骤s4.3中,所述综合总得分的计算方法为:
31、 公式(2)
32、其中,为综合总得分;为深层语义得分;为查询宽度奖励,,0.03为线性缩放系数,表示奖励增益率,每增加 1 个有效查询项,查询宽度奖励增加0.03分,0.12是查询宽度奖励的最大可能取值;为数据源交叉奖励,;
33、根据所述综合总得分进行倒序排列,且对出自同一标准的条款进行滑动窗口去重折叠,最终截取并保留得分下降梯次位于安全边距内的top-k最高分依据,传递进入下游推理阶段。
34、进一步地,在步骤s5中,合规性判定的步骤包括:
35、s5.1显式查验通道:若所述分层查验内容文本集映射有明确的条文编号,则直接从所述合规知识图谱中提取对应原文作为显式证据进行判定;
36、s5.2 隐式兜底通道:若显式查验通道未命中或判定结果置信度低于预设阈值,则调取历史纠错案例库,将项目全局背景信息、提取的事实、筛选出的目标合规依据及历史纠错案例融合拼装,输入大语言模型进行推理判定。
37、一种面向合规审查的多知识库构建与自动推理系统,执行一种面向合规审查的多知识库构建与自动推理方法,包括:
38、多源文档解析模块,用于串行读取多模态项目文档,提取结构化宏观背景参数及分层查验内容;
39、图谱构建与映射模块,用于在图数据库中建立法规实体关系网络,并提供业务数据向图谱规范节点的动态挂载接口;
40、语义桥接处理模块,用于实时剥离业务文本中的无效数值与极性状态,生成高维统一表示的语义摘要;
41、多路召回与排序引擎,用于执行多视角并发查询,并基于数学加权模型计算综合召回得分;
42、双通道推理与调度模块,包括连接图谱的显式查询组件、连接向量库的检索增强生成组件以及并发控制器,用于输出最终审查报告。
43、本发明的有益效果是:
44、利用去数值化的双向语义桥接,通过建立废话黑名单与基于专业词汇的实体白名单机制过滤无效查验项,彻底解决了合规数据与违规事实因为数值及状态对立导致的向量检索失效问题。摒弃了单纯依赖神经网络黑盒的排序方式,构建了基于多元规则特征打分的重排序数学模型,综合评估了深层交叉语义、硬匹配词频、查询视角广度与子集合交叉深度,打破了单一模型打分的局限性,大幅提升了条款召回的命中率。通过显式查验通道的图谱显式提取(graph)、隐式兜底通道的向量检索(vectordb)及纠错案例库增强相融合的双通道推理架构,在保障核心审查点溯源准确率的同时,极大增强了模型应对模糊文本或缺失规范时的鲁棒性,具备极高的工业落地价值。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com