
基于知识图谱的房产交易关联数据智能推荐系统及方法与流程
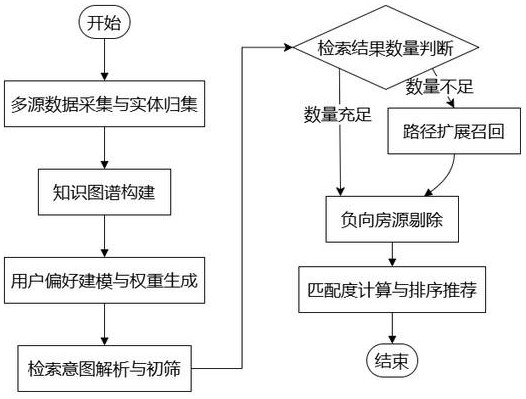
本发明涉及数据分析,具体是基于知识图谱的房产交易关联数据智能推荐系统及方法。
背景技术:
1、随着互联网技术与大数据分析的快速发展,房产交易平台积累了海量的房源信息与用户行为数据,推荐系统作为解决信息过载问题的有效工具,已被广泛应用于房产领域,帮助购房者从大量房源中筛选出符合自身需求的选项,知识图谱因其能够以结构化形式表达实体之间的语义关联,近年来被引入推荐系统以增强物品建模和用户偏好表示的能力。
2、现有推荐系统普遍以“点击率”作为衡量房源受欢迎程度的核心指标,默认“高点击率”对应“高推荐价值”,然而,房产市场存在特有的负向噪声信号,上述默认逻辑存在误判,一个小区因出租率高、换手率频繁,其房源信息会被大量租房用户频繁浏览点击,在点击率驱动逻辑下被系统误判为热门小区而获得高推荐权重,但小区的高换手率和高出租率恰恰意味着该小区以投资客和租户为主、业主自住比例低、人员结构不稳定,对于有购房自住需求的用户而言属于需要规避的负向特征,可见,在房产推荐场景中,高点击率与高推荐价值之间不仅不存在正相关,甚至可能呈现负相关,现有技术因缺乏对“高点击率可能由高流动性导致而实际为负向信号”这一因果误判的认知,始终未能构建出有效的识别与滤除机制。
技术实现思路
1、本发明的目的在于提供基于知识图谱的房产交易关联数据智能推荐系统及方法,以解决现有技术中提出的问题。
2、为实现上述目的,本发明提供如下技术方案:基于知识图谱的房产交易关联数据智能推荐方法,该方法包括以下步骤:
3、采集多源房产交易数据,将采集的数据按照预设实体类型进行分类归集;
4、基于分类归集后的各实体类型,构建房产交易知识图谱;
5、针对每一用户实体,根据该用户实体的历史交互记录计算其在不同房源属性维度上的偏好强度值,经归一化处理后构建该用户的偏好强度分布向量,并根据所述偏好强度分布向量提取该用户的主偏好标签和次偏好标签;
6、当接收到目标用户的检索请求时,根据该目标用户的历史交互记录确定其在不同属性维度上的初始权重系数,以该目标用户的主偏好标签对应的偏好强度值作为强化因子对所述初始权重系数进行强化处理并归一化,生成该目标用户在各属性维度上的最终权重系数;
7、在接收到目标用户的检索请求后,在所述知识图谱中进行检索以得到候选房源集合,从中剔除具有负向标记的房源实体;利用所述最终权重系数与候选房源在各属性维度上的属性评分计算各候选房源的匹配度得分,根据匹配度得分进行排序并选取排序靠前的房源生成个性化推荐列表。
8、采集房产交易历史数据,将采集的数据按照预设实体类型进行分类归集,具体步骤包括:
9、采集房产交易历史数据,所述房产交易历史数据包括房源挂牌数据、交易成交数据、用户行为日志数据及小区基础信息数据;所述房源挂牌数据包括房源唯一标识、房源地理位置坐标、建筑面积、户型结构、所在楼层、总楼层、朝向、房龄、物业类型及挂牌价格;所述交易成交数据包括交易房源标识、交易双方身份标识、成交价格及成交时间;所述用户行为日志数据包括用户唯一标识、用户对各房源的浏览记录、收藏记录、分享记录、咨询记录及预约看房记录及各行为对应的时间戳;所述小区基础信息数据包括小区唯一标识、小区名称、所属区域、建成年代、容积率、绿化率、物业公司名称、物业费标准及小区总户数;
10、对采集到的房产交易历史数据按照实体类型进行分类归集,所述实体类型包括房源实体、用户实体、小区实体、区域实体及交易实体,对各实体类型分别提取对应的属性字段集合,其中,所述房源实体的属性字段集合包括房源唯一标识、所在小区唯一标识、建筑面积、户型结构、所在楼层、总楼层、朝向、房龄及挂牌价格;所述用户实体的属性字段集合包括用户唯一标识、用户姓名、年龄段、职业类别及历史交互记录;所述小区实体的属性字段集合包括小区唯一标识、小区名称、所属区域唯一标识、建成年代、总户数;所述区域实体的属性字段集合包括区域唯一标识、区域名称及所属城市;所述交易实体的属性字段集合包括交易唯一标识、关联房源唯一标识、买方用户唯一标识、卖方用户唯一标识、成交价格及成交时间;
11、所述房源实体的属性字段集合中还包括房源属性维度标签,所述房源属性维度标签包括交通便利属性维度标签、学区属性维度标签及物业品质属性维度标签;所述交通便利属性维度的标签取值根据该房源所在小区与最近交通枢纽的距离,经归一化映射后得到该房源的交通便利属性评分;所述学区属性维度的标签取值根据该房源所在小区对口学校的办学等级,经归一化映射后得到该房源的学区属性评分;所述物业品质属性维度的标签取值根据该房源所在小区的物业公司等级和物业费标准,经归一化综合映射后得到该房源的物业品质属性评分;上述三个属性维度的归一化评分在数据入库阶段预先计算并作为房源实体的属性值存储;
12、交通便利属性维度的标签取值根据该房源所在小区与最近交通枢纽的步行距离确定,具体为:将预设的最近距离阈值和预设的最远距离阈值作为映射边界,当该房源所在小区与最近交通枢纽的步行距离不超过所述最近距离阈值时,交通便利属性评分取值为1;当该房源所在小区与最近交通枢纽的步行距离超过所述最远距离阈值时,交通便利属性评分取值为0;当该房源所在小区与最近交通枢纽的步行距离介于所述最近距离阈值和所述最远距离阈值之间时,交通便利属性评分取值为1减去该距离与所述最近距离阈值的差值除以所述最远距离阈值与所述最近距离阈值的差值所得的商;
13、学区属性维度的标签取值根据该房源所在小区对口学校的办学等级确定,办学等级包括省级重点、市级重点、区级重点及普通学校四个等级;根据办学等级从高到低依次设定对应的评分范围,省级重点赋予0.85到1.0区间内的评分,市级重点赋予0.70到0.84区间内的评分,区级重点赋予0.50到0.69区间内的评分,普通学校赋予0.20到0.49区间内的评分;
14、物业品质属性维度的标签取值根据该房源所在小区的物业公司等级确定,物业公司等级包括一级资质、二级资质和三级资质三个等级。根据物业资质等级从高到低赋予对应的等级评分,一级资质物业公司赋予0.85到1.0区间内的评分,二级资质物业公司赋予0.60到0.80区间内的评分,三级资质物业公司赋予0.30到0.50区间内的评分,同一资质等级内部,根据物业公司的品牌影响力、管理规模、业主满意度和市场口碑进一步细分评分;
15、所述用户实体的属性字段中还包括历史交互记录,所述历史交互记录中的每一交互记录包括交互对象房源唯一标识、交互行为类型及交互时间戳;所述交互行为类型包括浏览、收藏、分享、咨询及预约看房;
16、各实体类型之间通过唯一标识字段进行关联,所述关联关系包括房源与小区之间的归属关联、小区与区域之间的包含关联、交易与房源之间的交易关联、交易与用户之间的参与关联;
17、具体来说各实体类型之间通过唯一标识字段进行关联,所述房源实体通过所在小区唯一标识与所述小区实体关联,所述小区实体通过所属区域唯一标识与所述区域实体关联,所述交易实体通过关联房源唯一标识与所述房源实体关联并通过买方用户唯一标识和卖方用户唯一标识与所述用户实体关联;
18、针对每一小区实体,计算该小区实体的年度换手率和年度出租率作为该小区实体的市场运行属性;
19、所述年度换手率定义为该自然年度内该小区完成产权变更的房屋套数与该小区总户数的比值;
20、所述年度出租率定义为该自然年度内该小区处于出租状态的房屋套数与该小区总户数的比值;
21、将年度换手率超过预设第二阈值或年度出租率超过预设第三阈值的小区实体标记为高流动性小区,将年度换手率未超过预设第二阈值且年度出租率未超过预设第三阈值的小区实体标记为稳定居住小区;将所述高流动性小区标记和稳定居住小区标记写入对应小区实体的属性字段集合,其中,所述第二预设阈值可选为20%,所述第三预设阈值可选为15%。
22、基于分类归集后的各实体类型,设计房产交易知识图谱的本体模型,根据设计的本体模型,从房产交易历史数据中抽取各实体实例及各实体实例之间的关联关系,将抽取结果以知识三元组的形式表达,将生成的所有知识三元组导入图数据库,构建房产交易知识图谱的数据层,具体步骤包括:
23、基于分类归集后的各实体类型,设计房产交易知识图谱的本体模型,所述本体模型用于定义知识图谱的实体层级体系和关系类别体系,构成知识图谱的模式层;所述实体层级体系自上而下包括区域层实体、小区层实体及房源层实体,用户层实体与房源层实体并列,使用户层实体通过浏览、收藏、咨询及交易等行为关系与房源层实体建立直接的语义关联,形成完整的用户与房源交互链路;所述关系类别体系包括区域与小区之间的包含关系、小区与房源之间的归属关系、用户与房源之间的浏览关系、用户与房源之间的收藏关系、用户与房源之间的咨询关系、用户与房源之间的交易关系及用户与用户之间相似关系;
24、具体来说基于分类归集后的各实体类型,设计房产交易知识图谱的本体模型,所述本体模型用于定义知识图谱的实体层级体系和关系类别体系,构成知识图谱的模式层;所述实体层级体系自上而下包括区域层实体、小区层实体及房源层实体,用户层实体与房源层实体并列;所述关系类别体系包括区域与小区之间的包含关系、小区与房源之间的归属关系、用户与房源之间的浏览关系、用户与房源之间的收藏关系、用户与房源之间的咨询关系、用户与房源之间的交易关系及用户与用户之间的相似关系,所述相似关系用于表示两个用户在房产偏好上的相似性,基于用户的历史交互行为特征和静态属性特征的相似度计算生成,为双向关系,其强度通过余弦相似度或皮尔逊相关系数量化,当相似度超过预设阈值时在对应的两个用户实体之间建立该关系边,其中,预设阈值根据历史用户偏好数据的统计分析确定,具体为对知识图谱中所有已存在相似关系的用户对计算相似度分布,取相似度分布的中位数或第三四分位数作为该预设阈值,历史交互行为特征包括用户对交通便利、学区属性、物业品质属性维度房源的浏览次数、收藏次数及咨询次数,静态属性特征包括用户的年龄段、职业类别及所属地域;
25、根据设计的本体模型,从房产交易历史数据中抽取各实体实例及各实体实例之间的关联关系,将抽取结果以知识三元组的形式表达,所述知识三元组的结构为<头实体,关系,尾实体>;将各小区实体的流动性类型标记作为对应小区实体的附加属性写入知识三元组,将各房源实体的正负向标记作为对应房源实体的附加属性写入知识三元组,流动性类型标记包括高流动性标记和稳定居住标记;
26、将生成的所有知识三元组导入图数据库,构建房产交易知识图谱的数据层;在图数据库中为各实体节点建立倒排索引,所述倒排索引的键为实体属性值,值为对应实体节点在图数据库中的唯一标识。
27、针对每一用户实体,获取该用户实体的历史交互记录,计算各交互操作的原始贡献值;按照交互对象的不同属性维度分别累加原始贡献值,得到该用户在各属性维度上的偏好强度值,并将各属性维度的偏好强度值进行归一化处理,构建该用户的偏好强度分布向量;根据所述偏好强度分布向量提取该用户的主偏好标签和次偏好标签,具体步骤包括:
28、针对每一用户实体,从提取到的该用户实体的属性字段中获取该用户的历史交互记录,对每一操作类型,以该操作发生的时间距当前时间的间隔时长的倒数作为该操作的时序权重,以该操作的执行次数作为该操作的频次权重,计算该操作的原始贡献值cu,b,t,定义如下所示:
29、cu,b,t=fu,b,t/(1+δtu,b,t);
30、其中,cu,b,t表示用户u的第b类行为中第t次操作的原始贡献值,fu,b,t表示用户u的第b类行为的频次权重,δtu,b,t表示用户u的第b类行为中第t次操作发生时间距当前时间的间隔天数,u表示用户实体的唯一标识,b表示交互行为类型编号,b∈{1,2,3,4,5},分别对应浏览、收藏、分享、咨询、预约看房五种行为类型,t表示某类行为中的操作次序编号,其按该行为的发生时间顺序排序;
31、该公式中,时序权重采用1+δtu,b,t的形式,其原因在于:当δtu,b,t=0时,即交互操作发生在当天,该操作的时序权重为1,表示当前时刻的行为对反映用户当下偏好具有最高的参考价值,应予以完整保留;随着δtu,b,t逐渐增大,即操作发生时间距当前越来越久远,时序权重单调递减,表示历史越久远的行为对预测用户当前偏好的参考价值越低;
32、在分子部分,直接采用该操作类型的历史执行次数fu,b,t作为频次权重,用户执行某一行为类型的次数越多,表明用户对该类型行为的依赖程度越高,该操作对偏好强度计算的贡献也越大;
33、原始贡献值cu,b,t计算步骤体现高频次与近时性共同放大贡献值、低频次与远时性共同缩小贡献值;
34、对每一用户实体,按照交互对象的不同属性维度分别计算偏好强度值,定义如下所示:
35、pu,d=σb=15σt=1n(u,b,d)cu,b,t;
36、其中,pu,d表示用户u在属性维度d上的偏好强度值,n(u,b,d)表示用户u在属性维度d上产生的第b类行为的总次数,d表示房源属性维度编号,d∈{1,2,3},分别对应交通便利属性维度、学区属性维度、物业品质属性维度;
37、该公式从两个维度对用户的历史交互行为进行累加求和,以量化用户在不同房源属性维度上的偏好程度;
38、第一层内层累加内层求和是针对同一用户在同一属性维度上产生的同一类交互行为的多次操作进行汇总,用户可能多次执行相同类型的交互行为,例如浏览了多套交通便利的房源,每次浏览操作均产生一个原始贡献值cu,b,t,内层求和将这些贡献值逐一累加,得到该用户在特定属性维度上某一类行为的累计贡献;
39、第二层外层累加求和是针对五种不同类型的交互行为进行汇总,包括浏览、收藏、分享、咨询及预约看房,不同类型的交互行为反映了用户不同程度的关注意愿,预约看房的用户通常比仅浏览的用户具有更强的购房意向,该累加操作将所有行为类型的贡献值统一纳入偏好强度的计算,避免遗漏任一行为类型所蕴含的偏好信息;
40、通过上述双层累加,pu,d反映了用户在属性维度d上全部历史交互行为的综合贡献,该值越大,表示用户在该属性维度上的偏好越强烈;
41、将各属性维度的偏好强度值进行归一化处理,得到交通便利属性维度的偏好强度值p'u,1、学区属性维度的偏好强度值p'u,2、物业品质属性维度的偏好强度值p'u,3,构建该用户的偏好强度分布向量(p'u,1,p'u,2,p'u,3);
42、根据构建的偏好强度分布向量,对每一个用户实体提取偏好标签,所述偏好标签包括一个主偏好标签和若干个次偏好标签;所述主偏好标签为偏好强度值最高的属性维度所对应的标签,所述次偏好标签为偏好强度值排名第二及第三的属性维度所对应的标签;所述偏好标签包括通勤优先标签、学区优先标签及物业优先标签三种类型;
43、以标记的高流动性小区和稳定居住小区为依据,对知识图谱中的房源实体进行正负向标记,将属于稳定居住小区的所有房源实体标记为正向房源实体;将属于高流动性小区的所有房源实体标记为负向房源实体;将所述正负向标记作为对应房源实体的附加属性写入知识图谱。
44、当接收到目标用户的检索请求时,计算该目标用户在各属性维度上的初始权重系数;从所述偏好强度分布向量中提取该目标用户的主偏好标签对应的偏好强度值作为强化因子,对所述初始权重系数进行强化处理,将强化后的各属性维度的权重系数重新进行归一化处理,将归一化后的各属性维度的权重系数作为该目标用户在各属性维度上的最终权重系数,具体步骤包括:
45、构建属性与房源关联索引表并存储于配置数据库中;
46、属性与房源关联索引表中记录每一房源实体在各属性维度上的属性标签取值,所述属性标签包括交通便利标签、学区标签及物业品质标签;
47、当接收到目标用户的检索请求时,提取该目标用户的历史交互记录,统计该目标用户交互过的所有房源实体在属性与房源关联索引表中各属性标签的分布比例,以该分布比例直接作为该目标用户在各属性维度上的初始权重系数,设目标用户交互过的房源实体总数为c,其中,携带交通便利标签的房源数量为c1、携带学区标签的房源数量为c2、携带物业品质标签的房源数量为c3,则用户u在交通便利属性维度、学区属性维度、物业品质属性维度的初始权重系数分别为wu,10、wu,20、wu,30,则该目标用户的初始权重系数向量为(wu,10,wu,20,wu,30);
48、用户u在属性维度d上的初始权重系数wu,d0,定义如下所示:wu,d0=cd/c;其中,wu,d0表示用户u在属性维度d上的初始权重系数,cd表示用户u交互过的所有房源中,携带属性维度d标签的房源数量;
49、上述公式的含义为用户交互过的房源中,带有某一属性标签的房源占比越高,说明用户对该属性的偏好越强,例如,用户甲交互过的50套房源中有45套位于地铁站附近,即携带交通便利标签,则其在交通便利维度上的初始权重系数为45/50=0.90,表明交通便利是其显著偏好;
50、从计算的偏好强度分布向量中提取该目标用户的主偏好标签对应的偏好强度值p,p满足1/3≤p≤1;当p=1/3时,用户在三个属性维度上偏好均等,各维度权重保持不变,不进行偏好强化;当p>1/3时,用户存在明确的主偏好,以p作为强化因子对主偏好维度进行权重增强;
51、以p作为强化因子,对生成的初始权重系数向量进行强化处理,
52、若d=dmain,则wu,d1=wu,d0×p;
53、若d≠dmain,则wu,d1=wu,d0×(1-p)/2;
54、其中,wu,d1表示用户u在属性维度d上强化处理后的未归一化权重,dmain表示主偏好标签对应的属性维度编号;
55、该公式中主偏好维度乘以p是因为p为用户在主偏好维度上的偏好强度值,取值范围为(1/3,1],该值越大,表明用户在该维度上的偏好越集中,强化力度应越强,其他维度乘以(1-p)/2是因为所有维度强化后的总权重应保持相对合理分布,且p越大时,其他维度的强化因子(1-p)/2越小;
56、由于用户对交通便利、学区、物业品质三个属性维度的偏好强度值之和等于1,当主偏好的偏好强度值为p时,其余两个非主偏好维度的偏好强度值之和为1-p,如果将剩余总量1-p中的一部分分配给两个非主偏好维度,需要确保二者在强化后的权重仍然保持相对合理的比例关系,采用(1-p)/2的形式,意味着将非主偏好的剩余总量在三个维度各自的初始权重分布中按同一比例统一压缩,两个非主偏好维度均乘以相同的因子(1-p)/2;
57、将强化后的各属性维度的权重系数重新进行归一化处理,使强化后的所有权重系数之和等于1,将归一化后的各属性维度的权重系数作为该目标用户在各属性维度上的最终权重系数;
58、将所述最终权重系数与该目标用户的用户唯一标识关联存储于配置数据库中。
59、接收目标用户输入的检索请求,基于此得到初筛检索结果集合,从所述初筛检索结果集合中读取各房源实体的正负向标记,剔除标记为负向的房源实体,形成候选房源集合;读取该目标用户在各属性维度上的最终权重系数,利用所述最终权重系数对候选房源集合中各房源实体在各属性维度上的属性评分进行加权求和,得到各房源实体的综合匹配度得分;按照综合匹配度得分从高到低的顺序对候选房源进行降序排列,选取排序靠前的预设数量的房源实体生成个性化推荐列表,具体步骤包括:
60、接收目标用户输入的检索请求,对所述检索请求进行意图解析并提取显式约束条件;根据所述显式约束条件在所述知识图谱中进行初筛检索,得到初筛检索结果集合;当所述初筛检索结果集合中的房源实体数量小于预设数量阈值时,以所述显式约束条件中的区域约束为锚点,沿知识图谱中区域实体至小区实体至房源实体的关系路径向外扩展检索,将扩展检索得到的房源实体补充入初筛检索结果集合,直至集合中的房源实体数量达到所述预设数量阈值;
61、从得到的初筛检索结果集合中,读取各房源实体的正负向标记,剔除标记为负向的房源实体,形成候选房源集合a;
62、从候选房源集合中各房源实体的属性字段中读取预先存储的交通便利属性评分、学区属性评分和物业品质属性评分,分别记为sz,1、sz,2、sz,3;利用目标用户在各属性维度上的最终权重系数wu,11、wu,21、wu,31进行加权求和,计算综合匹配度得分,计算步骤如下所示:
63、score(u,z)=σd=13wu,d1×sz,d;
64、其中,score(u,z)表示目标用户u对房源实体z的综合匹配度得分,z表示房源实体,任意房源实体z属于候选房源集合a,sz,d表示房源实体z在属性维度d上的归一化属性评分;
65、该公式中权重系数反映了用户在不同属性维度上的偏好程度,属性评分反映了房源在各维度上的客观表现,二者相乘后加总,使得偏好程度高的属性维度在最终得分中占据主导地位,同一套房源在不同用户下会得到不同的得分,实现了推荐结果的个性化;同一用户在不同房源下也会得到不同的得分,实现了房源之间的可排序性;
66、按照综合匹配度得分从高到低的顺序对候选房源进行降序排列,选取排序靠前的预设数量的房源实体生成个性化推荐列表。
67、基于知识图谱的房产交易关联数据智能推荐系统,该系统包括:
68、数据采集模块、图谱构建模块、偏好建模模块、推荐生成模块;
69、所述数据采集模块的输出端连接所述图谱构建模块的输入端;
70、所述图谱构建模块的输出端连接所述偏好建模模块的输入端;
71、所述偏好建模模块的输出端连接所述推荐生成模块的输入端。
72、所述数据采集模块包括数据接入单元、实体归集单元、指标计算单元;
73、所述数据接入单元用于采集房源挂牌数据、交易成交数据、用户行为日志数据及小区基础信息数据;
74、所述实体归集单元用于将采集的数据按照房源实体、用户实体、小区实体、区域实体及交易实体进行分类归集,提取各实体的属性字段;
75、所述指标计算单元用于针对每一小区实体计算年度换手率和年度出租率,根据预设阈值将小区标记为高流动性小区或稳定居住小区,生成各房源的正负向标记;
76、所述图谱构建模块用于构建房产交易知识图谱,将分类归集后的实体及关系以知识三元组形式存储于图数据库中。
77、偏好建模模块包括贡献计算单元、偏好量化单元和权重生成单元;
78、所述贡献计算单元用于获取用户的历史交互记录,以交互操作的执行次数为频次权重、以交互操作距当前时间的间隔时长的单调递减函数为时序权重,计算各交互操作的原始贡献值;
79、所述偏好量化单元用于按照交互对象的不同属性维度分别累加原始贡献值,得到用户在各属性维度上的偏好强度值,经归一化处理后构建用户的偏好强度分布向量,提取主偏好标签和次偏好标签;
80、所述权重生成单元用于统计用户交互过的房源在各属性标签上的分布比例作为初始权重系数,以主偏好标签对应的偏好强度值作为强化因子进行强化处理并归一化,生成最终权重系数。
81、推荐生成模块包括意图解析单元、候选召回单元和匹配排序单元;
82、所述意图解析单元用于接收目标用户输入的检索请求,对检索请求进行意图解析并提取显式约束条件;
83、所述候选召回单元用于根据显式约束条件在知识图谱中进行初筛检索,当检索结果数量不足时向外扩展补充,并从检索结果中剔除具有负向标记的房源实体,形成候选房源集合;
84、所述匹配排序单元用于读取目标用户的最终权重系数与候选房源在各属性维度上的属性评分,计算各候选房源的匹配度得分,按得分降序排列并选取排序靠前的房源生成个性化推荐列表。
85、与现有技术相比,本发明的有益效果是:
86、1、通过计算各小区实体的年度换手率和年度出租率,结合预设的换手率阈值和出租率阈值对小区进行流动性类型标记,并据此对房源实体进行正负向标记,将负向房源在推荐生成前的召回阶段予以剔除,与现有技术中通过降低点击率权重进行数值调整的方式不同,本发明构建了贯穿数据识别、图谱标记、召回剔除及动态重标全流程的负向信号独立滤除通道,避免高流动性房源进入推荐列表的可能性;
87、2、通过以交互操作的执行次数为频次权重、以交互操作发生时间距当前时间的间隔时长的单调递减函数为时序权重,计算各交互操作的原始贡献值,按照交互对象的不同属性维度分别累加得到用户在各属性维度上的偏好强度值,经归一化处理后构建用户的偏好强度分布向量,并结合用户历史交互房源在各属性标签上的分布比例生成初始权重系数,再以主偏好强度值作为强化因子进行强化处理,生成个性化最终权重系数,与现有技术中采用统一推荐模型或依赖人工预设权重的方式不同,本发明实现了用户偏好的数据驱动建模和差异化权重分配,使同一房源在不同用户下获得不同的匹配度得分,从而有效提升了推荐结果的个性化程度和精准度;
88、3、通过构建房产交易知识图谱将各实体的流动性标记和正负向标记作为附加属性写入知识三元组,结合知识图谱中区域与小区之间的包含关系、小区与房源之间的归属关系以及用户与房源之间的交互关系,在多维约束条件下实现候选房源的关联检索与路径扩展,并对检索结果进行匹配度加权排序,与现有技术中单一维度匹配或仅依靠用户-物品交互矩阵的方式不同,本发明能够同时处理区域、户型及多维属性偏好的组合推理。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com