
面向自主控制系统智能模型错误修复与联合评估方法
本技术涉及人工智能与数据处理,具体涉及面向自主控制系统智能模型错误修复与联合评估方法。
背景技术:
1、随着人工智能技术的迅猛发展,以智能网联汽车、无人机集群为代表的自主控制系统在交通、物流、国防和工业生产等领域的应用规模呈现指数级增长。在此类系统中,传统的基于规则和有限状态机的控制系统主要遵循“找规律—建模—决策”的工程范式。虽然这种工程范式具有较强的可解释性和形式化验证能力,但在面对高度动态、多主体博弈交互的复杂物理场景时,往往面临着数学建模困难、边缘场景规则覆盖不足以及场景迁移成本高昂等诸多问题。
2、为了克服传统规则控制的局限性,现代自主控制系统日益依赖于数据驱动的深度学习与强化学习技术。深度强化学习通过智能体与环境的持续闭环交互,在马尔可夫决策过程的理论框架下,学习端到端的策略映射。以自动驾驶场景为例,车辆需要在多源感知输入、强时序约束和多参与体交互的交通环境中,自主完成车道保持、自动跟车、变道超车及避碰控制等复杂任务。数据驱动方法使得系统能够在无需手动穷举全部交通规律的情况下形成强大的泛化决策能力,显著降低了手工建模成本。通常,此类系统采用深度q网络或策略梯度方法,通过多层非线性特征变换,将高维感知状态空间映射到连续或离散的动作价值空间,并依赖贝尔曼方程进行价值迭代更新 。
3、然而,智能决策模型在带来系统性能跃升的同时,也引入了前所未有的工程挑战。由于模型内部包含成千上万的神经元和高维连接权重,其决策机理呈现出极强的黑盒特性。当模型部署到充满长尾分布偏移的真实物理系统时,极易因未见过的状态输入而产生策略偏差,进而诱发诸如车辆碰撞、系统失控等严重的安全事故。一旦通过前置的错误定位机制精准锁定了导致宏观失效的微观异常神经元,如何对这些故障神经元进行有效的修复,便成为了阻碍自主控制系统规模化与商业化应用的关键技术瓶颈。针对特定故障神经元的参数空间、结构空间与激活空间,当前工程实践亟需一种有针对性的、能在局部收敛错误,且具备安全回归验证能力的模型自动修复方法体系。
技术实现思路
1、本技术公开了一种面向自主控制系统智能模型错误修复与联合评估方法、装置、电子设备及存储介质,旨在解决在缺乏完备测试语言的无标签交互环境中,当深度强化学习策略网络被检测出导致系统性能退化或决策错误的内部微观神经元缺陷后,如何自动、精细、安全且低成本地对这些故障神经元实施参数级或结构级的精准修复的技术问题。
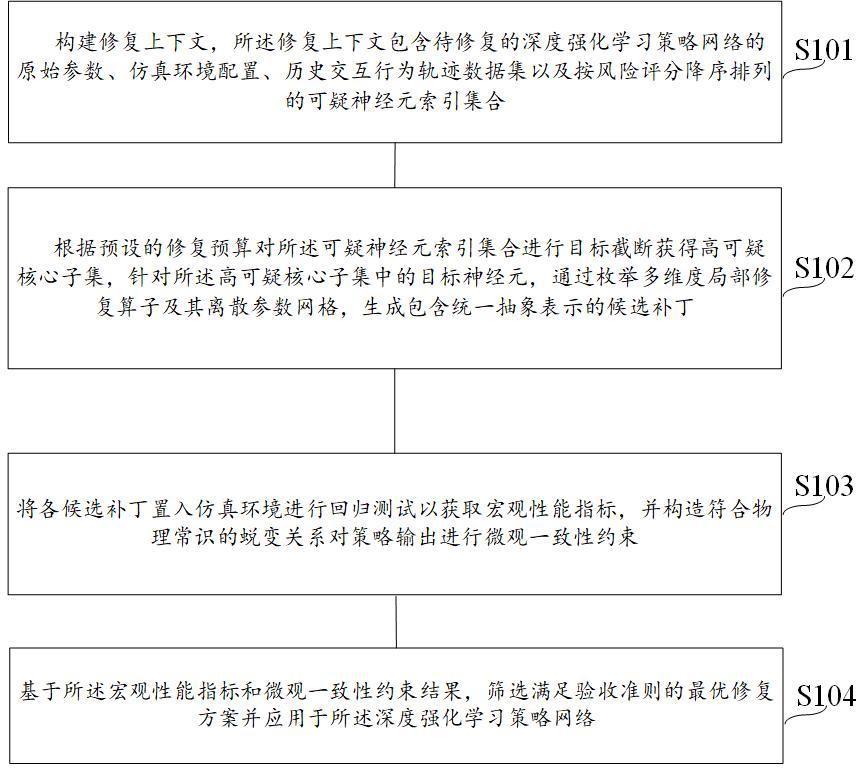
2、为了实现上述目的,本技术第一方面提供一种面向自主控制系统智能模型错误修复与联合评估方法,包括:构建修复上下文,所述修复上下文包含待修复的深度强化学习策略网络的原始参数、仿真环境配置、历史交互行为轨迹数据集以及按风险评分降序排列的可疑神经元索引集合;根据预设的修复预算对所述可疑神经元索引集合进行目标截断获得高可疑核心子集,针对所述高可疑核心子集中的目标神经元,通过枚举多维度局部修复算子及其离散参数网格,生成包含统一抽象表示的候选补丁;将各候选补丁置入仿真环境进行回归测试以获取宏观性能指标,并构造符合物理常识的蜕变关系对策略输出进行微观一致性约束;基于所述宏观性能指标和微观一致性约束结果,筛选满足验收准则的最优修复方案并应用于所述深度强化学习策略网络。
3、可选地,所述构建修复上下文包括:将原始参数、仿真环境配置、历史交互行为轨迹数据集、可疑神经元索引集合以及联合验证所需的评价配置参数集合封装为五元组结构;其中,历史交互行为轨迹数据集包含状态矢量、动作分布及奖惩明细。
4、可选地,多维度局部修复算子包括权重扰动算子、权重正则化算子、神经元剪枝与局部重连算子以及激活幅度裁剪算子;其中,权重扰动算子在目标神经元的局部参数邻域内注入独立同分布零均值高斯噪声以打破异常激活极值;权重正则化算子通过范数收缩平滑目标神经元的响应以降低其对全局动作价值估计的过度支配;神经元剪枝与局部重连算子对失效神经元执行逻辑剪枝,并利用特征余弦相似度对比搜索同层邻近健康神经元,将废弃的出边权重按比例重新分配给邻居节点以保留网络判别能力;激活幅度裁剪算子在计算图的前向推理阶段插入动态截断函数,基于健康交互轨迹的统计期望与标准差设定自适应上下界以隔离异常过饱和信号。
5、可选地,生成包含统一抽象表示的候选补丁,包括:针对高可疑核心子集中的每一个目标神经元,外层循环遍历所有被激活的多维度局部修复算子类型,内层循环遍历针对该算子预先定义好的离散参数网格;每一次内部循环命中时,通过特定的算子映射逻辑生成一个包含唯一全局标识符、算子类型、目标神经元拓扑索引列表及元数据信息的补丁实例,并将其追加至候选补丁队列。
6、可选地,将各候选补丁置入仿真环境进行回归测试以获取宏观性能指标,包括:统计所有测试回合的未折扣累计奖励均值作为平均回报;计算累计奖励在不同回合间的波动方差作为回报方差;依据设定的环境通关条件统计模型达成最终目标的回合占比作为绝对成功率;监控跌破极低奖励阈值的崩溃回合发生频率作为极端失败比例。
7、可选地,构造符合物理常识的蜕变关系对策略输出进行微观一致性约束,包括:执行物理噪声鲁棒性验证:给定基础安全交通状态,对其传感器观测通道施加小幅物理微扰,检测修复后的模型在处理该组衍生测试对时输出的最优动作类别分布是否发生突变翻转;执行空间单调性验证:在自动跟车博弈场景中构造一组状态序列,在严格控制其余变量不变的前提下有序缩减自车与前车的纵向相对距离,检测针对加速突破动作的价值预测是否呈现严格单调递减趋势,以及针对紧急制动动作的价值预测是否保持单调递增趋势。
8、可选地,筛选满足验收准则的最优修复方案,包括:判断候选补丁的蜕变关系通过率是否为100%,且平均回报与成功率的退化幅度未击穿预设容忍阈值;若满足则判定为技术上可接受;针对所有通过验收的可接受补丁集合,构造综合加权评分函数,并引入基于单个补丁作用的神经元总数与堆叠算子个数的结构复杂性惩罚因数进行全序排列,截取榜首补丁作为最优修复方案。
9、为了实现上述目的,本技术第二方面还提供一种面向自主控制系统智能模型错误修复与联合评估装置,其中,上下文构建模块用于构建包含待修复的深度强化学习策略网络的原始参数、仿真环境配置、历史交互行为轨迹数据集以及按风险评分降序排列的可疑神经元索引集合的修复上下文;补丁生成模块用于根据预设的修复预算对可疑神经元索引集合进行目标截断获得高可疑核心子集,针对高可疑核心子集中的目标神经元,通过枚举多维度局部修复算子及其离散参数网格,生成包含统一抽象表示的候选补丁队列;联合验证模块用于将各候选补丁置入仿真环境进行回归测试以获取宏观性能指标,并构造符合物理常识的蜕变关系对策略输出进行微观一致性约束;方案输出模块用于基于宏观性能指标和微观一致性约束结果,筛选满足验收准则的最优修复方案并应用于深度强化学习策略网络。
10、为了实现上述目的,本技术第三方面还提供一种电子设备,包括处理器、存储器以及存储在存储器上并在处理器上运行的计算机程序,处理器执行计算机程序时实现如前面提供的面向自主控制系统智能模型错误修复与联合评估方法的步骤。
11、为了实现上述目的,本技术第四方面还提供一种计算机可读存储介质,其上存储有计算机程序,该程序被处理器执行时实现如前面提供的面向自主控制系统智能模型错误修复与联合评估方法的步骤。
12、本技术公开了一种面向自主控制系统智能模型错误修复与联合评估方法,方法包括构建修复上下文,所述修复上下文包含待修复的深度强化学习策略网络的原始参数、仿真环境配置、历史交互行为轨迹数据集以及按风险评分降序排列的可疑神经元索引集合;根据预设的修复预算对所述可疑神经元索引集合进行目标截断获得高可疑核心子集,针对所述高可疑核心子集中的目标神经元,通过枚举多维度局部修复算子及其离散参数网格,生成包含统一抽象表示的候选补丁;将各候选补丁置入仿真环境进行回归测试以获取宏观性能指标,并构造符合物理常识的蜕变关系对策略输出进行微观一致性约束;基于所述宏观性能指标和微观一致性约束结果,筛选满足验收准则的最优修复方案并应用于所述深度强化学习策略网络。本技术相较于现有的深度学习调试与模型加固技术,在自主控制领域带来了显著且极具工程价值的有益效果:第一,降低了时间与算力成本:业界传统的做法是花费数周时间去采集引发失误的长尾边缘场景数据,而后动用庞大算力对具有数千万参数的模型执行全局微调重训。本技术的修复方法直接作用于微观神经元节点,生成并验证热补丁的整个流程在常规计算节点上仅需数分钟即可收敛。第二,实现安全可控的模型修复:基于多类型神经元级修复算子与蜕变回归联合验证策略,在不破坏模型整体结构与原有正确行为的前提下(原成功保持率 100%),针对性修复局部故障,既避免了整体重训的高代价,又通过噪声鲁棒性、单调性等约束保障修复安全性,同时提升模型成功率与奖励稳定性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com