
基于专用AI工作站的代账全链路自动化记账凭证生成与校验系统及其方法与流程
本发明涉及人工智能、计算机软件及财务自动化,具体涉及一种基于专用ai工作站的代账全链路自动化记账凭证生成与校验系统及其方法。
背景技术:
1、随着会计信息化的发展,自动化账务处理相关技术逐步落地。当前行业主流技术方案可分为三类:
2、(一)业务系统与财务软件对接类自动化方案
3、现有技术多通过接口对接生产、销售等业务系统与用友u8等核算软件,依靠预设凭证模板实现业务数据单向导入、自动生成记账凭证;部分研究基于rea会计模型、eca事件规则引擎搭建财务业务一体化系统,依靠固定逻辑匹配分录规则完成制单。该类技术仅聚焦单一业务-核算系统的数据流转,依赖预设静态模板与固定规则库,仅能完成凭证生成单一环节,无法覆盖代账完整业务链条。
4、(二)通用计算机/移动端财务软件自动化系统
5、行业内存在基于pc端c/s架构、安卓移动端的财务记账管理系统,依靠通用cpu、嵌入式数据库完成账目分类、凭证管理、期末核算等标准化操作。此类产品均为纯软件架构,依托通用算力设备运行,无针对代账场景优化的专用硬件算力载体,批量处理效率低,且无法7×24小时持续批量处理账务。
6、(三)传统人工代账作业模式
7、中小代账机构主流仍依靠中级会计人工全流程处理:手工归集发票、银行流水等原始单据,人工录入财务软件编制凭证、核对账目,手动切换开票、社保、电子税务局多平台完成开票、薪资调整、纳税申报。常规中级会计单人每月仅可处理80-100套一般纳税人账务,人力成本高、产能上限低。
8、现有技术普遍存在以下缺陷:(1)自动化覆盖范围窄,各财税平台相互独立,数据需人工跨系统搬运,无法实现全链路闭环;(2)依赖静态固定规则,不具备自主学习与自适应能力;(3)无代账专用软硬一体化算力设备,批量处理效率存在硬性瓶颈;(4)账务校验滞后,无法实时发现分录错配、报税错报等问题,财税合规风险突出。
技术实现思路
1、针对现有技术中人工做账效率低下、多系统割裂无法全流程自动化、无专用硬件载体算力不足、账务校验滞后合规风险高等技术问题,本发明提供了一种基于专用ai工作站的代账全链路自动化记账凭证生成与校验系统及其方法。
2、为实现上述目的,本发明提供如下技术方案:
3、1. 系统整体架构
4、本发明系统包括:定制ai算力主板,搭载专用ai推理芯片及npu加速单元;高速固态存储单元(16g运行内存、2tb高速固态存储);多软件自动操控驱动模块,内置虚拟键鼠及界面识别驱动组件;网络通信单元(有线网口+无线双模块);外设交互单元(usb、hdmi通用接口及本地操作界面)。各单元以定制ai算力主板为核心调度中枢,通过板载总线连接,整机通电后各单元同步启动,实现即插即用-。
5、2. 财税专用深度学习模型
6、本发明软件算法部分由三个级联子网络构成完整的“图像输入→版面字段定位→文字识别→账务推理→分录输出”闭环处理链路。
7、(1)图像识别分支(版面与字段定位子网络)
8、输入:单据原始图像经等比缩放并补边归一化为640×640×3的rgb张量。
9、骨干网络为轻量化cnn,共5个stage:stem为标准卷积+bn+h-swish(3×3/stride2,输出通道16);stage1包含2个深度可分离卷积块(3×3/stride2,1,输出通道24);stage2包含3个深度可分离卷积块(5×5/stride2,1,1,输出通道40,带se注意力机制,压缩比1/4);stage3包含4个深度可分离卷积块(3×3/stride2,1,1,1,输出通道80);stage4包含2个深度可分离卷积块(5×5/stride1,1,输出通道160,带se注意力机制,压缩比1/4)。
10、取stage2(80×80)、stage3(40×40)、stage4(20×20)三级特征图,经1×1卷积统一通道数为96后,采用自顶向下上采样(最近邻2倍)与逐元素相加的方式构建特征金字塔。检测头采用无锚点中心点检测结构,输出字段类别热力图(约22类)、中心点偏移量及边界框宽高回归值。
11、(2)文字识别分支(crnn文字识别模块)
12、输入:字段裁剪区域图像,统一缩放为32×320×1的单通道灰度图。
13、网络结构依次为:conv1(3×3/stride1,输出64)→pool1(2×2/stride2)→conv2(3×3/stride1,输出128)→pool2(2×2/stride2)→conv3/4(3×3/stride1,输出256)→pool3(2×1非对称池化)→conv5/6(3×3/stride1,输出512)→pool4(2×1非对称池化)→conv7(2×2/stride1,输出512)。pool3、pool4采用2×1非对称池化窗口,仅压缩高度维度、保留宽度维度,以保留文字序列水平方向的位置信息。
14、cnn输出的1×80×512特征图按宽度方向切分为80个时间步的特征序列,送入2层双向lstm(隐藏单元数256),经全连接层映射至字符类别数(约6000类),通过ctc损失与解码实现不定长文本端到端识别。
15、(3)账务推理分支(全连接决策网络)
16、输入特征由四部分拼接而成,共227维:业务摘要文本经预训练词向量编码并池化后的语义特征(128维)、金额/税率/数量等数值特征(20维,经z-score标准化)、单据类型one-hot编码(15维)、往来单位历史交易统计embedding(64维)。
17、网络结构:fc1(227→512,relu,dropout p=0.3)→fc2(512→256,relu,dropoutp=0.3)→fc3(256→128,relu)→分类头fc-cls(128→n≈800,softmax,标签平滑0.1)及回归头fc-reg(128→2,线性)。
18、在fc2层之前引入分组软注意力机制:将227维输入特征按语义来源分为4组,各组经组内线性映射统一为64维隐向量后计算注意力权重并加权融合,得到256维融合特征输入fc2层。
19、3. 模型训练
20、训练采用多任务联合损失:l_total = λ1·l_cls + λ2·l_reg + λ3·l_det,其中λ1=1.0,λ2=0.5,λ3=0.3。l_cls为含标签平滑(ε=0.1)的多分类交叉熵损失;l_reg为smooth l1损失;l_det由focal loss与iou loss加权构成(权重比1:1)。
21、优化器采用adam,初始学习率1e-3(预训练阶段)或5e-4(账务推理分支训练阶段),每迭代10轮学习率衰减0.1,总迭代轮次120~150轮,批量样本数batch_size=64。采用迁移学习初始化,导入预训练权重。训练数据包括增值税专/普票、银行回单、工资表、社保单据、费用报销单、100+行业标准会计分录,样本总量≥50万条,按训练集80%、验证集15%、测试集5%划分。
22、4. 双层智能校验闭环机制
23、采用双重校验机制同步运行:
24、规则层校验:内置现行企业会计准则、增值税、个税、社保法规静态规则库,校验借贷平衡、税率匹配、费用扣除限额等基础逻辑错误,输出具体触发的规则库条款编号及条款内容摘要。
25、ai深度学习比对校验:复用账务推理分支模型,二次比对原始单据业务内容与生成分录的匹配度,输出置信度评分(默认阈值90%)。置信度低于阈值时输出具体原因说明(如“税率与所属行业历史适用税率区间不符”)。
26、校验完成后自动分流:双层校验全部通过、置信度达标的账务标记为合规账务,流转至自动开票报税流程;规则冲突或置信度不足的账务标记为异常账务,推送人工复核。
27、5. 全链路自动化业务执行
28、算力主板读取校验通过的合规账务数据,按固定业务时序下发操作指令,多软件自动操控驱动模块模拟人工键鼠操作:
29、(1)自动登录增值税开票软件,批量开具电子发票;
30、(2)自动登录社保、公积金线上申报系统,完成员工增减员、缴费基数调整;
31、(3)自动登录电子税务局,填写申报表并完成一键申报;
32、(4)全部业务回执自动归档存储。
33、6. 人机交互迭代学习机制
34、采集人工修正的异常账务数据,系统自动封装三元组样本:“原始ocr识别错误字段/初始错误分录+人工修正后标准字段/正确分录+业务元数据标签”。
35、每日凌晨ai芯片启动样本预处理:过滤无效样本(单纯人为录入失误、重复样本、临时一次性特殊业务),通过文本相似度比对去重,按“行业+单据类型+异常类型”多维分组进行语义聚类,提炼标准化财税规则。
36、聚类生成的规则采用追加写入模式更新财税知识库,同步将标注样本推送至增量训练数据集。夜间低负载时段执行模型增量微调训练(迭代10~20轮,学习率0.0001),优化后的新模型回写固态存储覆盖旧模型。
37、7. 四层可解释性技术架构
38、输入溯源层:每条结构化字段记录保留原始票据图像文件路径及字段在图像中的坐标定位信息,实现“分录—字段—原始票据”三级映射。
39、决策依据层:规则校验部分输出具体触发的规则库条款编号及条款内容摘要;ai推理部分输出top-3候选会计科目及各自置信度得分,并通过分组软注意力机制输出的四组注意力权重(业务摘要/金额税率/单据类型/往来单位)以横向条形图展示各项对本次科目判断的贡献占比。
40、相似案例层:基于历史行业分录样本库,为每条ai生成分录检索并展示语义最相似的若干条历史真实做账案例(脱敏后)。
41、结果说明层:按固定模板自动生成自然语言“账务处理说明”,汇总前述三层信息为会计可直接阅读的说明文本。
42、8. 数据安全与隐私保护
43、采用本地化部署为主、分级授权云同步为辅的总体架构。数据分级分类管理:一级(高敏感)包括纳税人识别号、银行账号等,默认不参与云端同步;二级(中敏感)包括交易金额、往来单位名称等;三级(低敏感)为脱敏后的统计特征数据。本地存储采用aes-256对称加密,密钥由独立密钥管理单元生成并分片存储。网络通信采用tls 1.3加密通道,跨工作站同步采用双向证书认证。本地操作采用账号密码加动态验证码的双因素认证,划分管理员与普通操作员两级权限。系统按“企业编码”建立独立存储分区,实现多租户物理及逻辑隔离。所有关键操作自动生成不可篡改的审计日志,保存周期不少于12个月。
44、与现有技术相比,本发明具有以下有益效果:
45、1.账务处理效率大幅提升:单台ggai工作站每月可处理160-200套一般纳税人账务,较传统人工模式(80-100套)产能提升约100%,较业务系统对接类方案(120-150套)提升约30%-60%;设备可7×24小时不间断工作。
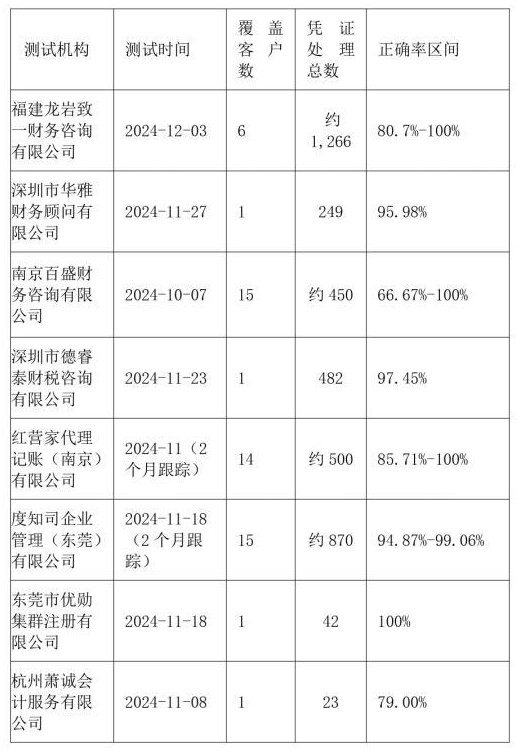
46、2.账务准确率显著提高:经3个月人机迭代学习后账务校验中位数正确率达94.5%,较传统人工模式(85%-90%)提升约5-9个百分点;3个月运行期合规异常发生率低于0.5%,显著低于传统人工模式(3%-5%)。
47、3.实现代账全链路闭环自动化:本发明从客户沟通、票据归集、开票、社保调整到纳税申报全链路闭环自动化,全业务链路覆盖率达100%,而现有自动化方案覆盖率不足40%。
48、4.业内首创软硬一体代账自动化方案:现有技术均为纯软件方案,无适配代账场景的定制ai芯片专用硬件。本发明ggai专用ai工作站+深度学习闭环做账校验的软硬结合方案,技术新颖性突出。
49、5.具备自主进化能力:依托人机交互迭代学习机制,设备使用时间越长、积累行业账务案例越多,做账判断与校验精准度持续提升。
50、6.模型决策可解释:四层可解释性架构实现从原始单据到最终会计分录的全链路可追溯与人类可读的决策依据输出,满足财税场景对“账务处理依据可追溯、可解释”的强合规要求。
51、7.部署便捷、通用性强:ggai工作站采用即插即用设计,无需复杂服务器部署、二次开发,可自动适配市面上主流财务软件、开票系统、社保、电子税务局平台。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com