
一种视障辅助场景的轻量级图像描述生成方法及系统
本发明涉及计算机视觉、多模态自然语言处理以及多智能体协作,具体涉及一种视障辅助场景下的轻量级图像描述生成方法及系统。
背景技术:
1、随着计算机视觉(computer vision)与自然语言处理(natural languageprocessing)技术的飞速发展,图像描述生成(image captioning)技术取得了显著进步,已成为辅助视障人士感知外界环境、提升生活质量的核心技术。通过将复杂的视觉场景转化为实时语音描述,视障人士能够更精准地获取物体类别、空间位置以及文字信息。
2、然而,在实际的视障辅助应用场景中,现有的图像描述生成技术仍面临诸多严峻挑战。首先,视障用户通过手持设备或智能眼镜采集的图像质量往往不可控,常伴随严重的物体遮挡、边缘模糊或异常倾斜等现象。传统基于全局特征提取的模型,如标准vit结构(dosovitskiy a, beyer l, kolesnikov s, et al. an image is worth 16x16 words:transformers for image recognition at scale[j]. arxiv preprint arxiv:2010.11929, 2020.)在处理低质量图像时易丢失关键的细粒度信息,导致生成的描述内容存在语义缺失。
3、其次,现有的主流大模型具有庞大的参数量和密集的计算开销,难以在资源受限的边缘终端如智能辅助眼镜、移动便携设备上实现低功耗、低延迟的实时推断。现有的轻量化方案虽然降低了参数规模,但在面对复杂多变的视障辅助场景时,往往表现出语义理解力不足的缺陷(ramos r, elliott d, kageura k. smallcap: lightweight imagecaptioning with retrieval augmentation[c] // proceedings of the ieee/cvfconference on computer vision and pattern recognition. 2023: 11020-11030.)。
4、此外,现有的辅助系统多采用单体式架构,并缺乏对多步复杂任务的逻辑规划。在多智能体协作过程中,如何保证任务状态的持久化、避免会话摘要压缩导致的上下文丢失,以及实现高效的智能体间异步通信仍是需要解决的难题。
技术实现思路
1、本发明的目的在于克服现有技术的缺点,提供一种视障辅助场景的轻量级图像描述生成方法及系统。该方法与现有技术相比,能够在保证端侧设备低算力消耗的前提下,显著提升对复杂场景及低质量图像描述的准确性。并引入多智能体协作架构与持久化任务图机制,将复杂指令拆解为原子化任务并通过json文件进行状态维护。在模型方面,采用多尺度特征提取和检索增强技术,增加图文对比损失,并通过冻结视觉与语言骨干网络,仅微调轻量化跨注意力层,实现了模型的高效部署,更适用于实际移动辅助场景。
2、本发明的目的通过以下技术方案实现。
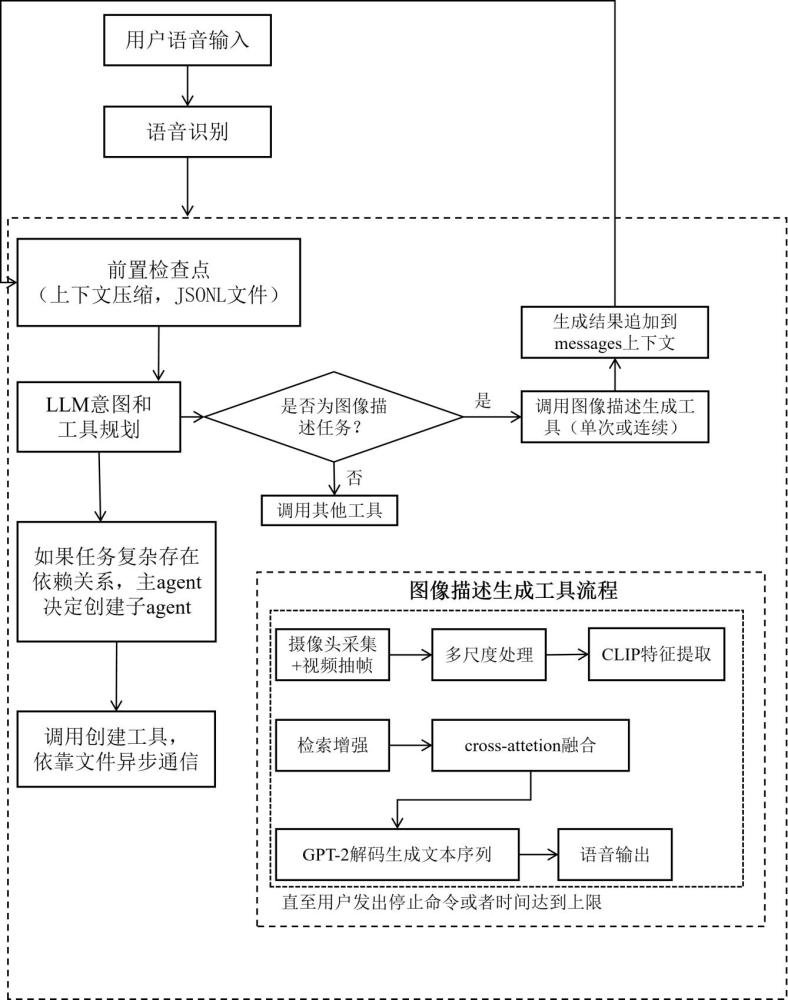
3、一种视障辅助场景的轻量级图像描述生成方法,包括以下步骤:
4、(1)大语言模型根据智能体识别的用户意图调用不同的图像描述生成工具,以采集当前摄像头画面图像;
5、(2)对采集到的图像进行多尺度划分,生成多尺度图像;
6、(3)利用预训练的clip视觉编码器对各尺度图像进行特征提取,得到多尺度视觉特征序列;从数据库中通过图像-文本检索方式,针对各尺度图像子区域分别检索出多条最相似的描述文本,按照提示模板组织成文本特征序列,用于提供上下文语义引导;
7、(4)将视觉特征序列与文本特征序列分别映射到统一的语义嵌入空间,通过可训练的多头跨注意力模块进行跨模态信息对齐融合,得到融合后的多模态表示;
8、将融合后的多模态表示输入到解码器中,采用自回归生成方式逐步生成完整的图像描述文本序列;
9、(5)将图像描述文本序列转换为语音,通过语音输出模块输出给用户。
10、进一步地,步骤(3)的特征提取过程包括:
11、利用多尺度算子对输入图像进行多尺度结构化处理,构建多尺度子区域集合,并且所有尺度视图均缩放至统一的空间维度;
12、将图像输入至预训练的clip视觉编码器执行特征提取:对于任一尺度图像,首先执行图像分块操作,将图像划分为统一尺寸的非堆叠图像块,并展平为分块序列;通过线性映射矩阵将每个图像块投影至d维嵌入空间,在patch序列前面拼接一个可学习的分类token,并叠加位置编码以保留空间位置信息,得到初始输入序列;初始输入序列依次通过12层transformer编码结构,提取各尺度编码输出序列中的完整序列特征,并在序列维度上拼接得到统一的多尺度视觉特征序列。
13、进一步地,图像-文本检索过程包括:
14、针对提取到的多尺度视觉特征序列中的每个尺度子区域特征,分别计算其与构建的描述文本向量库中所有文本嵌入的余弦相似度,并利用线性投影矩阵获得图像的统一语义向量;
15、根据余弦相似度分数,对每个尺度子区域独立检索出最相似的描述文本,将所有检索到的描述文本按照提示模板生成序列,其中,不同尺度的检索结果按原始图像、五裁剪、九裁剪的顺序依次填充,形成包含丰富上下文信息的多尺度任务序列即文本特征序列,作为后续解码器的输入前缀,最终构造的检索前缀与多尺度视觉特征序列一同输入至跨模态解码模块。
16、进一步地,步骤(4)包括:
17、将多尺度任务序列作为gpt-2解码器的输入前缀,其中多尺度任务序列包含从不同尺度图像视图中检索到的描述文本示例;
18、在gpt-2解码器的每一个transformer解码层中,单独插入一组可训练的多头跨注意力模块,作为视觉特征与文本特征的关键融合机制;多头跨注意力模块在不同子空间中并行计算不同类型的视觉-文本对齐关系,最后拼接融合后得到多模态表示。
19、进一步地,多头跨注意力模块的具体结构和计算过程如下:
20、将多尺度视觉特征序列作为k和v,将当前gpt-2解码器处理多尺度任务序列后得到的隐藏状态作为q,公式为:
21、
22、其中,表示单个注意力头的特征维度。
23、进一步地,融合后的多模态表示与当前gpt-2解码器的文本隐藏状态进行残差连接,随后经过归一化处理,再输入到gpt-2解码器原有的自注意力层和前馈神经网络中继续进行文本序列建模;
24、gpt-2解码器采用自回归方式逐token预测下一个词的概率分布,具体计算公式为:
25、
26、其中,为第个生成的token,第个token之前的已生成token序列,为前个token经过跨注意力机制融合后的隐藏状态,为多尺度视觉特征序列,为多尺度任务序列。
27、实现所述的一种视障辅助场景的轻量级图像描述生成方法的系统,包括:
28、语音输入模块,用于采用采集音频信号;
29、语音输出模块,用于自然语言回复用户;
30、图像描述生成模块,用于通过多尺度构造算子对图像进行结构化处理,生成不同尺度视图的多尺度子区域集合;
31、跨模态交互模块,用于将多尺度视觉特征序列与多尺度任务序列机进行融合。
32、进一步地,所述语音输入模块支持语音唤醒功能,并在识别过程中加入置信度过滤机制,仅当识别置信度高于设定阈值时才将文本传递给后续意图解析模块,否则请求用户重复指令。
33、本发明的一种计算机设备,包括存储器和处理器,所述存储器与处理器电性连接,所述存储器存储有计算机程序,所述计算机程序被所述处理器执行时,使得所述处理器实现所述的方法。
34、本发明的一种计算机可读存储介质,所述计算机可读存储介质存储有计算机程序,所述计算机程序被处理器执行时,所述处理器实现所述的方法。
35、与现有技术相比,本发明的有益效果在于:
36、1、本发明针对长任务会话问题引入了基于持久化任务图的多智能体协作机制。通过主智能体对指令进行意图分析并调用工具可以创建多个子智能体,并利用目录级文件锁与jsonl文件实现异步通信。相较于传统的单智能体和纯内存态任务清单,本发明能够有效防止因会话上下文压缩导致的指令状态丢失,确保了复杂、多步骤辅助任务的可靠执行。
37、2、本发明在图像特征提取部分采用了多尺度并行视觉建模与检索增强策略。在clip视觉编码器基础上,通过全局、五裁剪及九裁剪构造15个尺度视图,确保模型在图像模糊或对焦不准的情况下仍能捕捉到细粒度的局部特征。同时,利用视觉特征在外部文本库中检索相似描述作为提示前缀,为轻量化语言模型提供了强有力的语义先验,降低了幻觉的发生。
38、3、本发明实现了高效的轻量化部署方案。通过完全冻结clip-vit-b/16视觉编码器和gpt-2语言解码器的主干参数,仅针对约20m参数量的跨注意力融合层进行训练,大幅压缩了训练成本与推理时延。该系统在边缘终端上可实现毫秒级的端到端响应,完美适配智能辅助眼镜等移动端设备。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com