
一种基于内生智能混合式架构的杀伤网动态重构方法
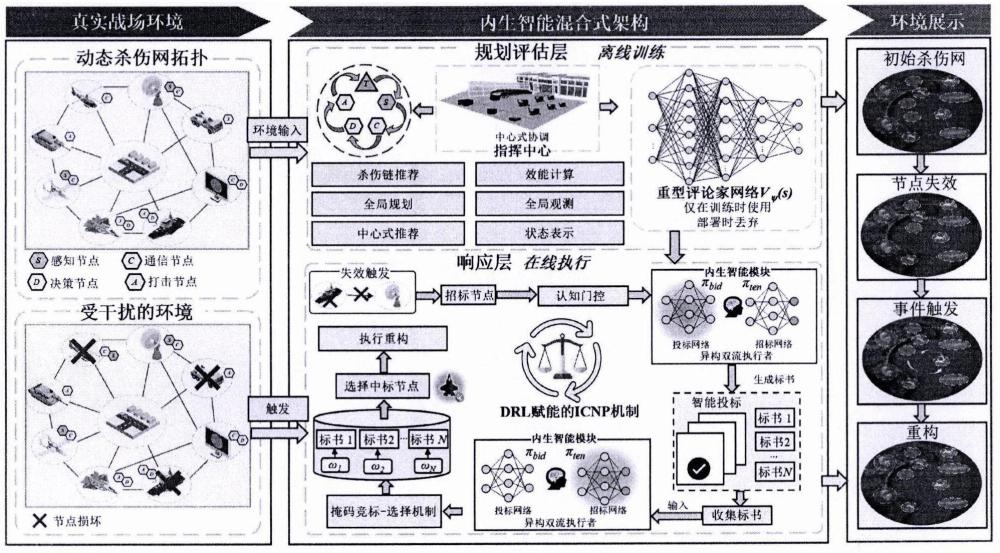
本发明属于多域协同作战体系动态重构、多智能体深度强化学习与无人作战集群智能指挥控制交叉,特别涉及基于内生智能混合式架构的杀伤网动态重构方法。
背景技术:
1、近年来,现代作战形态正由以平台为中心的传统线性杀伤链向以多域协同与动态弹性为本质特征的杀伤网转型。在“马赛克战"思想推动下,杀伤网通过将异构传感器、决策器与攻击器整合为弹性资源池,借助动态链接形成系统级韧性,能够在节点遭受动能打击或电子干扰失效时自适应地重构运行环路,从而维系闭环作战能力。然而,杀伤网范式对指挥与控制系统提出了前所未有的双重要求:其一为全局最优性,要求在非平稳干扰与节点损耗条件下对异构感知、决策与攻击资源进行联合编排;其二为分布式毫秒级敏捷性,要求在目标暴露窗口的毫秒-秒级时间尺度内完成可替代回路的重构。
2、现有杀伤网重构架构无法同时满足上述两类要求。集中式优化方法以全局最优解为目标,借助蚁群算法、多目标进化算法或非支配排序差分进化等启发式技术生成最优杀伤链蓝图,但其求解时间通常在秒-分钟量级,超出毫秒级重构窗口三至四个数量级,存在不可逾越的时间预算鸿沟。分布式机制以经典的合同网协议(contract net protocol,cnp)及其改进版本(improved contract net protocol,icnp)为代表,依托节点间局部协商实现毫秒级敏捷响应,对单点失效具有较强鲁棒性;然而受限于人工设计的启发式投标规则,icnp无法将非平稳的全局战场态势内化为本地决策依据,存在严重的“战术短视”问题,易陷入次优收敛与资源争用,难以保证大规模重构下的全局协同。
3、近年来,深度强化学习(deep reinforcement learning,drl)及其多智能体扩展(multi-agent deep reinforcement learning,madrl),特别是基于集中式训练分布式执行(centralized training with decentralized execution,ctde)范式的多智能体近端策略优化(multi-agent proximal policy optimization,mappo)算法、异构智能体近端策略优化(heterogeneous-agent proximal policy optimization,happo)算法、多智能体深度确定性策略梯度(multi-agent deep deterministic policy gradient,maddpg)算法、柔性演员-评论家(soft actor-critic,sac)算法等,为分布式智能决策提供了新思路。然而,将上述算法直接应用于杀伤网动态重构仍存在三重瓶颈:第一,杀伤网重构具有典型的混合异构动作空间——招标方执行离散选择,而投标方执行连续投标,标准mappo/maddpg所基于的同构动作假设结构性失效;第二,标量化的全局奖励在异构投标-招标耦合任务下无法解耦各方贡献,存在严重的信用分配难题;第三,分布式智能体在节点失效后被动响应,缺乏主动认知与可扩展性,难以在大规模杀伤网中保持毫秒级响应。
4、因此,迫切需要一种能够同时兼顾“全局最优”与“毫秒级敏捷”,能够将集中训练所形成的全局战术智慧内化进分布式边缘节点策略参数中的杀伤网动态重构方法。
技术实现思路
1、本发明针对上述背景技术中的关键瓶颈,提出一种基于内生智能混合式架构的杀伤网动态重构方法,旨在结构性地解耦“全局最优规划"与“毫秒级分布式响应”两类预算不可兼容的目标,并以异构交互流形多智能体近端策略优化(heterogeneous interactionmanifold multi-agent proximal policy optimization,him-mappo)算法将全局训练智慧内化为边缘策略参数,从而在严苛电磁干扰与高强度节点损耗条件下显著提升杀伤网的重构成功率与作战韧性。为实现上述目的,本发明所采用的步骤是:
2、步骤1:构建杀伤网动态重构问题的系统模型,包括用时变图描述的杀伤网拓扑模型、考虑大尺度路径损耗、nakagami-m小尺度衰落和电磁干扰的随机链路质量模型、以及综合路径可靠性和任务时效性的运行环路效能评估模型
3、步骤2:将杀伤网动态重构问题建模为异构去中心化部分可观马尔可夫决策过程(heterogeneous decentralized partially observable markov decision process,hetero-dec-pomdp),定义异构智能体的招标方与投标方的角色映射机制、与角色对应的局部观测空间、由连续投标动作和离散招标动作组成的混合层次化动作空间以及基于“参与渴望度”的认知门控机制;
4、步骤3:设计多目标复合奖励函数,包括以闭环效能为主项的效能恢复奖励、以剩余资源香农熵为目标的资源平衡奖励、以总闭环时延ttotal为惩罚的时效性惩罚和满足硬性约束的有效性奖励cvalid四个组成部分的线性加权耦合;
5、步骤4:构建内生智能混合架构(endogenous intelligence hybridarchitecture,eiha),架构由“规划-评估层”和“响应层”组成,其中规划-评估层在离线训练时担任集中式评论家、在部署后即弃用,响应层由配备内生智能模块的边缘节点组成;并提出him-mappo算法,算法采用联合信息融合的“重型评论家”网络与异构双流actor网络相配合,其中投标actor输出参数化beta分布的连续动作、招标actor输出经动态意图掩码重归一化的categorical分布动作;以“集中式训练,分布式执行”方式完成对策略网络的训练,将全局战术智慧固化于响应层各节点的策略参数中。
6、进一步,构建杀伤网动态重构问题的系统模型的具体方法为:
7、将杀伤网形式化为时变图节点集包含所有友方单元和敌方目标,每个节点vi由全息6元组ξi刻画其角色、位置、速度、物理属性、剩余信道容量和处理时延,定义为:
8、
9、其中ψi∈{s,c,d,a,t}表示功能角色类型,传感器为s、通信为c、决策为d、打击为a、目标为t;与为3维位置坐标和速度矢量;ki包含感知半径rsen和打击半径rstr等物理属性;为感知、通信、决策、打击四类信道剩余容量矢量;τi为节点内部处理时延;
10、链路eij的信息传输质量qinfo(eij)由瞬时信干噪比定义为:
11、
12、其中pt,i为节点i的发射功率,gij为链路eij的收发天线增益,dij为节点i与节点j之间的距离,l(·)为路径损耗函数;其中hij为链路eij的小尺度衰落信道系数,服从nakagami-m分布,路径损耗指数α按角色区分,其中探测链路s→t为双程雷达衰减取α=4,通信指挥链路s→c→d→a为单向传播取α=2,为干扰源集合,ik,j为干扰功率,σ2为高斯白噪声功率,γth为解调门限;进一步以香农容量描述链路信息携带能力:
13、c(eij)=bij·log2(1+sinrij) (3)
14、其中bij为分配带宽,sinrij为链路eij的瞬时信干噪比;
15、打击链路a→t的效能由能力对比的概率模型刻画:
16、
17、其中和ddef分别表示攻击方的打击能力和目标的防御强度,为指示函数;
18、电磁干扰造成的链路质量退化建模为:
19、
20、其中为第k个干扰源的球形抑制区,半径为rjam;
21、节点失效区分为硬失效与软失效。硬失效采用贝叶斯协同感知后验概率判定,设di为节点vi物理摧毁事件、为连续k次心跳缺失事件,则:
22、
23、其中为基于运动学链路过期时间推得的链路持续概率,δt为相邻两次心跳之间的时间间隔,令δconf为硬失效判决的置信度阈值,当时方触发重构;软失效定义为节点物理完整但内部资源耗尽:
24、
25、其中m为信道类型索引,为节点第m类信道的资源耗尽判决阈值;
26、运行环路的综合效能由路径可靠性与任务敏捷性的乘积定义:
27、
28、
29、其中为目标战术价值,为环路端到端总时延,τv与τe分别为节点v的内部处理时延与链路e的传输时延,tmax为目标暴露窗口,δ为时延灵敏度系数;erel体现“最薄弱链路”特性,etime以双曲正切衰减惩罚超时,并以最小割原则定义环路瓶颈吞吐θ与对所有活跃运行环路求和的系统级聚合吞吐θagg:
30、
31、进一步,将杀伤网动态重构问题建模为hetero-dec-pomdp的具体方法为:
32、将动态重构问题建模为由七元组定义的hetero-dec-pomdp,其中为作战节点集合,其余元素依次为全局状态空间、联合观测空间、联合动作空间、状态转移概率函数、奖励函数与折扣因子γ。在每个重构步,icnp机制根据感知到的失效事件动态地将每个智能体分配为以下两种角色之一:检测到失效并执行离散裁决的招标方tenderer(i∈nten),或基于内部状态生成连续投标的投标方bidder(j∈nbid);
33、(1)状态与角色专属观测空间:
34、全局状态st囊括动态图拓扑、电磁干扰场分布以及失效环路的功能需求,定义为:
35、
36、执行阶段st对去中心化智能体不可见,但在训练阶段为重型评论家构建全局价值基线提供关键信息基础;
37、投标方节点j的局部观测向量构造为:
38、
39、其中,dbid表示投标方局部观测向量的维度,该局部观测向量聚合内部剩余资源状态cj(t)、与招标方的相对链路质量以及局部拓扑嵌入;招标方节点i的局部观测向量在投标方观测的基础上扩展,定义为:
40、
41、其中,dten表示招标方局部观测向量的维度,招标方节点的局部观测中包含目标战术价值和待处理任务的具体资源需求;
42、(2)混合分层动作空间:混合分层动作空间在结构上将决策过程解耦为“能力投影”和“最优选择”阶段。在投标者流中,策略πbid将局部观测映射到连续动作向量uj,t∈[0,1]3,为了确保资源承诺的有界性并促进稳定的梯度流,使用beta分布对投标策略进行参数化:
43、
44、其中αθ和βθ表示投标者网络输出的集中度参数。该向量潜在地编码了三个关键维度:参与意愿αj、资源分配βj和战术成本γj。
45、(3)认知门控机制:为了将这些连续信号与离散协议逻辑衔接,引入了认知门控机制来生成动态意向掩码mt∈{0,1}n,其中
46、门控阈值δth在训练过程中按线性退火策略从0.1过渡到0.5,先广泛探索候选池再逐渐聚焦高置信度投标方;该机制在源头滤除无意愿或无能力节点,将原本np-hard的搜索空间剪枝为可管理子集,从而保证毫秒级响应。
47、进一步,设计多目标复合奖励函数的具体方法为:
48、为了引导去中心化智能体迈向权衡任务效能、负载分布和响应能力的帕累托最优前沿,制定一个由四个加权目标组成的标量全局奖励函数rt(s,a):
49、
50、其中ξ、λ1与λ2分别为效能恢复项、资源熵项与时效性惩罚项的权重系数;主要部分激励重构后新运行环路闭环效能的恢复。该目标由资源熵项平衡,该项使获胜节点的残余资源分布的香农熵最大化,以防止特定通道耗尽并促进长期负载均衡。此外,时效性惩罚项最小化了相对于目标暴露窗口的总闭环延迟ttotal,驱动选择拓扑邻近且计算性能优越的节点,而固定的有效性奖励保证了硬物理约束的满足。
51、进一步,构建内生智能混合式架构eiha与him-mappo算法的具体方法为:
52、内生智能混合架构eiha结构性地解耦指挥层级为两个协同层:
53、(1)规划-评估层:驻留于指挥中心,承担两类生命周期功能。在交战前,分析初始全局态势使用全局优化方法生成最优初始运行环路并初始化杀伤网拓扑;在离线训练阶段,转化为ctde范式中的中央评论家,引导分布式边缘节点学习与全局对齐的协同策略;该层在部署执行阶段被丢弃;
54、(2)响应层:由配备轻量级“内生智能模块”的异构作战节点组成,节点之间通过“事件触发协商”闭环交互,分为重构招标、智能投标和中标决策三个阶段,整个闭环决策过程在毫秒级完成;
55、him-mappo算法实现eiha的离线集中训练过程,由以下三类网络组成:
56、(1)联合信息融合重型评论家网络vψ:作为全知监督者,将全局状态st和联合观测拼接为融合态势向量zt,定义为:
57、zt=[st,o1,t,...,on,t] (17)
58、zt经隐层维度1024-512-256的多层感知器处理后输出全局价值估计vψ(zt);评论家以广义优势估计(generalized advantage estimation,gae)方法估计的回报为目标,最小化均方误差损失:
59、
60、其中b表示小批量大小。这种架构设计确保了评论家能够通过捕捉局部重构动作对全系统的影响,为分布式执行器提供精确的价值指导。评论家的非对称结构以全局-局部知识蒸馏的方式将全局拓扑依赖反向传播至去中心化actor,将本地节点在执行时不可见的角色间协同关系内化为“内生直觉”,从而结构性地解决耦合奖励下信用分配难题;
61、(2)投标方actor网络采用多层感知器,输入维度db→512→256→256,消费投标方局部观测输出beta分布浓度参数进而采样三维连续投标动作向量uj,t∈[0,1]3,按上述beta分布参数化方式采样;
62、(3)招标方actor网络采用多层感知器,消费招标方观测与投标动作的拼接向量其中bt为所有bidder投标动作的拼接,输出经掩码mt重归一化后的categoricallogits,进而采样离散选择动作ai,t:
63、
64、其中ε为防止分母为零的数值稳定常数;两个actor网络的参数集θb与θt严格不重叠、独立优化,避免因共享底层骨干而产生的梯度干扰;尽管参数解耦,二者共享同一任务级奖励rt以及由重型评论家估计的gae优势作为统一的优化信号;
65、训练采用“集中式训练,分布式执行”。每幕循环ktr轮、每轮ttr步、每次更新jppo个训练轮次;每步先由所有bidder生成投标动作并构造意图掩码mt,再由tenderer采样离散选择动作,与环境交互获得奖励rt后存入经验缓冲区,每隔若干步触发一次更新;
66、部署阶段,重型评论家被完全丢弃,每个边缘节点仅保留对应bidder actor或tenderer actor用于实时决策,将训练阶段获得的“全局战术智慧”以策略参数形式固化于网络权重中,实现“离线集中训练,在线分布执行,部署时凭借参数中蕴含的内生智能完成毫秒级动态重构”。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com