
基于LSTM-XGB动态集成的沼气产量预测方法
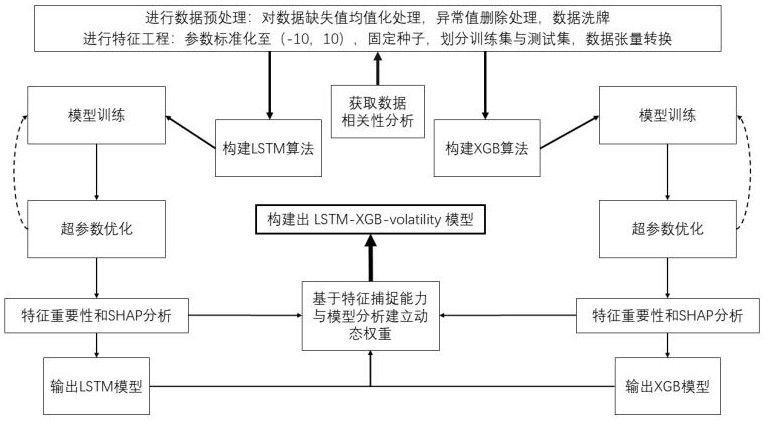
本发明属于沼气工程,涉及一种基于lstm-xgb(lstm-xgboost-volatility)动态集成的沼气产量预测方法。
背景技术:
1、当前全球能源向可再生能源转型,生物质能源依托资源循环与低碳优势快速发展,厌氧消化及沼气生产成为构建可持续能源体系的关键,全球已有超1.3万个沼气池运行。沼气工程兼具废物处理、减碳及生态保护价值,开展沼气预测是精准预测沼气产量、为工程运行调控提供支撑,优化工艺参数以提升中大型工程技术效率;通过可靠预测能助力产能规划与资源调配,保障沼气能源稳定输出,适配政策与循环经济需求,推动产业潜力释放,为能源转型与“双碳”目标提供保障。
2、厌氧消化反应是沼气生产的核心,厌氧微生物通过水解、酸化、产乙酸、产甲烷等一系列复杂的生化反应,将有机物转化为沼气。多种生化反应交织、微生物相互作用使得厌氧消化反应具有高度非线性与动态性,传统物理数学公式难以精准描述该过程,进而无法可靠预测沼气产量。利用机器学习,通过神经网络算法,能够有效捕捉复杂系统中的非线性关系与动态变化规律,可突破传统方法的局限,实现对沼气产量的精准预测,然而,厌氧消化过程高度复杂,使得现有的预测方法,如单一的lstm模型或固定权重的集成模型,在应对进料成分变化、环境温度突变等引起的工况波动时,预测性能显著下降。具体表现为:lstm模型对突发性波动的响应过于平滑,而静态集成模型无法根据数据特征自适应调整,导致其对复杂动态系统的预测精度和抗干扰能力均显不足。如何让预测模型在“平稳期”和“剧烈波动期”均保持高精度,是当前急需解决的技术瓶颈。
技术实现思路
1、为了克服现有预测模型在沼气发酵系统面临极端工况波动时预测精度显著下降的缺陷,本发明的目的是提供一种基于lstm-xgb动态集成的沼气产量预测方法。该方法引入实时数据波动度作为模型切换的决策信号,实现不同算法间的动态权重分配。
2、长短期记忆网络(long short-term memory,lstm)核心是在循环神经网络基础上新增“记忆单元”与“输入门、遗忘门、输出门”,通过门控结构自主筛选时序数据中的关键长期信息、剔除冗余内容,彻底突破长序列依赖瓶颈。极端梯度提升(extreme gradientboosting,xgb)算法是在梯度提升决策树基础上优化而来,解决梯度提升决策树在预测精度与计算效率上的不足。同时加入l1、l2正则化及树剪枝抑制过拟合,支持并行计算提高训练效率,还能自动处理缺失值降低数据预处理难度。shap分析(shapley additiveexplanations)与特征重要性是机器学习模型可解释性的核心工具,能有效解决模型“黑箱”问题。从不同维度揭示特征与模型输出的关联,帮助优化模型,是动态融合两种模型的依据,也让决策过程更可信。本发明核心构思在于:引入一个实时数据波动度指标作为模型切换的决策信号,从而构建一个能够自适应工况变化的动态权重集成模型。该模型不再是简单的模型叠加,而是一个具备自我判断和调整能力的智能预测系统。本发明根据沼气产量的变化,划分为平稳与波动状态根据两种状态,两种算法的权重不同(lstm/xgb),通过shap分析,内在映射的就是对温度这一参数的权重改变。灵活应用两种算法集成,增加预测精度。
3、本发明提供了一种基于lstm-xgb动态集成的沼气产量预测方法,步骤如下:
4、(1)收集与厌氧消化相关的数据,进行相关性分析,记为特征参数(包括温度、水、原料、能耗、总碱度、挥发性脂肪酸、气体甲烷含量、沼渣、沼液),对其数据进行预处理;
5、预处理包括:对异常值的剔除,缺失值的前后均值填补;
6、(2)通过网格搜索,确定特征参数最佳区间,标准化至(-10,10),将数据集按照300:80的比例随机划分成训练集与测试集,设置固定种子,保证算法可复现;
7、(3)建立lstm算法,建立输入层,隐藏层,输出层,学习率,选取adam优化器,定义损失函数为mse,加入过拟合机制,对设定参数进行超参数优化。
8、lstm算法输入门表示:
9、
10、lstm算法遗忘门表示:
11、
12、lstm算法输出门表示:
13、
14、式中,ht−1:上一时刻隐藏层;xt:特征参数;wxi,wxf,wxo:权重参数;bi,bf,bo:偏差参数;it 代表lstm模型输入门,ft 代表lstm模型遗忘门,ot 代表lstm模型输出门。
15、在本发明中,lstm模型输入门it的特征输入向量 xt 为一个9维向量,具体表示为xt= [x1, x2, x3, x4, x5, x6, x7, x8, x9],其中,x1 为温度归一化值、x2 为tac归一化值、x3 为vfa归一化值……以此类推。模型通过权重矩阵 wx 为这9个物理特征分配不同的网络权重,进而计算出输入门 it 的状态。同理,遗忘门ft则通过所述公式删除数据变化中的过时信息;最终由输出门ot表述出预测结果。权重系数由输入的特征参数决策,不为固定值。
16、(4)建立xgb算法,设置xgb树的数量,最大深度,学习率,随机采样比例,最小分裂增益,正则化l1、l2,l1、l2代表系数,对xgb加入了正则化约束,l1实现特征筛选、简化模型,l2平滑权重、稳定训练,解决了 l1单独使用时的震荡问题,也弥补了l2单独使用时无法特征选择的短板。
17、xgb算法表述为:
18、
19、xgb算法的l1正则化表述为:
20、
21、xgb算法的l2正则化表述为:
22、
23、式中:γ、α、λ是 xgboost 算法中的正则化惩罚系数,γ为叶子节点分裂的最小损失下降值;α为l1正则化惩罚系数;λ为l2正则化惩罚系数,用于控制模型复杂度并防止过拟合;t:当前第k颗树叶子总量;ωj:第j片叶子权重;模型迭代训练时,加入早停机制,监控测试集性能,当测试集性能连续多轮不再提升(甚至下降)时,自动停止训练,保留此时性能最优的模型参数。
24、(5)对lstm算法和xgb算法进行特征重要性解释和shap(shapley additiveexplanations)分析,选择合适动态权重。
25、设置波动度,依据数据波动强烈程度,对两种算法选择不同权重。
26、波动度表述为:
27、
28、
29、式中:σ:标准差;xi:第i点处数据;x:数据平均值;υ:波动度(volatility)
30、波动度不直接参与最终数值的计算,它作为权重转换的判定依据(即系统软开关)。它通过将当前工况的波动度与设定阈值(0.5)进行比对,来判定系统当前是处于平稳期还是极端工况导致的波动期。其影响在于:根据判定结果动态改变分配给 lstm 和 xgb两个基模型的权重(wlstm和wxgb),从而直接改变最终结合得出的沼气产量预测值yfinal。
31、波动度仅作为动态权重分配的中间判定条件。最终的沼气产量预测值 yfinal 通过以下加权公式得出:
32、yfinal = wlstm*ylstm + wxgb*yxgb
33、yfinal就是当前时刻的沼气产量综合预测值。本发明所有的多维数据采集、模型独立训练、波动度计算及权重动态分配,最终目的都是为了输出该高精度的预测值,以此为沼气工程前馈调控提供决策支持。
34、将当前采集的多维特征数据同时输入lstm和xgb基模型,得到 ylstm 和 yxgb。系统输出最终预测值:yfinal = wlstm*ylstm + wxgb*yxgb。
35、wlstm 和 wxgb这两个权重系数是在实际应用中根据‘实时数据波动度指标’动态分配的。当 v>0.5 时,wxgb取0.7,wlstm取0.3;当系统处于平稳状态时,由 lstm 占主导权重。这些具体权重数值(如0.7、0.3、0.95、0.05)的最初来源,是在模型训练阶段,通过网格搜索法(步长为0.05),以均方根误差(rmse)最小化为目标寻优确定的最佳超参数。
36、(6)计算均方根误差(rmse)、平均绝对误差(mae)、决定系数(r2)等评价指标进行评估模型表现。
37、rmse表述为:
38、
39、mae表述为:
40、
41、决定系数r2表述为:
42、
43、式中,n:样本数量; :第i个预测样本的预测值; yi:第i个预测样本的真实值;:平均值。
44、本发明的有益效果:
45、(1)智能自适应切换机制突破静态瓶颈: 创造性地设计了基于滑动窗口的“实时波动度”指标 υ。通过离线shap分析验证,温度等关键参数突变是引起数据波动的核心因素。当 υ > 0.5 触发波动状态时,系统自动将权重向对局部极端特征极其敏感的xgb模型倾斜(权重升至0.7),克服了单一lstm在极值点拟合严重不足的问题。
46、(2)显著提升预测精度: 采用本发明构建的lstm-xgb-volatility动态集成模型,相较于最优的单一lstm模型,平均绝对百分比误差(mape)由4.54%降至3.47%,决定系数(r²)高达0.948,实现了对沼气产量的高精度跟踪。
47、(3)更优的数据预处理区间: 针对沼气非线性特征,本发明通过网格搜索将归一化区间创新性地设定为(-10,10),使输入数据更容易落在神经网络激活函数的非线性区域,同时扩大了数据范围,有效抵抗了由于设备维修、极端天气等因素带来的现场数据噪声干扰。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com