
qcow2存储的快速查表方法、多线程IO并行处理方法及设备与流程
本技术涉及信息,尤其涉及一种qcow2存储的快速查表方法、多线程io并行处理方法及设备。
背景技术:
1、qcow2(qemu copy-on-write version 2,)是qemu/kvm虚拟化平台广泛使用的磁盘镜像格式,支持快照、写时复制、压缩和加密等特性。qcow2存储的核心元数据由l1table、l2 table和refcount table/refcount block组成,其结构如图1所示。其中,l1table固定驻留内存,记录每个l2 table在镜像文件中的物理偏移;l2 table以缓存分片(slice)为单位缓存于l2 cache中,每条l2条目记录一个集群(cluster)的宿主机物理偏移及copied、cow等标志位;refcount table和refcount block记录每个集群的引用计数,用于写时复制触发判断和快照管理。访问qcow2镜像时,通过遍历l1 table和l2 table即可完成从客户机虚拟偏移到宿主机物理偏移的两级地址翻译。
2、为提升io性能,现有技术引入了iothread-vq-mapping(io线程-虚拟队列映射)技术,将每个virtio-blk磁盘的虚拟队列绑定到独立的io线程,使不同队列的io请求在不同cpu核上并行执行。以图2中所示的8队列绑定8个io线程的virtio-blk磁盘为例,每个io线程独立处理一个虚拟队列的io请求。该技术在raw格式磁盘上可实现接近线性的iops(input/output operations per second,每秒输入输出操作数)扩展。
3、然而,在qcow2格式下,即便采用了上述多队列映射技术,实测多队列的iops与单队列几乎相同,多队列并发优势无法发挥。其根本原因在于:现有的qcow2存储中l2查表和数据io操作公用一把协程互斥锁s->lock。每个io线程在发起实际数据读写之前,均需持有该协程互斥锁完成l2查表过程,而所有io线程竞争同一把协程互斥锁完成l2查表,形成串行化瓶颈。
4、具体而言,l2查表本身仅为纳秒级的纯内存操作,而qemu的协程互斥锁在跨io线程竞争时,其快速路径的cas(compare and swap,比较并交换)操作失败后退化为跨线程唤醒调度,产生微秒级的调度开销,锁开销与查表耗时的比值可超过百倍,导致锁开销完全主导了io路径的耗时。此外,qemu框架中的协程读写锁(corwlock)在单io线程内多个协程之间可实现读锁并发持有,但在跨io线程竞争时,读锁的获取与释放自身依赖内部的协程互斥锁,每次操作仍需通过跨线程调度完成。因此即使将协程互斥锁替换为协程读写锁,在多io线程并发场景下仍然需要完成跨线程调度,产生与协程互斥锁相当的开销,同样无法实现真正的并发读写,io性能较差。
技术实现思路
1、本技术的一个目的是提供一种qcow2存储的快速查表方法、多线程io并行处理方法及设备。
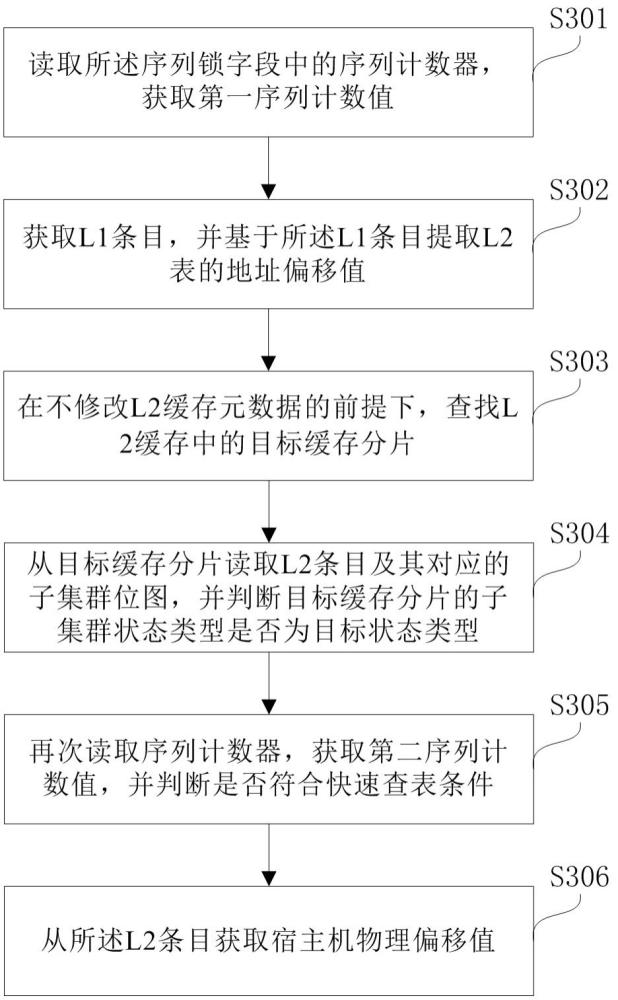
2、为实现上述目的,本技术提供了一种qcow2存储的快速查表方法,所述qcow2存储的l2缓存数据结构中包括序列锁字段,并设置所述序列锁字段中的序列计数器初始值为偶数,当对l2缓存的元数据执行原地修改处理之前,将序列锁字段的序列计数器加1,原地修改处理完成后,再将序列锁字段的序列计数器加1,两次修改序列锁字段的序列计数器之间插入写内存屏障,所述方法包括:
3、读取所述序列锁字段中的序列计数器,获取第一序列计数值;
4、获取l1条目,并基于所述l1条目提取l2表的地址偏移值;
5、在不修改l2缓存元数据的前提下,根据所述地址偏移值查找l2缓存中的目标缓存分片;
6、从所述目标缓存分片读取l2条目及其对应的子集群位图,并根据所述l2条目及其对应的子集群位图判断目标缓存分片的子集群状态类型是否为目标状态类型;
7、若为目标状态类型,再次读取所述序列锁字段中的序列计数器,获取第二序列计数值,并根据所述第一序列计数值和第二序列计数值判断是否符合快速查表条件,其中,两次读取所述序列锁字段中的序列计数器之间插入读内存屏障;
8、若符合快速查表条件,在不持有协程互斥锁s->lock的情况下从所述l2条目获取宿主机物理偏移值。
9、进一步地,读取所述序列锁字段中的序列计数器,获取第一序列计数值,包括:
10、读取所述序列锁字段中的序列计数器,若当前的序列计数值为奇数,则将所述序列计数值减1后作为第一序列计数值,若当前的序列计数值为偶数,则将所述序列计数值作为第一序列计数值;
11、根据所述第一序列计数值和第二序列计数值判断是否符合快速查表条件,包括:
12、比较所述第一序列计数值和第二序列计数值,若第一序列计数值和第二序列计数值相等,则判定符合快速查表条件,若第一序列计数值和第二序列计数值不相等,则判定不符合快速查表条件。
13、进一步地,所述方法还包括:
14、若不符合快速查表条件,则重试所述快速查表方法,直至重试次数达到预设值。
15、进一步地,获取l1条目,并基于所述l1条目提取l2表的地址偏移值,包括:
16、使用原子读取操作获取l1条目,并基于所述l1条目提取l2表的地址偏移值。
17、进一步地,所述目标状态类型为normal类型。
18、进一步地,序列锁的写段保护范围不包括qemu协程让出点。
19、进一步地,清理l2缓存的缓存槽位slot时,使用原子操作并纳入序列锁的写段保护范围内。
20、本技术还提供了一种qcow2存储的多线程io并行处理方法,所述方法包括:
21、当读请求到达时,多个io线程采用前述的快速查表方法并行查询宿主机物理偏移值,并在成功查询到宿主机物理偏移值时,根据所述宿主机物理偏移值并行读取数据;
22、当写请求到达时,多个io线程采用如权利要求1至5中任一项所述的快速查表方法并行查询宿主机物理偏移值,并在成功查询到宿主机物理偏移值,且确认无元数据变更需求时,根据所述宿主机物理偏移值并行写入数据。
23、进一步地,所述方法还包括:
24、在成功查询到宿主机物理偏移值,且确认有元数据变更需求时,尝试获取协程互斥锁s->lock;
25、在持有所述协程互斥锁s->lock后,根据所述宿主机物理偏移值并行写入数据。
26、进一步地,所述方法还包括:
27、当采用所述快速查表方法并行查询宿主机物理偏移值失败时,采用持有协程互斥锁s->lock的加锁查表路径查询宿主机物理偏移值。
28、基于本技术的另一方面,还提供了一种计算设备,该设备用于存储计算机程序指令的存储器和用于执行计算机程序指令的处理器,其中,当该计算机程序指令被该处理器执行时,触发所述设备执行所述qcow2存储的快速查表方法或多线程io并行处理方法。
29、本技术还提供了一种计算机可读介质,其上存储有计算机程序指令,所述计算机程序指令可被处理器执行以实现所述qcow2存储的快速查表方法或多线程io并行处理方法。
30、与现有技术相比,本技术提供了一种qcow2存储的快速查表方案,该方案通过在l2缓存的查表过程中的轻量级序列锁机制,利用序列锁字段的序列计数值的奇偶变化标识以及插入的内存屏障,来确保l2查表过程中读侧可以在不持有协程互斥锁的前提下安全地读取l2条目中的元数据,将l2查表操作从协程互斥锁的竞争中解放出来,实现多io线程的真正并发l2查表。
31、在此基础上,本技术还提供了一种qcow2存储的多线程io并行处理方案。该方案将快速查表方案集成至读写io路径,使得在元数据已分配的稳态场景下,多个io线程能够在不持有协程互斥锁s->lock的情况下,根据快速查表得到的宿主机物理偏移值并行读取或写入数据,彻底解决了qcow2存储在多队列虚拟化场景下的性能瓶颈,使其iops扩展能力达到与raw格式相当的水平,实现了真正的多io线程并行处理。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com