
一种面向国产GPU的异构大模型推理适配与算力调度方法及系统与流程
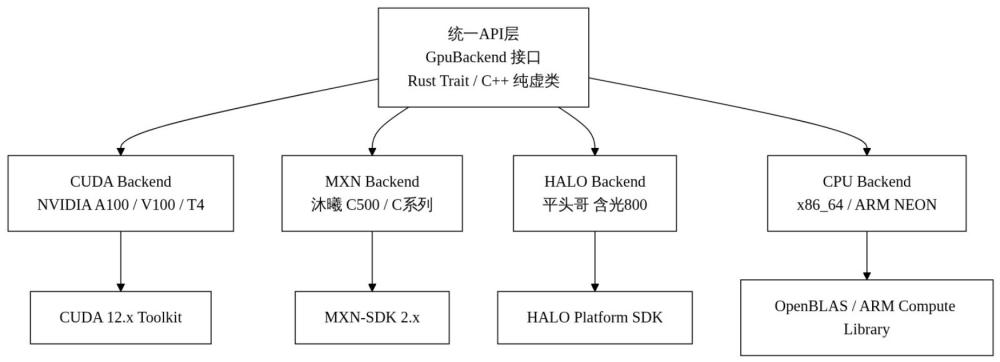
本发明涉及人工智能推理加速与异构算力管理,具体而言,涉及一种面向国产gpu的异构大模型推理适配与算力调度方法、系统及计算机可读存储介质。
背景技术:
1、随着大语言模型(llm)在金融等行业的加速落地,推理算力需求呈指数级增长。然而,现有技术面临以下问题:
2、(1)cuda生态锁定与迁移成本高:金融行业已有的llm推理栈(如llama.cpp、vllm、tensorrt-llm)深度绑定nvidia cuda生态。llama.cpp虽支持cpu和metal后端,但对国产gpu(沐曦mxn、平头哥halo)缺乏原生支持。为每种国产gpu重新实现推理后端需要移植数千行cuda内核,开发工作量大且难以维护。
3、(2)国产gpu软件栈碎片化:沐曦提供mxn-sdk、平头哥提供halo平台、海光提供rocm兼容栈、寒武纪提供cambricon neuware,各sdk的编程模型、api命名与内存管理方式各不相同。开发者需要同时学习多套编程框架,开发与维护成本高。
4、(3)算力管理工具缺失:国产gpu厂商提供的管理工具(如mxn-smi、halo monitor)通常仅支持命令行查询,缺乏统一的可视化监控、告警与调度能力。混合部署场景下,同时管理nvidia与国产gpu需切换多套工具,缺乏面向llm推理场景的gpu调度优化。
5、在高端nvidia gpu受出口管制、信创国产化替代加速推进的背景下,如何以统一接口适配多种异构国产gpu、实现llm推理的”一套api、多种后端”运行,并完成异构算力的统一调度与监控,成为亟待解决的技术问题。
技术实现思路
1、本发明的目的在于克服现有技术的上述至少一种缺陷,提供一种面向国产gpu的异构大模型推理适配与算力调度方法、系统及存储介质,以通过统一gpu后端抽象实现大语言模型在cuda、沐曦mxn、平头哥halo及cpu等多种异构平台上的高效运行,并提供算力池化、负载均衡与监控的完整方案。
2、本发明第一方面提供一种面向国产gpu的异构大模型推理适配与算力调度方法,包括以下步骤:
3、步骤s1,定义统一gpu后端接口,统一gpu后端接口至少包括显存分配、主机到设备数据拷贝、设备到主机数据拷贝、内核启动与计算流同步五个核心原语。
4、步骤s2,分别基于cuda、mxn、halo及cpu实现统一gpu后端接口,得到多个后端实例,其中mxn为沐曦gpu的异构计算编程框架,halo为平头哥含光npu的编程框架。
5、步骤s3,在大模型推理引擎的算子执行层,将通用算子抽象映射至统一gpu后端接口,在运行时自动检测当前环境可用的后端实例,按预设优先级选择最优后端实例执行算子运算。
6、步骤s4,将大模型经量化后的权重张量直接映射至所选后端实例对应的设备显存中,以供算子运算读取。
7、步骤s5,将多个gpu节点组织为算力池,基于负载均衡策略将推理请求路由至算力池中的目标gpu节点。
8、步骤s6,通过独立守护进程采集各后端实例对应gpu设备的遥测数据并输出至监控系统,对gpu利用率、显存、温度、功耗及推理服务指标进行监控与告警。
9、步骤s7,当检测到gpu节点故障时,将待处理推理请求重新路由至健康节点,并在故障节点恢复后自动将其重新加入算力池。
10、本发明第二方面提供一种面向国产gpu的异构大模型推理适配与算力调度系统,包括后端抽象层模块、推理适配模块、模型管理模块、推理任务调度模块、算力池管理模块及算力监控模块。
11、本发明第三方面提供一种计算机可读存储介质,其上存储有计算机程序,计算机程序被处理器执行时实现上述方法。
12、与现有技术相比,本发明具有以下有益效果:
13、1.一套api、多种gpu后端:通过统一gpu后端接口屏蔽底层gpu差异,上层推理代码仅依赖统一api,运行时自动检测并选择最优后端,将国产gpu(沐曦mxn、平头哥halo)接入llm推理栈的开发成本大幅降低。
14、2.推理性能优化:在llama.cpp的ggml框架中仅替换硬件执行部分、复用算子抽象与内存管理,量化推理路径与cuda后端保持一致确保精度无损;关键计算(矩阵乘法、注意力等)调用厂商sdk高性能库(如mxblas、halo npu算子)加速。llama-3-8b-q4_k_m在沐曦c500上推理速度达50+ tokens/s(单卡)。
15、3.异构算力统一调度:算力池化 + 四种负载均衡策略(最少连接/轮询/加权轮询/显存优先)+ 动态批处理 + 优先级队列,支持多模型热加载热切换,提升吞吐量并降低延迟。
16、4.低开销实时监控:rust守护进程直接通过厂商sdk采集遥测数据,经共享内存无锁环形缓冲区传递给采集端,对gpu性能影响小于1%。
17、5.高可用与信创兼容:节点故障自动转移与恢复后自动重新入池;完整支持麒麟v10、统信uos及飞腾、鲲鹏、倚天710等arm64信创平台。
1.一种面向国产gpu的异构大模型推理适配与算力调度方法,其特征在于,包括以下步骤:步骤s1,定义统一gpu后端接口,所述统一gpu后端接口至少包括显存分配、主机到设备数据拷贝、设备到主机数据拷贝、内核启动与计算流同步五个核心原语;步骤s2,分别基于cuda、mxn、halo及cpu实现所述统一gpu后端接口,得到多个后端实例,其中mxn为沐曦gpu的异构计算编程框架,halo为平头哥含光npu的编程框架;步骤s3,在大模型推理引擎的算子执行层,复用所述推理引擎的通用算子抽象与内存管理,仅将硬件执行部分替换为对应后端实例的实现,新增的后端实例以独立后端文件形式接入,其中所述通用算子抽象包括矩阵乘法、注意力计算、层归一化及旋转位置编码算子,矩阵乘法基于各后端对应sdk提供的blas库实现加速,显存分配与释放基于各后端sdk提供的显存分配器实现;在运行时自动检测当前环境可用的后端实例,按预设优先级选择最优后端实例执行算子运算;步骤s4,将大模型经量化后的权重张量直接映射至所选后端实例对应的设备显存中,以供算子运算读取;步骤s5,将多个gpu节点组织为算力池,基于负载均衡策略将推理请求路由至所述算力池中的目标gpu节点;步骤s6,通过独立守护进程采集各后端实例对应gpu设备的遥测数据并输出至监控系统,对gpu利用率、显存、温度、功耗及推理服务指标进行监控与告警;步骤s7,当检测到gpu节点故障时,将待处理推理请求重新路由至健康节点,并在故障节点恢复后自动将其重新加入算力池。
2.根据权利要求1所述的方法,其特征在于,步骤s2中还包括后端自动检测逻辑:依次尝试加载cuda后端、mxn后端、halo后端,当某后端加载成功即选用该后端,当所有gpu后端加载失败时回退至cpu后端。
3.根据权利要求1所述的方法,其特征在于,步骤s4中所述量化后的权重张量为gguf格式的量化张量,所述量化格式包括q4_0、q4_k_m、q5_k_m及q8_0。
4.根据权利要求1所述的方法,其特征在于,步骤s5中所述负载均衡策略包括最少连接策略、轮询策略、加权轮询策略及显存优先策略,所述显存优先策略选择可用显存最多的gpu节点用于大模型推理请求。
5.根据权利要求1所述的方法,其特征在于,还包括推理任务调度步骤:推理请求按优先级进入高优先级队列、普通队列或批量队列并对应不同的超时时间;调度器在预设的批处理窗口内检查请求队列中是否存在使用同一模型的多个推理请求,若存在则将其合并为一个批次在gpu上一次执行,所述批处理窗口可配置。
6.根据权利要求1所述的方法,其特征在于,步骤s6中所述守护进程通过各gpu厂商sdk的c接口采集遥测数据,并通过共享内存环形缓冲区将遥测数据传递给监控采集端,其中所述共享内存环形缓冲区为无锁的单生产者单消费者队列。
7.根据权利要求1所述的方法,其特征在于,步骤s7中检测gpu节点故障具体为:对gpu节点执行周期性健康检查,当连续n次健康检查失败时将节点标记为不可用,其中n为预设正整数。
8.根据权利要求1所述的方法,其特征在于,所述大模型推理引擎为llama.cpp推理引擎,所述算子执行层复用ggml算子抽象,仅将硬件执行部分替换为对应后端的实现,新增的mxn后端与halo后端以独立后端文件形式接入。
9.一种面向国产gpu的异构大模型推理适配与算力调度系统,其特征在于,包括:后端抽象层模块,用于定义包含显存分配、主机到设备数据拷贝、设备到主机数据拷贝、内核启动与计算流同步五个核心原语的统一gpu后端接口,并提供cuda、mxn、halo及cpu多个后端实例;推理适配模块,用于在大模型推理引擎的算子执行层复用所述推理引擎的通用算子抽象与内存管理、仅将硬件执行部分替换为对应后端实例的实现,并在运行时按预设优先级自动选择最优后端实例;模型管理模块,用于将量化权重张量直接映射至所选后端实例的设备显存,并管理模型的热加载与热卸载;推理任务调度模块,用于管理请求队列、请求优先级、动态批处理,并将推理请求路由至目标gpu节点;算力池管理模块,用于将多个gpu节点组织为算力池,基于负载均衡策略路由推理请求,并在节点故障时自动转移、恢复后自动重新加入;算力监控模块,用于通过守护进程采集各后端gpu遥测数据并输出至监控系统。
10.一种计算机可读存储介质,其上存储有计算机程序,其特征在于,所述计算机程序被处理器执行时实现如权利要求1至8任一项所述的面向国产gpu的异构大模型推理适配与算力调度方法。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com