
一种气动人工肌肉执行器固定时间迭代学习控制方法
本发明属于气动人工肌肉执行器控制,特别涉及一种气动人工肌肉执行器固定时间迭代学习控制方法。
背景技术:
1、气动人工肌肉(pneumatic artificial muscle,pam)执行器具有结构简单、质量轻、柔顺性好和安全性高等优点,能够产生类似生物肌肉的收缩运动,因此在康复辅助和肢体助力等领域具有良好的应用前景。然而,受材料非线性、结构耦合及气动驱动过程等因素影响,气动人工肌肉执行器在工作过程中存在显著的迟滞非线性,即在充气和放气过程中,气动人工肌肉执行器的输出位移和收缩力不仅与当前输入压力有关,还受加载历史和运动方向的影响。
2、对于气动人工肌肉执行器而言,康复辅助和肢体助力等任务通常具有明显的重复运行特征。迭代学习控制(iterative learning control, ilc)能够利用前一次的迭代或历史迭代中的跟踪误差信息,对下一次运行的控制输入进行修正,从而逐步改善重复轨迹跟踪性能。因此,迭代学习控制为消除气动人工肌肉执行器迟滞非线性提供了一种有效途径。
3、传统迭代学习控制方法通常侧重于误差沿迭代轴的渐近收敛,即只有当迭代次数趋于无穷时才能获得理想的跟踪性能,但这难以满足实际工程中对有限实验次数和快速收敛的要求。针对这一问题,有限时间稳定理论为迭代学习控制收敛性能提升提供了重要思路,其核心在于通过分数幂型误差收敛机制,使系统误差能够在有限时间内到达目标邻域。尽管有限时间迭代学习控制提高了系统学习效率,但其收敛时间或收敛上界通常仍与初始误差有关。所以当系统初始误差较大或初始状态难以准确预知时,收敛时间上界可能变大,从而难以为实际系统提供可靠的性能保证。因此,如何给出与初始误差无关的迭代收敛保证,从而进一步提高重复任务控制过程的收敛的可预期性,成为当前亟待解决的技术难题。
技术实现思路
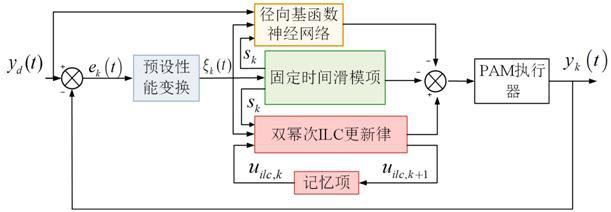
1、本发明的目的是克服现有技术的缺陷,提供一种气动人工肌肉执行器固定时间迭代学习控制方法,其将预设性能控制、滑模控制与迭代学习控制相结合,构建复合控制器,能够提高多轮重复轨迹跟踪精度。
2、本发明提供的技术方案为:
3、一种气动人工肌肉执行器固定时间迭代学习控制方法,包括:
4、建立表征气动人工肌肉执行器运行的非仿射非线性系统模型,并根据所述系统模型将气动人工肌肉执行器的控制律设置为连续时间轴反馈控制量和迭代学习前馈补偿项组成的函数;
5、以及利用所述控制律控制所述气动人工肌肉执行器的动作;
6、其中,所述连续时间轴反馈控制量通过如下方法确定:
7、根据期望位移和实际位移得到气动人工肌肉执行器的跟踪误差,并通过误差变换将所述跟踪误差转换为无约束变换误差;
8、根据所述变换误差构造包含正则化低阶幂项和高阶幂项的非奇异固定时间滑模变量,并将滑模动态划分为可计算动态项、控制输入项、非线性未知项和鲁棒项;
9、根据所述期望位移、所述变换误差和所述滑模变量进行在线估计确定所述非线性未知项;
10、利用固定时间滑模变量构造低阶固定时间滑模项和高阶固定时间滑模项;将所述可计算动态项、低阶固定时间滑模项、高阶固定时间滑模项、所述非线性未知项和所述鲁棒项加和得到所述连续时间轴反馈控制量。
11、优选的是,所述气动人工肌肉执行器的控制律为:
12、;
13、式中,表示气动人工肌肉执行器第次重复运行第时刻施加在比例阀的控制电压,表示气动人工肌肉执行器第次重复运行第时刻的连续时间轴反馈控制量,表示气动人工肌肉执行器第次重复运行第时刻的迭代学习前馈补偿项,为控制电压进入滑模动态后的等效输入增益,表示的逆运算。
14、优选的是,所述的气动人工肌肉执行器固定时间迭代学习控制方法,还包括:
15、根据所述变换误差得到变换误差学习项:
16、;
17、根据所述滑模变量得到滑模变量学习项:
18、;
19、利用所述变换误差学习项和所述滑模变量学习项更新所述迭代学习前馈补偿项;
20、其中,;;
21、式中,表示气动人工肌肉执行器第次重复运行第时刻的迭代学习前馈补偿项,为气动人工肌肉执行器第次重复运行第时刻的变换误差学习修正项,为气动人工肌肉执行器第次重复运行第时刻的滑模变量学习修正项,为气动人工肌肉执行器第次重复运行第时刻总学习修正量;均为正学习增益;和分别迭代轴上的低阶幂指数和高阶幂指数;为气动人工肌肉执行器第次重复运行第时刻的变换误差,为气动人工肌肉执行器第次重复运行第时刻的滑模变量;和分别为误差变换的低阶幂项和高阶幂项;和分别为滑模变量的低阶幂项和高阶幂项。
22、优选的是,所述变换误差的计算公式为:
23、;
24、其中,;;
25、式中,表示气动人工肌肉执行器第重复运行第时刻的跟踪误差,为气动人工肌肉执行器第重复运行第时刻的归一化误差;表示第时刻的预设性能函数;为系统初始时刻允许的误差边界,为系统稳定时允许的误差边界,为误差衰减速率,为对称性能约束系数。
26、优选的是,所述滑模变量为:
27、;
28、其中,为非奇异固定时间滑模变量;为正则化低阶幂项,为高阶幂项;
29、;
30、式中,和均为滑模面设计增益,为正则化常数,和分别为连续时间轴的低阶和高阶幂指数,且满足;为的一阶导数。
31、优选的是,采用径向基函数神经网络在线估计滑模动态中的未知非线性项,过程如下:
32、以作为输入向量,利用径向基函数神经网络的逼近性质,得到未知非线性项的估计值:
33、
34、其中,为气动人工肌肉执行器在时刻的期望位移轨迹, 为期望位移轨迹关于时间的一阶导数,为期望位移轨迹关于时间的二阶导数;为径向基函数神经网络权值,通过在线更新,为正定学习率矩阵;是的导数。
35、优选的是,所述气动人工肌肉执行器运行的非仿射非线性系统模型为:
36、;
37、其中,为重复运行的迭代序号,为每次重复运行内的连续时间,为单次运行任务时长;和分别表示气动人工肌肉执行器第次重复运行第时刻的位移状态和速度状态,表示气动人工肌肉执行器第次重复运行第时刻的比例阀驱动电压,表示气动人工肌肉执行器第次重复运行的非仿射非线性函数,表示气动人工肌肉执行器第次重复运行第时刻的外部扰动,表示气动人工肌肉执行器第次重复运行第时刻的实际位移输出。
38、本发明的有益效果是:
39、1. 本发明针对单一迭代学习控制主要沿迭代轴修正误差、对瞬态误差和外部扰动抑制不足的问题,将预设性能控制、滑模控制与迭代学习控制相结合,构建复合控制器;该方法能够在当前运行过程中约束跟踪误差动态边界并增强抗扰能力,同时在重复运行过程中利用历史误差信息修正控制输入,实现时间域性能约束、鲁棒反馈调节与迭代学习更新的协同,从而提高气动人工肌肉执行器在复杂输入信号和负载条件下的轨迹跟踪性能。
40、2. 本发明针对传统迭代学习控制多关注渐进收敛,有限迭代次数内跟踪误差收敛性能不足的问题,将固定时间收敛思想引入气动人工肌肉执行器迭代学习控制框架,构造具有固定时间收敛特性的非线性学习机制;该方法不依赖精确迟滞模型,利用历史迭代误差信息对控制输入进行更新,使轨迹跟踪误差能够在给定收敛上界内快速降低,并建立与初始误差无关的收敛性能分析框架,从而提高气动人工肌肉执行器的轨迹跟踪精度和复杂工况适应能力。