
一种基于向量检索的虚拟文件系统交互方法及系统与流程
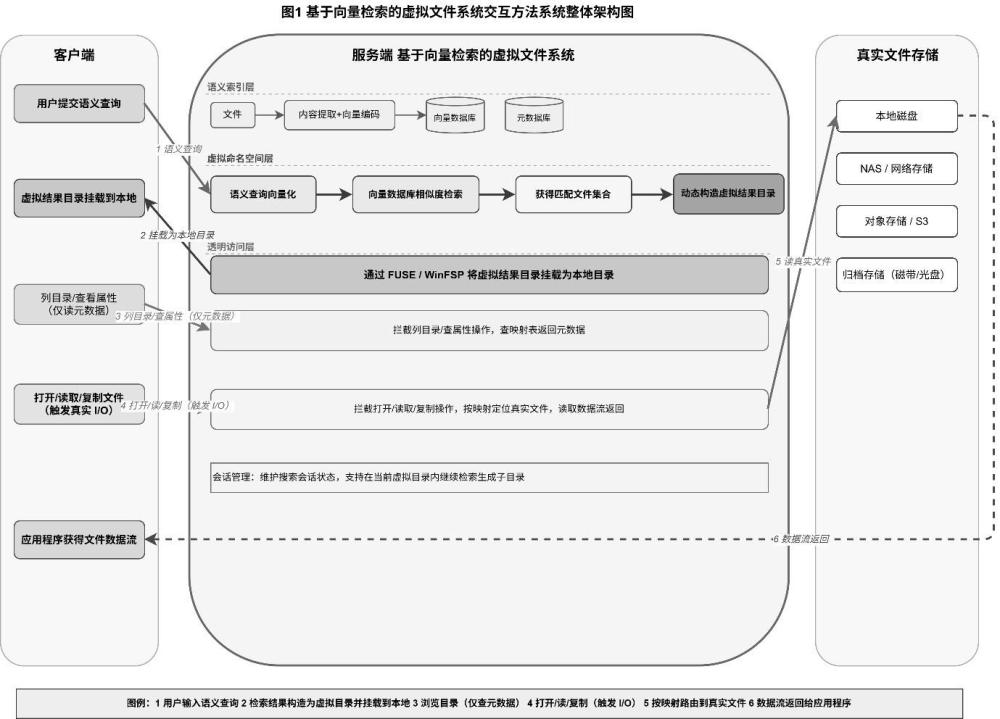
本发明涉及语义检索,尤其涉及一种基于向量检索的虚拟文件系统交互方法及系统。
背景技术:
1、随着企业数字化程度不断加深,个人和组织面临的文件数量和种类急剧增长。传统文件系统仅支持基于文件名和路径的精确匹配检索,无法理解文件内容的语义。近年来,业界出现了将对象存储、块存储、磁带库和光盘库等异构存储设备通过用户态虚拟文件系统统一挂载为本地目录的技术方案,这类虚拟文件系统通过协议转换、统一命名空间和元数据持久化,实现了在线、近线和离线文件的统一可访问性,用户可以通过posix标准接口像操作本地文件一样操作远端或归档介质上的文件。
2、然而,上述虚拟文件系统虽然解决了异构存储统一访问的问题,用户仍需要知道文件的大致路径或文件名才能定位和访问目标文件。当用户不知道文件所在目录、不记得文件名,或者仅记得文件内容的语义特征时,上述系统无法提供有效的文件发现和访问手段。
3、现有的语义检索方案通常将检索系统作为文件系统的外部服务独立部署,存在以下几方面问题:
4、(1)检索结果与文件系统操作分离。现有语义检索系统通常只返回文件路径列表或以网页形式呈现检索结果,用户在获得检索结果后,还需要切换到文件管理器中根据路径逐一查找和打开文件,无法在检索结果界面上直接进行打开、复制或批量操作。搜索结果不能像普通文件夹一样被整体浏览和管理。
5、(2)检索结果无法持续精细筛选。现有语义检索中每次查询彼此独立,用户首次检索获得一批结果后,若需要在结果内部进一步筛选,只能重新面向全库发起新一轮检索,无法基于已有结果集合进行范围收敛。每次精炼查询都需要重新构造查询条件并遍历全库,检索效率随文件规模增长而显著下降。
6、(3)多模态文件的检索能力不足。对于图片文件,传统图搜图方案使用视觉特征向量进行图像间相似度匹配,多主题图片的特征向量被多个主体信号稀释,检索精度下降;同时,检索时上传图片的描述用词与被检索图片的索引描述用词不一致,容易导致匹配失败。对于扫描型pdf文件,由于没有嵌入文字层,传统文本提取方法返回空内容,导致此类文件完全无法被索引和检索。
7、(4)索引与文件系统状态存在不一致的窗口期。现有语义检索方案将向量索引作为独立于文件系统的外部组件维护,索引更新与文件操作在不同线程或不同服务中执行,存在文件已被删除而索引仍存在、或文件已被创建而索引尚未建立的窗口期。
8、(5)上传建立索引的过程缺乏实时进度反馈。传统的异步上传索引任务仅返回最终处理结果,调用方在处理过程中无法获知已完成的文件数量、处理失败的具体文件及其原因、被跳过的文件明细等中间状态信息。
技术实现思路
1、为此,本发明提供一种基于向量检索的虚拟文件系统交互方法及系统,用以克服现有技术中语义检索结果与文件系统操作相互分离、检索结果无法以目录形式直接操作、多模态文件检索能力不足以及索引状态不一致的问题。
2、为实现上述目的,本发明提供一种基于向量检索的虚拟文件系统交互方法。包括:
3、步骤s1,在虚拟文件系统的文件元数据基础上,对所述虚拟文件系统中的文件建立内容语义索引并存储于向量数据库,所述内容语义索引至少包括用于定位文件的文件标识信息、文件原始路径以及由文件内容经编码模型编码后得到的向量数据;
4、步骤s2,接收用户提交的语义查询请求并将其编码为查询向量,以所述查询向量在所述向量数据库中执行相似度检索,获得由文件标识信息构成的匹配文件集合;
5、步骤s3,根据所述匹配文件集合,动态构造虚拟结果目录并为每个匹配文件生成对应的虚拟文件项,所述虚拟文件项至少包括显示信息和相似度信息,并建立每个虚拟文件项与其对应真实文件的位置定位信息之间的映射关系;
6、步骤s4,将所述虚拟结果目录通过用户态虚拟文件系统呈现为操作系统可访问的本地目录;
7、步骤s5,拦截用户对所述本地目录中虚拟文件项发起的文件操作请求,根据所述映射关系获取对应真实文件的位置定位信息,并将所述操作请求路由至对应的真实文件。
8、进一步地,所述动态构造虚拟结果目录,包括:
9、根据语义查询信息、时间戳和会话标识生成虚拟目录名称;
10、为每个匹配文件构建虚拟文件项,所述虚拟文件项至少包含显示名称、文件标识信息、文件属性信息、相似度信息、原始路径映射信息和存储状态信息,所述显示名称采用真实文件的文件名或根据查询内容生成的语义化名称;
11、将各虚拟文件项按照相似度信息降序排列。
12、进一步地,所述拦截用户对虚拟文件项发起的文件操作请求,包括以下至少一种:
13、列目录操作,被拦截后查询所述映射关系,返回当前虚拟结果目录下所有虚拟文件项的属性信息列表,且不读取真实文件内容;
14、属性查询操作,被拦截后根据所述映射关系获取对应真实文件的属性信息并返回;
15、打开操作,被拦截后根据所述映射关系定位真实文件,经权限和可用性校验后建立操作句柄;
16、读取操作,被拦截后根据所述映射关系从真实文件的存储位置读取内容并返回;
17、复制操作,被拦截后通过读取操作获取真实文件内容并传输至目标位置。
18、进一步地,所述虚拟结果目录默认设定为只读模式:
19、允许用户对虚拟文件项执行浏览、打开和复制操作,禁止执行写入、删除和重命名操作;
20、当需要修改原文件时,引导用户通过原始文件所在目录执行修改操作;
21、同一真实文件出现在多个虚拟结果目录中时,对任一虚拟结果目录中虚拟文件项的删除操作仅移除当前映射关系,不删除真实文件。
22、进一步地,还包括在当前虚拟结果目录范围内继续检索以及多目录映射管理:
23、系统维护搜索会话状态,首次检索时创建会话标识并存储当前检索结果对应的文件标识信息集合;
24、接收用户在当前虚拟结果目录范围内提交的继续检索请求,将所述文件标识信息集合作为过滤条件,使检索仅在该集合范围内执行;
25、继续检索完成后生成子虚拟结果目录或更新当前虚拟结果目录,并更新所存储的文件标识信息集合,每轮继续检索均以上一轮结果的文件标识信息集合为过滤边界,形成层级化的虚拟结果目录体系;
26、同一真实文件因响应不同语义查询而出现在不同虚拟结果目录中时,系统为每个出现分别创建独立的映射记录,各映射记录均指向同一真实文件的位置定位信息。
27、进一步地,还包括基于操作日志的索引同步维护机制:
28、当虚拟文件系统中的文件发生变更时,系统生成对应的文件事件并写入操作日志;
29、文件创建时,在内容落盘后建立索引并将索引状态标记为就绪;
30、文件修改时,先删除向量数据库中该文件的所有旧索引记录,再重新提取内容、编码并写入新记录,完成后将索引状态置为就绪,同时将相关虚拟文件项标记为待刷新,若重新索引失败则保留上一版本索引记录;
31、文件删除时,先锁定文件标识信息禁止并发索引操作,再清除索引记录及所有映射关系;
32、虚拟结果目录中展示索引状态为就绪的虚拟文件项,对于索引状态为待处理或失败的虚拟文件项展示对应状态标识。
33、进一步地,所述内容语义索引的建立包括对不同类型文件的差异化内容提取:
34、对于文本文件,直接提取文本内容进行编码;
35、对于图片文件,索引时通过视觉语言模型判断图片复杂度,根据主体数量自适应分配描述篇幅,其中含有一至两个主体的简单图中主体描述占较高篇幅比例,含有三个以上主体的复杂图中各主体描述均匀分配,背景统一用关键词标签表示,生成描述文本后进行编码;检索时,若用户提交的语义查询请求为图片,则通过视觉语言模型从查询图片中提取基础的通用类别名称,再通过本地类别词典将主体名称扩展为对应类别词,构造包含主体名称和类别词的多词查询进行语义检索。
36、进一步地,还包括对扫描型文件的自动判定与光学字符识别兜底:
37、对pdf文件先提取嵌入文字层,当提取文本量低于预设阈值时判定为扫描型文件;
38、将扫描型文件的页面渲染为图像后进行光学字符识别;
39、对识别结果进行噪声行过滤后将文本拼接作为文件内容进行索引,所述噪声行过滤包括过滤纯空白或分隔符号组成的行以及长度小于预设值且不含中文字符的行;
40、当文件总页数超过页数上限时,仅处理前部预设页数并在文本末尾附加截断提示。
41、进一步地,还包括增量去重与实时状态追踪:
42、建立内容语义索引时,利用待索引文件的路径计算哈希值作为记录标识前缀,通过查询向量数据库中是否存在此前缀的记录判断文件是否已被索引;
43、若已索引则读取记录中存储的文件大小和修改时间与当前文件进行比对,文件大小采用整数精确比较,修改时间因存储为浮点数类型存在精度损失而采用预设秒数的容差范围进行比较,当文件大小一致且修改时间差异在容差范围内时跳过该文件的重新编码处理;
44、接收包含文件路径和文件夹路径的混合输入列表,对文件夹路径递归展开为扁平文件列表;
45、在开始逐文件处理前,将全部待处理文件以预设状态写入任务详情,处理过程中每完成一个文件即实时更新该文件的状态和计数,处理状态的取值包括成功、失败、跳过和待处理。
46、一种应用于所述基于向量检索的虚拟文件系统交互方法的系统,包括:
47、语义索引模块,用于在虚拟文件系统的文件元数据基础上,将文件标识信息、文件原始路径以及由文件内容经编码模型编码后得到的向量数据统一存储为内容语义索引;
48、向量检索模块,用于接收语义查询请求并编码为查询向量,基于所述查询向量在向量数据库中执行相似度检索,获得由文件标识信息构成的匹配文件集合;
49、虚拟目录生成模块,用于根据所述匹配文件集合动态构造虚拟结果目录,为每个匹配文件生成虚拟文件项,建立每个虚拟文件项与其对应真实文件的位置定位信息之间的映射关系;
50、虚拟文件系统适配模块,用于将所述虚拟结果目录通过用户态虚拟文件系统呈现为操作系统可访问的本地目录,并拦截用户对虚拟文件项发起的文件操作请求;
51、文件操作路由模块,用于根据所述映射关系将被拦截的文件操作请求路由至对应真实文件,返回文件内容或属性信息。
52、与现有技术相比,本发明的有益效果在于,本实施例通过在虚拟文件系统已有元数据基础上建立内容语义索引,针对文本、图片及便携式文档等不同文件类型采用差异化内容提取策略,使多模态文件均能建立高质量语义索引,并通过增量去重与修改时间容差比对跳过未变更文件的重复处理,提升索引建立效率,配合实时状态追踪使调用方可随时查看各文件的处理状态与进度;用户提交语义查询时,系统将查询编码为与索引同语义空间的向量,采用混合检索策略获得匹配文件集合,其中图片查询通过类别提取与词典扩展构造多词查询,解决了图文检索用词不一致及多主体图片检索精度下降的问题,检索数量依据认知负荷原则设定,确保结果在单页内完整呈现;由此,用户无需知晓文件路径或名称,仅凭自然语言或图片即可获得语义匹配的文件集合,为后续构造可操作虚拟目录奠定基础,实现从语义发现到文件访问的一体化交互。
53、进一步地,本实施例通过根据查询内容、时间戳和会话标识生成具有语义含义且不重复的虚拟目录名称,使用户能够在文件管理器中直观识别不同检索会话;为每个匹配文件构建包含显示名称、文件属性、相似度分数、存储状态及原始路径映射的虚拟文件项,当原始文件名为无意义编号时自动采用查询关键词生成语义化名称,显著提升了检索结果的可读性和用户识别效率;各虚拟文件项按相似度降序排列并在分数相同时按修改时间二次排序,确保最相关、最新的文件优先呈现;同时系统维护当前会话的文件标识集合,为目录内继续检索提供了过滤边界,使多轮检索能够在已有结果范围内持续收敛,无需重复遍历全库;整个过程中虚拟文件项仅存储映射关系而不复制真实文件,同一文件可出现在多个虚拟目录中而不产生存储冗余,实现了检索结果的即时呈现与高效管理。
54、进一步地,本实施例通过维护会话状态和文件标识集合,使用户能够在当前虚拟结果目录范围内持续提交新的检索条件,每轮检索均以上一轮结果的文件标识集合为过滤边界,检索范围逐轮收敛,无需重复遍历全库,检索效率随轮次递增而显著提升,同时每轮检索生成子虚拟目录并挂载至当前目录下,形成由粗到细的层级化目录结构,用户可沿目录层级追溯检索路径,直观理解结果收敛过程;在多目录映射方面,系统通过映射表为同一真实文件在不同虚拟结果目录中的每次出现分别创建独立映射记录,所有记录均指向同一文件唯一标识,使文件仅需存储一份即可在多个语义查询结果中重复呈现而不产生任何存储冗余,且任一虚拟目录中的删除操作仅移除当前视图的映射记录,不影响其他目录中的呈现和真实文件本身,从而在实现检索结果多视角组织和零冗余存储的同时,保障了多视图场景下的数据安全性与操作语义一致性。
55、进一步地,本实施例通过上述操作日志与状态机配合的事务机制,实现了文件系统操作与语义索引的同步维护,有效避免了文件变更与索引不一致的窗口期,同时通过文件锁机制和旧版本保留策略,在保障一致性的前提下保证了索引操作的安全性和检索服务的连续性。
56、进一步地,本实施例通过对便携式文档先提取嵌入文字层,依据统计阈值自动判定文件类型,正常文件直接使用提取文本实现零额外开销,扫描文件则通过渲染与识别转化为可索引文本,实现混合文件集的差异化处理;渲染参数根据页面宽度动态调整,兼顾识别率与处理效率;识别引擎采用懒加载与单例复用,避免重复初始化开销,加载失败后永久标记不再重试,保障系统稳定性;噪声行过滤通过分隔符模式与字符双重判定,有效剔除无效噪声,提升索引文本质量;页数超限时仅处理前部并附加截断提示参与编码,使用户获知索引覆盖范围,从而将扫描文件转化为可检索内容,显著扩大了语义检索系统的文件覆盖范围。
57、进一步地,本实施例通过增量去重与实时状态追踪机制,在保证索引准确性的前提下大幅跳过了未变更文件的重复处理,显著提升了索引建立效率,同时使调用方在处理过程中即可实时获知每个文件的处理状态和进度,无需等待全部任务完成。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com