
一种因果结构图的路径系数生成方法与流程
本发明涉及复杂系统因果分析与决策智能,尤其涉及一种因果结构图的路径系数生成方法。
背景技术:
1、在金融风控、数字化营销、公共政策评估及工业流程优化等复杂系统分析场景中,系统内部变量之间往往存在多层级、多路径的复杂耦合关系。为了刻画这种关系,业界普遍采用有向无环图(directed acyclic graph, dag)进行建模,其中节点代表变量,有向边代表因果作用方向。
2、然而,仅知道“a是b的原因”(结构信息)不足以支持精细化决策,业务方更迫切需要回答“a对b的直接驱动力有多大?”(量化信息)。例如,在银行经营分析中,“宏观经济指标”既可能直接影响“不良资产率”,也可能通过“信贷投放规模”这一中介变量产生间接影响。
3、若无法区分直接作用路径(direct path)与间接传导路径(indirect path),就无法准确评估特定干预手段(如仅调整信贷规模)的真实效果。因此,为 dag 中的每一条有向边生成具有明确因果语义(causal semantics)的数值型权重(即路径系数),是实现科学决策的关键步骤。
4、针对 dag 结构中路径系数(或边权重)的估计问题,现有技术的方案包括:
5、方案一:基于统计相关性的度量方法
6、采用 pearson 相关系数或 spearman 秩相关系数,计算corr(x,y)并进行显著性检验,得到变量间的统计关联强度,直接将其作为路径系数。
7、方案二:基于专家经验的人工赋值方法
8、采用德尔菲法(delphi method)或层次分析法(ahp),依赖领域专家的先验知识,通过主观判断为每一条边赋予权重。
9、方案三:基于简单线性回归的估计方法
10、针对每一条边x→y,孤立地构建单变量线性回归模型y=α+β·x+ε,拟合模型并将回归系数β作为路径系数。
11、方案四:基于结构方程模型(sem)的全局拟合方法
12、通过在预先给定完整因果结构的前提下,采用结构方程模型对系统中全部因果关系进行整体协方差拟合,并利用极大似然估计一次性同时求解所有路径系数。
13、方案五:仅估计总因果效应(total effect)的方法
14、关注原因变量x对结果变量y的整体干预效果,使用 do-calculus 或倾向性得分匹配(psm)计算,不区分作用路径。
15、现有技术方案存在以下不足:
16、1、无法在结构层面区分“直接效应”与“间接效应”
17、现有方法(如相关性分析、简单回归)通常计算的是x对y的综合影响。当x与y之间存在中介变量(mediator) m时(即存在 x→m→y路径),现有方法计算的系数混合了直接路径x→y和间接路径 x→m→y的叠加效应。
18、生成的路径系数不具备“边”的独立物理意义,导致决策者无法判断某个结果是由直接因素驱动,还是由中介传导引起,严重误导路径级的干预策略设计。
19、2、缺乏自动化的“混杂因子”识别与调整机制
20、在简单回归或人工赋值中,往往忽略了混杂变量(同时影响 x和 y的变量 z)的存在。若不阻断后门路径(backdoor path x←z→y),统计关联将包含虚假的伪相关成分,导致产生的路径系数是有偏的。例如,未控制“季节因素”时,可能错误地将“冰淇淋销量”归因为“溺水事故”的强因果路径,违反因果推断的基本假设。
21、3、缺乏对“对撞因子”的正确处理
22、针对部分回归方法倾向于将所有相关变量纳入控制,但如果在回归中错误地控制了对撞因子(即x→c←y结构中的c),反而会人为制造出x与y之间的虚假关联。导致原本独立的变量之间出现非零的路径系数,引入新的估计偏差。
23、4、缺乏系统化的可信度验证闭环
24、现有技术(特别是专家法和传统 sem)通常仅输出一个数值结果,缺乏对结果稳健性的验证。无法判断该系数是源于真实因果机制,还是源于数据噪声、特定样本分布或错误的模型假设。用户无法获知路径系数的置信程度,难以在关键决策中放心使用该结果。
技术实现思路
1、鉴于上述问题,提出了本发明以便提供克服上述问题或者至少部分地解决上述问题的一种因果结构图的路径系数生成方法。
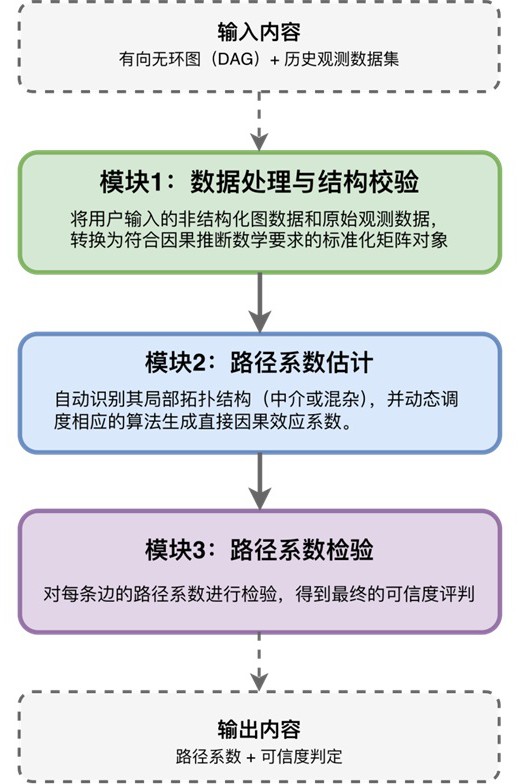
2、根据本发明的一个方面,提供了一种因果结构图的路径系数生成方法,所述生成方法包括:
3、采集非结构化图数据和原始观测数据;
4、将所述非结构化图数据和原始观测数据,转换为符合因果推断数据要求的标准化矩阵对象;
5、自动识别局部拓扑结构,并生成直接因果效应系数;
6、对每条边的路径系数进行检验,获得最终的可信度评判。
7、可选的,所述采集非结构化图数据和原始观测数据具体包括:
8、接收用户输入的因果结构图dag与观测数据,并通过拓扑排序算法与统计清洗算法,确保输入数据满足因果推断的基本假设。
9、可选的,所述将所述非结构化图数据和原始观测数据,转换为符合因果推断数据要求的标准化矩阵对象具体包括:
10、建立外部数据接口,解析用户上传的图结构描述文件和观测数据文件,并将非结构化信息转换为内存中的矩阵对象;
11、内置拓扑排序引擎,检测因果图中是否存在逻辑闭环,确保图结构满足dag约束;
12、执行数据质量检查,建立图节点与数据列的映射索引,并利用统计规则处理缺失值和异常值;
13、对所有连续型变量执行z-score标准化变换。
14、可选的,所述将所述非结构化图数据和原始观测数据,转换为符合因果推断数据要求的标准化矩阵对象具体包括:
15、步骤 s101:多源数据解析与加载:
16、(1)图解析:单元读取因果结构图文件,转换为邻接矩阵a及节点列表;邻接矩阵a具体为若节点,则,否则为0;
17、(2)数据加载:读取观测数据文件,转换为数值矩阵,并提取列头作为变量名列表;
18、(3)传递:将解析后的、、、传递给下一单元;
19、步骤s102:基于入度消减法的无环性校验:
20、(1)初始化:计算图中所有节点的入度,将入度为0的节点放入队列;
21、(2)循环消减:
22、①当队列非空时,弹出节点,将其加入结果序列;
23、②遍历的所有邻居节点,将的入度减 1;
24、③若的入度变为 0,则将加入队列;
25、(3)判定:循环结束后,比较序列的长度与图的总节点数;
26、①若 == ,判定校验通过;
27、②若 < ,判定校验失败,输出构成环的节点集合并终止流程;
28、步骤s103:变量映射一致性校验:
29、(1)集合运算:计算节点列表与数据变量名列表的差集;
30、(2)判据:若,则校验通过;否则,报错并输出缺失的变量名;
31、步骤s104:数据清洗与预处理:
32、(1)缺失值处理:扫描数据矩阵。对缺失率<5%的列进行填充;对缺失率过高的列或行进行剔除;
33、(2)异常值处理:对每一列数据计算四分位距;定义正常区间为,超出正常区间的值被识别为异常值,并替换为区间边界值;
34、步骤s105:z-score标准化变换:
35、(1)统计量计算:计算每一列变量的均值和标准;
36、(2)变换公式:对矩阵中的每个元素执行变换:
37、
38、(3)输出:生成标准化数据矩阵。
39、可选的,所述自动识别局部拓扑结构,并生成直接因果效应系数具体包括:
40、管理遍历进度,从dag的边集合中,按照拓扑排序或列表顺序逐一提取待计算的有向边 ,并锁定为当前“目标边”;
41、内置深度优先搜索dfs与共同祖先搜索算法,扫描全图,判断目标边两端是否存在中介变量或混杂变量;
42、中介效应估计分支、后门调整估计分支、直接回归估计分支;
43、将回归系数β作为路径系数,并回写至图数据结构中,同时检查是否完成所有边的计算。
44、可选的,所述自动识别局部拓扑结构,并生成直接因果效应系数具体包括:
45、步骤s201:目标边获取与初始化:
46、(1)初始化:读取dag的边列表,初始化遍历索引;
47、(2)锁定目标:提取第条边 ;将标记为处理变量,将标记为结果变量;
48、(3)传递:将及图结构传递给结构特征识别单元;
49、步骤s202:拓扑结构特征扫描:
50、(1)中介检测:在图中暂时移除直接边,利用深度优先搜索dfs查找是否存在从到的其他路径;若存在路径,则路径上的节点集合为中介变量集;
51、(2)混杂检测:若为空,继续查找和的共同祖先节点;若存在节点同时拥有指向和的有向路径(),则为混杂变量集;
52、(3)分流决策:
53、①若不为空,存在中介变量,执行步骤s203;
54、②若为空,且不为空,无中介变量有混杂变量,执行步骤s204;
55、③若为空,无中介变量无混杂变量,执行步骤s205;
56、步骤s203:执行中介效应估计分支:
57、(1)估算总效应:建立回归模型,利用最小二乘法计算系数;
58、(2)估算间接效应:
59、①对每个中介,建立=+,得到系数;
60、②建立,得到系数;
61、③计算间接效应;
62、(3)计算直接效应 (de):执行减法运算;值为目标路径系数;
63、步骤s204:执行后门调整估计分支:
64、(1)识别调整集:利用d-separation准则,从混杂变量集中筛选出最小充分调整集,确保阻断所有后门路径且不引入对撞偏倚;
65、(2)多元回归计算:构建多元线性回归模型:,其中,是第k个调整变量的偏回归系数;
66、(3)提取系数:提取对应的偏回归系数作为路径系数;
67、步骤s205:执行直接回归估计分支:
68、(1)构建简单线性回归模型:;
69、(2)提取系数:利用最小二乘法直接求解 的回归系数 ,并作为最终的路径系数;
70、步骤s206:结果封装与循环控制:
71、(1)赋值:将前述步骤计算出的写入图结构中边的属性字段;
72、(2)循环判定:检查遍历索引是否等于边总数;
73、①若,令,返回步骤s201;
74、②若,判定全图计算完成,输出带有完整权重的因果图。
75、可选的,所述对每条边的路径系数进行检验,获得最终的可信度评判具体包括:
76、内置bootstrap重采样引擎,评估路径系数在样本分布扰动下的稳定性,计算置信区间和p值;
77、检测“伪相关”,通过将原因变量替换为随机噪声,验证模型是否会错误地输出显著的因果效应;
78、检测“抗干扰能力”,通过向模型中注入无关的随机混杂因子,验证原有路径系数是否发生剧烈漂移;
79、基于测试结果,依据预设的评判规则,计算每条边的最终可信度得分。
80、可选的,所述对每条边的路径系数进行检验,获得最终的可信度评判具体包括:
81、步骤s301:重采样区间估计:
82、(1)重采样:由bootstrap重采样引擎从原始数据集d中,采用有放回抽样的方式,生成k个同规模的子样本集;
83、(2)重估计:利用上个模块的估计逻辑,在每一个子样本集上重新计算目标边的路径系数,得到分布集合 ;
84、(3)区间判定:计算集合的 95% 置信区间;
85、(4)判据:若置信区间包含 0,即,则判定该路径系数“统计不显著”,标记验证失败;否则标记为通过;
86、步骤s302:安慰剂变量替换检验:
87、(1)构造安慰剂:保持因果图结构不变,将原因节点 x的数据列进行随机打乱或替换为满足正态分布的随机噪声,生成“伪变量”;
88、(2)重计算:使用代替原有的x,重新调用路径系数估计模块估算对y的效应,记为;
89、(3)判据:理论上 应接近于0;若 超过预设阈值,说明模型结构存在严重缺陷,判定验证失败;
90、步骤s303:随机共同原因注入检验:
91、(1)注入干扰:生成一个独立的随机变量,并将其作为一个新的混杂因子添加到dag中;
92、(2)重计算:在新的图结构下,重新估算 的路径系数,记为;
93、(3)判据:计算变化率 ,若δ小于预设阈值,判定验证通过;
94、步骤s304:可信度综合评判:
95、(1)评判:
96、①若三项检验全部通过,则判定路径系数为高可信度;
97、②若至少通过一项检验,则判定路径系数为中可信度;
98、③若任一项检验未通过,则判定路径系数为低可信度;
99、(2)检验结果生成与输出,获得最终的β值及可信度评级封装。
100、本发明提供的一种因果结构图的路径系数生成方法,所述生成方法包括:采集非结构化图数据和原始观测数据;将所述非结构化图数据和原始观测数据,转换为符合因果推断数据要求的标准化矩阵对象;自动识别局部拓扑结构,并生成直接因果效应系数;对每条边的路径系数进行检验,获得最终的可信度评判。在有向无环图结构约束下,将因果网络中每一条有向边的路径系数,明确限定为对应变量之间的直接因果效应,实现路径系数的自动估计与可信度验证。
101、上述说明仅是本发明技术方案的概述,为了能够更清楚了解本发明的技术手段,而可依照说明书的内容予以实施,并且为了让本发明的上述和其它目的、特征和优点能够更明显易懂,以下特举本发明的具体实施方式。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com