
用于展平数字电路的晶体管级布局和布线的人工智能系统和方法与流程
本发明涉及数字电路领域。更具体而言,本发明涉及人工智能(ai)系统和方法在包括大量晶体管的展平数字电路的自动晶体管级布局(placement)和布线(routing)中的使用,其中不要求领域专家信息并且超出了人类的能力。
背景技术:
1、现代处理器包括执行不同功能的块,诸如输入/输出(i/o)、存储器、互联网连接、视频处理、音频处理、算术计算等。这些块在分层设计中通过使用标准单元、定制电路或者使用两者来设计。
2、分层设计(处理器设计的标准实践)是指由多个子电路(即,多个标准单元的组)或用作构建块的标准单元组成的集成电路或其一部分(即,(一个或多个)块),其中通过定位和互连标准单元或子电路来执行全局布局。这与没有层次结构并且晶体管自身用作构建块的展平设计相反。为了规避数字电路呈指数增加的复杂性(即,随着晶体管数量的增加),通常实践分层设计。
3、所描述的系统和方法特别适用于标准单元以及包括大量晶体管的展平数字电路,这导致了大量可能的布局和布线组合,超出了人类的能力。现有的晶体管级布局和布线的系统和方法大多数限于手动布局(即,由人类版图(layout)编辑者)或者限于旨在提高生产力而非ppa的自动工具。现有的自动工具使用不同np行图案替代方案的p型或n型晶体管的分组的符号布局预设(其中n和p分别代表n型和p型晶体管)。这些方法基于常用图案的预先布局的预设并且旨在简化版图编辑任务而非优化。它们通常首先为版图编辑者提供初始布局,并且提供行布局布置的有限集合(例如,np、pn、nppn、pnnp、npnp等)以供从中选择,从而进一步手动修改布局以改进最初提议的布局。但是,这种方法限于相对少量的晶体管并且不使用人工智能方法。此外,结果在很大程度上取决于版图编辑者的熟练程度、经验以及创造力并且它并不跨越可能的布局和布线的整个集合。
4、在本发明的上下文中公开发表的人工智能方法侧重于管芯级优化,而不是标准单元或电路级。usp 11,087,060描述了用现有处理器的原理图及其版图来训练机器学习系统以在各种约束下预测第二处理器的原理图的版图的方法。
5、usp 11,275,882针对模拟电路系统扩展了usp 11,087,060并且描述了应用于现有处理器的原理图及其版图的机器学习方法(诸如遗传算法或随机森林),以基于第二处理器的原理图对第二处理器的两个晶体管是否可以分组在一起、调整尺寸和定向成自动生成第二处理器的模拟版图进行分类(即,预测)。但是,所报告的召回率(86%)和精度(86%)对于实际的实施方式来说并不充分。
6、usp 11,348,000和usp 11,386,322通过使用深度神经网络对处理器进行全局布线,进一步扩展了先前的发明。其描述了用现有处理器的原理图及其全局布线数据来训练深度神经网络的方法,用于至少部分地基于全局布线数据来生成详细布线数据。使用现有处理器的原理图及其全局布线数据来训练深度神经网络以生成特征。然后,当向神经网络馈送第二处理器的原理图时,神经网络生成第二处理器的详细全局布线。
7、近期文献中充满了关于使用ai方法进行处理器设计的研究论文,并且市场上已有商业产品(在处理器级)。w. t. j. chan et al., “beol stack-aware routabilityprediction from placement using data mining techniques”讨论了但未公开:用于在不进行试验或不使用早期全局布线来进行标准单元的全局布局和互连的情况下预测(即,处理器的布局和布线方案的有效性的分类)处理器级布局解决方案是否可布线的机器学习模型。该论文主要侧重于拥塞和布线后设计规则检查(drc - 验证特定设计是否满足将用于其制造的工艺技术所强加的约束)违规。给定网表(netlist)、时钟周期、面积利用率、纵横比和后道工序(beol是设计过程中侧重于芯片上各种组件的布局和布线的阶段)、金属的数量和特定于堆叠的布局,他们的模型预测了处理器的布局是否可布线。针对28nm和45nmcmos技术处理器的报告结果是91%的精度和86%的召回率,这仍然要求人工干预,因为在他们的测试数据集的分类结果中仍然存在大量的假肯定和少量的假否定。
8、r. liang等人在2020 international symposium on physical design 上呈现了“drc hotspot prediction at sub-10nm process nodes using customizedconvolutional network”,这是卷积神经网络(cnn),它在布线的早期阶段预测了10nm以下技术节点的drc热点;即,针对全局布线拥塞或阻塞(即,引脚接入问题)。他们在十二个7nm设计和引脚图像的166个布局实例上将公共领域分割cnn(u-net)的修改版本训练了27小时。用于在早期阶段布线中预测设计规则检查(drc)违规热点的推理导致引脚接入预测的真肯定率(tpr)为78%且假肯定率(fpr)为9%,这不足以实现完全自动化的drc。
9、wang et al. “gcn-rl circuit designer: transferable transistor sizingwith graph neural networks and reinforcement learning”公开了与强化学习组合的图卷积神经网络(gcn),以通过充分利用强化学习在用于混合信号集成电路的不同技术节点与电路拓扑之间转移知识来执行自动的晶体管尺寸调整,用于将模拟电路从一个技术节点移植到另一个技术节点。gcn被用于处理模拟电路中组件之间的连接关系。该模型针对混合信号ic设计,因此使用各种晶体管参数以及电容器和电阻器作为特征。但是,如他们所报告的,他们的模型适用于旧的 - 平面 - cmos晶体管(例如,将模拟设计从180nm移植到45nm),而不适用于例如晶体管的宽度被量化为鳍片的高级数字finfet技术。此外,该模型受限于晶体管的固定拓扑,因为他们的目标是将特定模拟电路从较旧的技术(例如,250nm)转换成更先进的节点(例如,65nm)。有趣的是,r. luo等人在“alphatruss: monte carlotree search for optimal truss layout design”中描述了用于优化桁架版图的强化学习算法,其与晶体管互连有一些相似之处。jiang hu和sachin s. sapatnekar在integration, volume 31, issue 1, november 2001, pp. 1-49的“a survey on multi-net global routing for integrated circuits”中讨论了全局布线方法,该方法解决要在无环有向图上布线的网络的集合(即,块/宏)n = {n1,n2,...,nk}并且可以简化为在存在连线(wiring)拥塞和阻塞的情况下寻找连接两个引脚的最短路径。他们回顾了诸如顺序布线和分层布线技术之类的传统方法,以及诸如基于移动的启发式和迭代删除之类的其他技术。虽然大多数传统布线技术侧重于拥塞,但在拥塞之上出现了诸如定时和串扰之类的新目标。
10、如可以看出的,大多数现有技术描述了将ai系统和方法用于芯片级布局和布线并且侧重于分层设计的数字块和/或标准单元在整个有限管芯区域(即,在画布上)的全局布局,其中约束属于宏观层面;即,单元到单元或块到块设计规则,或者在一些情况下针对模拟电路。分层设计(标准实践)是指由多个子电路(即,多个标准单元的组)或用作构建块的标准单元组成的集成电路或其一部分(即,(一个或多个)块),使得通过定位和互连标准单元或子电路来执行全局布局。这与没有层次结构并且晶体管自身用作构建块的展平设计相反。为了规避随着晶体管数量增加而使数字电路呈指数增加的复杂性,通常实践分层设计。
11、使用ai方法的商用工具通过使整个设计流程自动化代替常见的手动调谐(迭代)流程来优化芯片设计流程,重点是改进生产力和运行时间。机器学习驱动的rtl-to-gds(寄存器传输级(rtl)设计在指定电路的物理版图之前在抽象级定义数字设计的逻辑功能性。图形数据流(gds)是以分层格式表示版图数据的二进制文件,与(块或单元级)布线协同地并发优化芯片的布图规划的全流程优化工具也可以改进ppa,但在芯片级实现;而不是在晶体管级实现。
12、因此,本发明的目标是提供一种在标准单元或展平数字电路内进行晶体管布局和/或布线的系统和方法,以优化功耗、性能和面积(ppa)。
13、本发明的另一个目标是提供一种在标准单元或展平数字电路内进行晶体管布局和/或布线的系统和方法,其适用于标准单元或包括大量晶体管的任何数字电路,这些晶体管的特征在于超出人类能力的大量布局和/或布线组合;用以优化ppa。
技术实现思路
1、在集成电路中,一种使用人工智能(ai)模型对多个晶体管进行展平布局和/或布线的方法包括以下步骤:
2、a)接收由电路原理图和特征组成的输入;
3、b)执行所述ai模型的监督或无监督学习,以产生由所述ai模型预测的布局和/或布线;
4、c)使用成本函数用于优化晶体管布局和/或布线;
5、d)通过以下操作生成最优布局和/或布线:
6、d.1)基于所述ai模型,迭代地运行布局和/或布线的循环;
7、d.2)根据所述成本函数,为每个布局和/或布线组合分配值,并且在执行的迭代中记录布局和/或布线以及值信息,直到满足预定度量或超过预定的迭代次数或经过时间为止;
8、d.3)根据所述成本函数对每个生成的布局和/或布线进行排名;以及
9、d.4)选择前k个(k=1,2,....)布局和/或布线组合。
10、在实施例中,该方法可以包括以下步骤:
11、a)提供神经网络(nn);
12、b)提供蒙特卡洛树(mct);
13、c)提供成本函数;
14、d)接收由电路原理图、晶体管特性和设计规则集合组成的输入;
15、e)生成布局和/或布线预测的集合,用于训练所述神经网络(nn);
16、f)用生成的集合训练所述神经网络,以产生预测的策略和值;
17、g)基于由所述神经网络(nn)生成的预测的策略和值,通过在作为所述蒙特卡洛树(mct)的迭代的m次推演的循环中迭代地运行所述mct来生成最优布局和/或布线;
18、h)通过以下操作生成最优布局和/或布线:
19、d.1)基于所述ai模型,迭代地运行布局和/或布线的循环;
20、d.2)根据所述成本函数,为每个布局和/或布线组合分配值,并且在执行的迭代中记录布局和值信息,直到满足预定度量或超过预定的迭代次数或经过时间为止;
21、d.3)根据所述成本函数对每个生成的布局和/或布线进行排名;以及
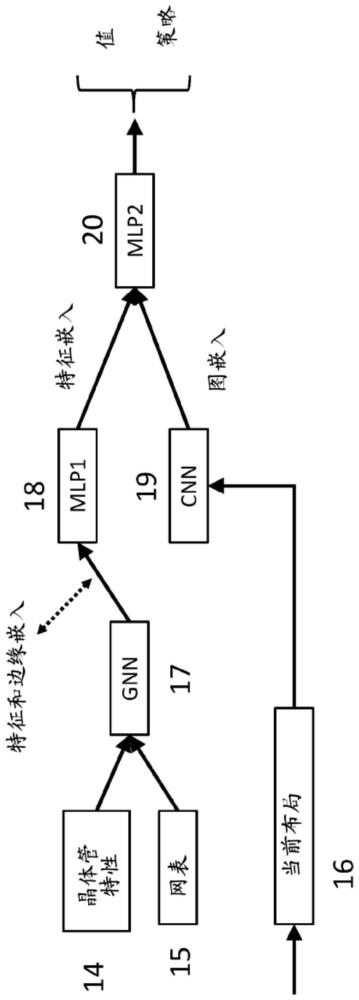
22、d.4)选择前k个(k=1,2,....)布局和/或布线组合。
23、在实施例中,表示蒙特卡洛树(mct)中向下到达叶子的路径的节点的任何序列都可以是布局组合。
24、在实施例中,只有满足设计规则的m次推演的布局组合才可以是可容许的。
25、成本(奖励)函数
l可以是:
26、
27、其中、和是归一化常数,是连线的总长度,是连线的交点的总数,而 是布局的总面积。
28、可以使用包括不同函数形式和不同度量,或者面积、连线长度、连线交叉和其他度量的任何组合的成本函数。
29、该方法还可以包括以下步骤:
30、a)存储最佳布局或前k个布局(k > 1,任意);
31、b)执行m次推演的另一个循环并且修剪在先前推演中已经访问的节点;
32、c)在具有修剪节点的新修剪的树上重新训练nn,以产生策略和值;以及
33、d)迭代地执行布局和/或布线的过程,并且在达到预定数量的m次推演后终止所述过程。
34、最优布局和/或布线的过程可以在满足特定准则时终止,或者在执行预定次数的迭代之后终止,或者在预定的运行时间过去之后终止。
35、可以使用无环有向图来代替树结构,由此减小存储器尺寸并提高速度。
36、神经网络可以是单个神经网络或者包括相同或不同类型的多个神经网络的组合。
37、可以从包括以下的组中选择神经网络:
38、- 用于输入嵌入的图神经网络;
39、- 用于布局嵌入的卷积神经网络;
40、- 用于特征嵌入的密集神经网络;
41、- 用于策略和值生成的密集神经网络。
42、网表或rtl代码可以用作合成网表的输入。
43、成本函数可以反映总面积、总连线或两者,所述成本函数是使布局面积和/或连线长度最小化的任何函数。
44、成本函数可以是以下一项或多项的任何函数形式:
45、- 电路面积;
46、- 连线长度;
47、- 连线交叉;
48、- 特定设计规则;
49、- 晶体管特性。
50、在实施例中,该方法可以包括以下步骤:
51、a)将电路网表及其晶体管的特性输入到图神经网络(gnn),所述gnn生成尺寸为n×h的二维(2d)特征阵列,其中n是晶体管的总数并且h是隐藏层尺寸;
52、b)通过降低其维度来展平尺寸为n×h的2d阵列,并且将展平的2d阵列馈送到mlp1,其输出尺寸为m的向量;
53、c)向卷积神经网络馈送在先前布局和/或布线预测中的每个晶体管的位置的唯一标识号(uin)的向量,并且生成尺寸为n的输出向量;
54、d)组合尺寸为m和n的向量,并且将拼接的向量馈送到密集nn中,以生成新的策略和值。
55、在实施例中,可以拼接神经网络mlp1和cnn的输出。
56、神经网络的输出可以是单个输出。
57、神经网络可以仅生成策略,推断使奖励最大化的策略,或者仅生成值以推断预测的布局的值。
58、晶体管的特性可以是位置的唯一标识号(uin)、晶体管类型、阈值电压、鳍片的数量或宽度、栅极长度或栅指的数量。
59、晶体管的特性的部分列表或具有附加特性的扩展列表可以被用作神经网络的输入。
60、神经网络的输入可以是晶体管uin的拼接向量、晶体管的x位置和y位置的二维阵列、或者包含晶体管的位置信息的任何类型的数据格式,诸如图像文件。
61、神经网络的初始权重可以在包括较少晶体管的较小电路上进行预训练、均匀分布、或根据与ai有关的方法来确定。
62、uin可以是布局中晶体管位置的十进制或二进制数字表示,或者是布局中晶体管位置的独热编码表示,其中任何唯一的表示都可以用作uin。
63、每种类型的晶体管可以具有可变的沟道宽度,包括finfet的不同数量的鳍片,或全环绕栅极或互补fet的堆叠。
64、预定分数可以是标准置信上限(ucb)分数。
65、本文的实施例公开了使用人工智能对数字电路进行展平晶体管级布局和/或布线的系统和方法。特别地,描述了展平电路内晶体管的强化学习(rl)布局和/或布线。rl代理与标准单元或电路的环境进行交互并且实现晶体管的布局和/或布线。生成与经受制造设计规则(dr)的成本函数的最小值对应的最优晶体管布局和/或布线。本文的实施例特别涉及标准单元和电路的晶体管级设计。本发明适用于任何类型的场效应晶体管结构,诸如平面cmos、finfet、全环绕栅极、互补场效应晶体管等。finfet是一种类型的fet,其中导电沟道是细垂直鳍片,而不是平面cmos fet的表面掩埋的平面。全环绕栅极fet(gaa)是一种经修改的晶体管结构,其中栅极包围线状导电沟道。互补场效应晶体管(cfet)– 是一种器件类型,其中nmos和pmos gaa晶体管堆叠在彼此之上,从而允许有效沟道宽度的进一步最大化。
66、除非另有定义,本文中使用的所有技术和/或科学术语与本发明所属领域的普通技术人员通常理解的含义相同。虽然与本文中描述的方法和材料类似或等效的方法和材料可以用在本发明的实施例的实践或测试中,但在下面描述了示例性方法和/或材料。在发生冲突的情况下,将以专利说明书(包括限定)为准。此外,材料、方法和示例仅仅是说明性的并且不旨在必然具有限制性。术语连线、布线和互连可互换使用。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com