
产品知识问答方法及计算机设备与流程
本技术涉及人工智能的自然语言处理,尤其涉及一种产品知识问答方法及计算机设备。
背景技术:
1、自然语言处理(nature language processing,nlp)是计算机科学领域与人工智能领域中的一个重要方向,能实现人与计算机之间用自然语言进行有效通信,自然语言处理技术通常包括文本处理、语义理解、机器翻译、机器人问答、知识图谱等技术。通常使用rag(retrievalaugmented generation,检索增强生成)方式来使用大语言模型,以提高大语言模型所生成的答案的质量。由于产品知识问答的领域性和专业性,若直接利用大语言模型的生成式问答服务,往往会导致大语言模型所输出的答案的准确性较低,或者答案与对应问题的相关性也不高。
技术实现思路
1、本技术的目的在于提供一种产品知识问答方法,能够对用户输入的产品知识问题,输出与产品知识相关的准确性答案。
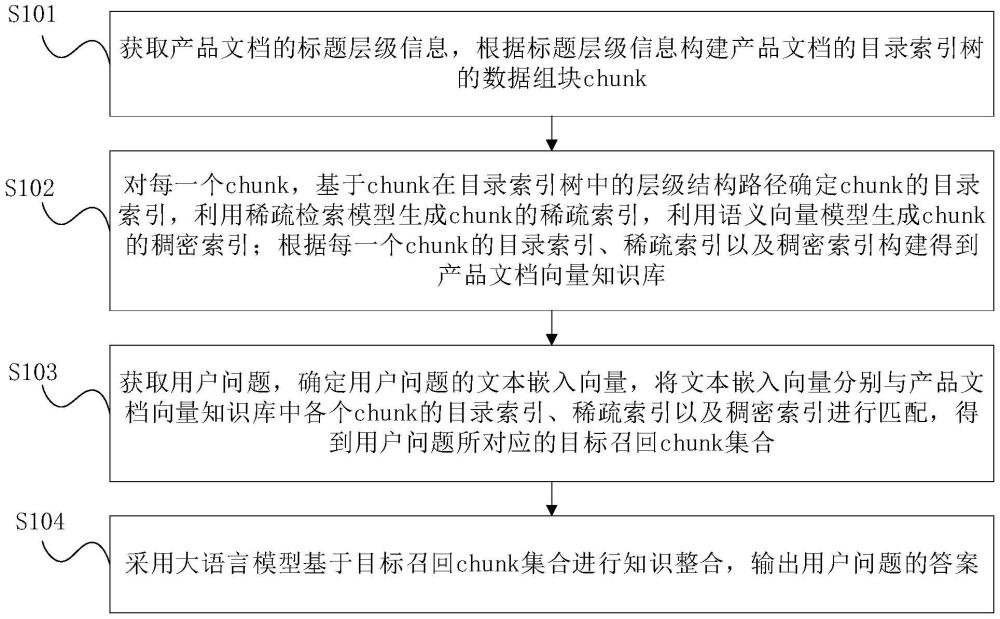
2、基于上述目的,本技术提供一种产品知识问答方法,该方法包括:
3、获取产品文档的标题层级信息,根据标题层级信息构建产品文档的目录索引树的数据组块chunk,其中,
4、针对产品文档的每一个最末层级标题下的正文:
5、若正文的大小小于等于预设chunk阈值,将正文作为一个chunk,其中,chunk阈值基于大语言模型的最大token输入数量确定;
6、若正文的大小大于预设chunk阈值,将正文按照段落划分,构建各个段落的标题,将每一个段落的标题作为目录索引树的倒数第二个节点,将不大于预设chunk阈值的段落作为一个chunk,对大于预设chunk阈值的段落基于大语言模型进行总结,以总结后的内容作为一个chunk;
7、针对每一个chunk,基于chunk在目录索引树中的层级结构路径确定chunk的目录索引,利用稀疏检索模型生成chunk的稀疏索引,利用语义向量模型生成chunk的稠密索引;根据每一个chunk的目录索引、稀疏索引以及稠密索引构建得到产品文档向量知识库;
8、获取用户问题,确定用户问题的文本嵌入向量,将文本嵌入向量分别与产品文档向量知识库中各个数据组块chunk的目录索引、稀疏索引以及稠密索引进行匹配,得到用户问题所对应的目标召回chunk集合;
9、采用大语言模型基于目标召回chunk集合进行知识整合,输出用户问题的答案。
10、进一步的,将文本嵌入向量分别与产品文档向量知识库中各个数据组块chunk的目录索引、稀疏索引以及稠密索引进行匹配,得到用户问题所对应的目标召回chunk集合,包括:
11、将用户问题的文本嵌入向量和稀疏向量分别与各个chunk的目录索引和稀疏索引进行匹配,得到第一召回chunk集合;
12、将用户问题的稠密向量与各个chunk的稠密索引相匹配,得到第二召回chunk集合;
13、若第一召回chunk集合和第二召回chunk集合共有的chunk的数量达到第一数量,将所有的共有的chunk构建为目标召回chunk集合;
14、若第一召回chunk集合中和第二召回chunk集合中共有的chunk的数量小于第一数量,将第一召回chunk集合中除共有的chunk外剩余的所有chunk,以及第二召回chunk集合中除共有的chunk外剩余的所有chunk,合并为第三召回chunk集合;利用重排序模型确定第三召回chunk集合中每一个chunk的稠密索引与用户问题的稠密向量之间的相似度,获取相似度最高的第二数量的chunk;将第二数量的chunk和共有的chunk构建为目标召回chunk集合。
15、进一步的,将用户问题的文本嵌入向量和稀疏向量分别与各个chunk的目录索引和稀疏索引进行匹配,得到第一召回chunk集合;将用户问题的稠密向量与各个chunk的稠密索引相匹配,得到第二召回chunk集合,包括:
16、确定用户问题的文本嵌入向量、稀疏向量和稠密向量;
17、利用重排序模型确定每一个chunk的目录索引的文本嵌入向量与用户问题的文本嵌入向量之间的第一相似度,将第一相似度最高的n个chunk确定为第四召回chunk集合,其中,n为自然数;
18、利用稀疏检索模型确定每一个chunk的稀疏索引与用户问题的稀疏向量之间的第二相似度,将第二相似度最高的m个chunk确定为第五召回chunk集合,其中,m为自然数;
19、将第四召回chunk集合和第五召回chunk集合合并为第六召回chunk集合,利用重排序模型确定第六召回chunk集合中每一个chunk的稀疏索引与用户问题的稀疏向量之间的第三相似度,将第三相似度最高的k个chunk确定为第一召回chunk集合,其中,k为自然数;
20、利用稠密检索模型确定每一个chunk的稠密索引与用户问题的稠密向量之间的第四相似度,将第四相似度最高的l个chunk确定为第二召回chunk集合,其中,l为自然数。
21、进一步的,重排序模型为bge reranker模型,该方法还包括对bge reranker模型进行微调训练,微调训练包括:
22、基于产品文档向量知识库中的目录索引树确定采样层级,利用分层抽样方法在各个采样层级及以下层级中抽选w个选取chunk,其中,w为自然数;
23、针对每一个选取chunk,利用提示词生成对应的问题样本,构建该问题样本对应的训练样本集,其中,训练样本集的构建包括:
24、利用提示词修改选取chunk生成对应的第一正样本chunk,设置第一正样本chunk所对应的相似度为第一相似度;
25、利用提示词总结选取chunk生成对应的第二正样本chunk,设置第二正样本chunk所对应的相似度为第二相似度,第二相似度小于第一相似度;
26、在各个采样层级及以下层级中随机选取v个第三正样本chunk,计算选取chunk的目录索引与v个第三正样本chunk中的每一个第三正样本chunk的文本相似度,将该文本相似度进行归一化,从归一化后的文本相似度与第一相似度阈值二者之间选取最大值作为第三正样本chunk对应的第三相似度,以此得到v个第三正样本chunk所对应的v个第三相似度,其中,v为自然数;
27、在采样层级以上各个层级中随机选取q个负样本chunk,计算选取chunk的目录索引与q个负样本chunk中的每一个负样本chunk的文本相似度,将该文本相似度进行归一化,从归一化后的文本相似度与第二相似度阈值二者之间选取最大值作为负样本chunk对应的第四相似度,以此得到q个负样本chunk所对应的q个第四相似度,其中,q为自然数;
28、以第一正样本chunk、第二正样本chunk、v个第三正样本chunk、q个负样本chunk、第一相似度、第二相似度、第三相似度、第四相似度以及训练提示词构建得到问题样本对应的训练样本集;
29、获取各个问题样本所对应的各个训练样本集,以各个训练样本集构建得到微调数据集,利用微调数据集对bge reranker模型进行微调训练,得到微调后的bge reranker模型。
30、进一步的,该方法还包括:
31、对用户问题进行意图识别,确定用户问题的类型,其中,类型包括确定值类问题和描述型问题;
32、若类型为确定值类问题,从预先构建的产品图谱知识库中检索出与用户问题相匹配的检索结果,采用大语言模型和预设的第一提示词模板,将检索结果进行知识整合,输出用户问题的答案,其中,第一提示词模板采用少样本方式学习;
33、若类型为描述型问题,确定用户问题的文本嵌入向量,基于文本嵌入向量在产品文档向量知识库中进行检索得到目标召回chunk集合,采用大语言模型和第一提示词模板,将目标召回chunk集合进行知识整合,输出用户问题的答案。
34、进一步的,对用户问题进行意图识别,确定用户问题的类型,包括:
35、将用户问题加入到预设的第二提示词模板中,其中,第二提示词模包括多个预设用户意图和每个预设用户意图对应的描述内容,预设用户意图包括产品参数查询、产品描述需求和其它意图,其中,其它意图为除产品参数查询和产品描述需求以外的意图;
36、将加入用户问题的第二提示词模板通过大语言模型,以使大语言模型在第二提示词模板的指导下,确定用户问题的意图;
37、根据用户问题的意图确定用户问题的类型,其中,
38、若用户问题的意图为产品参数查询,用户问题的类型为确定值类问题;
39、若用户问题的意图为产品描述需求,用户问题的类型为描述型问题;
40、若用户问题的意图为其它意图,基于多轮对话的方式确定用户问题的意图,基于所确定的用户问题的意图确定用户问题的类型。
41、进一步的,该方法还包括产品图谱知识库的构建,产品图谱知识库的构建的步骤包括:
42、获取任一产品型号的产品参数描述数据表;
43、采用大语言模型和预设的第三提示词模板对产品参数描述数据表中的参数信息进行信息提取,得到各个参数键值对,每一个参数键值对包括参数名称和对应的参数值,以产品型号和对应的各个参数键值对构建产品属性知识表,其中,产品属性知识表的每一行包括产品型号、参数名称和参数值;
44、解析产品文档中的多媒体资料,获取多媒体资料的产品型号、资料类型以及多媒体资料的存储路径,以构建得到产品多媒体数据资料表,其中,产品多媒体数据资料表的每一行包括产品型号、资料类型以及存储路径;
45、根据产品属性知识表和产品多媒体数据资料表构建产品图谱知识库的三元组数据,其中,三元组数据包括实体、属性和属性值,实体为产品型号,属性包括参数名称和资料类型,属性值包括参数值和存储路径。
46、进一步的,若类型为确定值类问题,从预先构建的产品图谱知识库中检索出与用户问题相匹配的检索结果,包括:
47、基于预设的第四提示词模板将用户问题进行语言转换,生成结构化查询语句;
48、基于结构化查询语句在产品图谱知识库中进行查询,得到目标三元组数据;
49、利用预设的语言转换模板将目标三元组数据转换为自然语言,得到检索结果。
50、基于上述目的,本技术提供一种计算机设备,包括输入装置、处理器和显示屏,
51、输入装置,用于接收用户输入的用户问题;
52、处理器,用于获取产品文档的标题层级信息,根据标题层级信息构建所述产品文档的目录索引树的数据组块chunk,其中,
53、针对产品文档的每一个最末层级标题下的正文:
54、若正文的大小小于等于预设chunk阈值,将正文作为一个chunk,其中,chunk阈值基于大语言模型的最大token输入数量确定;
55、若正文的大小大于预设chunk阈值,将正文按照段落划分,构建各个段落的标题,将每一个段落的标题作为目录索引树的倒数第二个节点,将不大于预设chunk阈值的段落作为一个chunk,对大于预设chunk阈值的段落基于大语言模型进行总结,以总结后的内容作为一个chunk;
56、针对每一个chunk,基于chunk在目录索引树中的层级结构路径确定chunk的目录索引,利用稀疏检索模型生成chunk的稀疏索引,利用语义向量模型生成chunk的稠密索引;根据每一个chunk的目录索引、稀疏索引以及稠密索引构建得到产品文档向量知识库;
57、确定用户问题的文本嵌入向量,将文本嵌入向量分别与产品文档向量知识库中各个chunk的目录索引、稀疏索引以及稠密索引进行匹配,得到用户问题所对应的目标召回chunk集合;采用大语言模型基于目标召回chunk集合进行知识整合,输出用户问题的答案;
58、显示屏,用于将用户问题的答案进行显示。
59、基于上述目的,本技术提供一种计算机可读存储介质,其上存储有计算机程序,计算机程序被处理器执行时实现如上所述的产品知识问答方法的步骤。
60、本技术根据产品文档的标题层级信息构建产品文档的目录索引树的数据组块chunk,数据组块chunk基于产品文档的每一个最末层级标题下的正文的大小进行确定和构建,根据各个chunk的目录索引、稀疏索引以及稠密索引构建产品文档向量知识库,根据所选择模型的token数量限制调整chunk的划分,使得文档的各个chunk能够通过树状结构的目录索引进行索引和访问,从而能够实现高效率的检索;将用户问题的文本嵌入向量分别与产品文档向量知识库中各个chunk的目录索引、稀疏索引以及稠密索引进行匹配,检索到对应的目标召回chunk集合,采用大语言模型对目标召回chunk集合中的chunk进行语义了解,生成用户问题相应的答案,通过对产品文档向量知识库各个chunk的多路索引,即目录索引、稀疏索引以及稠密索引,实现了产品知识库的chunk的多路召回机制,实现对产品知识库的高效检索和精确检索,能够输出与产品知识问题相关性较强的答案,提高大语言模型输出答案的准确性和答案内容的可靠性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com