
一种基于改进YOLOv11与递进训练的肉鸡热应激行为检测方法
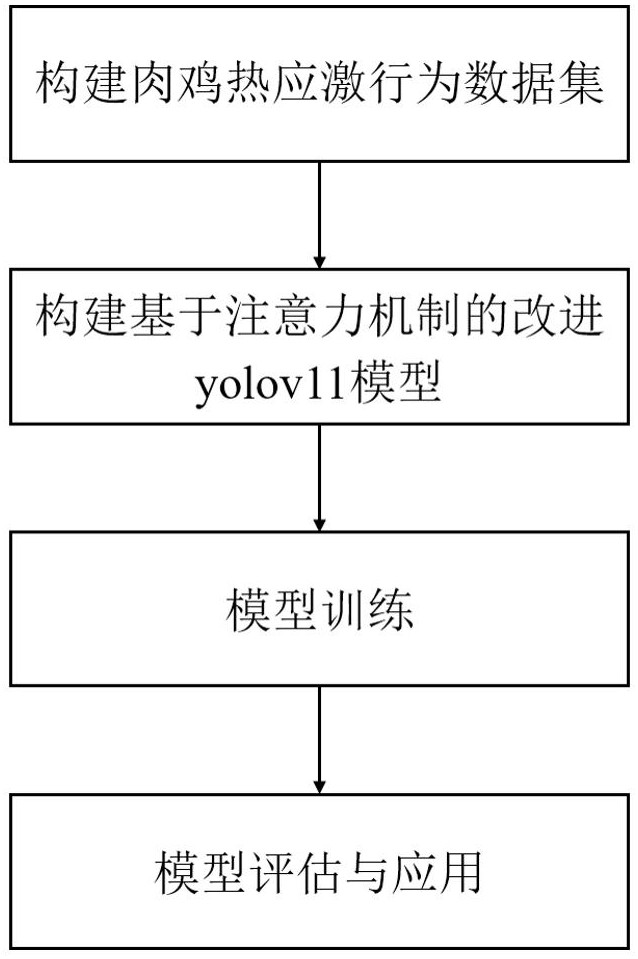
本发明涉及计算机视觉内的一种基于改进yolov11与递进训练的肉鸡热应激行为检测方法。
背景技术:
1、据预测,家禽业将继续是畜牧业中最大的生产部门。其中,鸡是将饲料等资源转化为可食用产品的最高效的家禽。usda预测数据显示,2026年全球肉鸡产量将达到10961.40万吨,增长1.92%;出口量将达到1469.30万吨,增长3.34%,进口量将达到1200.30万吨,增长4.51%。四大主产国或地区的鸡生产持续领跑。2025年,美国、中国、巴西和欧盟肉鸡产量分别达2181.20万吨、1620.00万吨、1545.00万吨和1182.00万吨,较2024年实现了不同程度的增长,增幅分别为2.20%、5.54%、3.00%和0.78%。四大主产国或地区产量合计6528.20万吨,较2024年的6342.20万吨增长186.00万吨,增幅2.93%
2、热应激会引发肉鸡的强烈生理反应,进而增加其发病率和死亡率。因此,监测热应激的影响并及时采取措施,是饲养过程中的关键环节。
3、传统技术主要包括环境参数监测、实验室生化分析和生理指标监测。生理指标方面,体温是最直接的热应激标志;肠道形态会发生变化,绒毛高度降低、隐窝深度增加,导致肠道屏障受损;气囊在喘息时帮助热交换;行为上则表现为采食减少、饮水增加、翅膀下垂、活动减少等。传统的健康监控主要依赖生理传感器等侵入式传感器收集数据,结合兽医知识进行预警。虽然有效,但往往操作复杂。
4、随着计算机算力技术的突破,深度学习得以迅速发展。近年来,深度学习在家禽面部检测领域的研究和应用成为一个重要的研究方向。深度学习通过端到端的学习,突破了图像形态学算法高度依赖人工先验知识和机器学习特征设计的经验依赖性与泛化瓶颈限制[佳。对此,基于计算机视觉的非侵入性检测方法,便成为一种优秀的解决方案。然而,目前大多数图像识别模型都是为猪、牛、羊等较大动物开发的,难以直接迁移到肉鸡等家禽的识别上。家禽体积较小,这对识别的准确性构成了巨大挑战。
5、基于计算机视觉的方法,以yolo系列为主流,在轻量化与速度上独树一帜。但在高密度平养的肉鸡或放养鸡群,禽群高度聚集,个体间存在极度严重的相互遮挡。在这种背景下,标准的边界框检测往往会失效,因为一个矩形框内可能包含多只鸡的局部,甚至将背景误认为目标。
技术实现思路
1、本发明的目的是提供一种基于改进yolov11与递进训练的肉鸡热应激行为检测方法,解决yolo在复杂的平养环境下识别肉鸡热应激行为时混淆标注框背景与目标这一难题,且提高了肉鸡喘息行为的识别的精度。
2、为实现上述目的,本发明提供了一种基于改进yolov11与递进训练的肉鸡热应激行为检测方法,包括以下步骤,
3、s1、获取原始图像数据集,对图像数据集进行图像筛选与超分辨率重建,并进行特征标注,得到分别包含掩膜和标注框标注的归一化数据集;
4、s2、构建改进的yolov11特征提取骨干网络,骨干网络基于具有动态路由功能的双层注意力模块以及跨阶段特征融合模块构建;
5、s3、获取预训练权重并将其加载至骨干网络中,同时冻结其参数,对骨干网络以外的网络部分进行初步训练,得到迁移权重;
6、s4、当s3训练完成预设的训练周期后,自动触发训练监督方式切换,将数据集的标注读取从检测框标注和切换至分割掩膜标注;
7、s5、解冻改进型特征提取骨干网络,并加载s3得到的迁移权重,结合s4调整后的标注映射策略进行训练,得到最终的目标检测模型。
8、作为本发明的进一步改进,s1具体内容如下,
9、s1.1、数据采集通过摄像机录制处于热应激环境的肉鸡在平养环境的视频的拍摄完成,使用三脚架,拍摄角度俯视向下30度,依赖自然光,对于获取的原始视频数据,获取总计时长8小时的视频,进行数据清洗和预处理后,采取提取关键帧的方式获取了600组图像组成的原始图像序列;
10、s1.2、对于从s1.1中获取到的原始图像,依据目标的可见性和图像的清晰度,剔除不存在热应激行为或者运动模糊的图像,最终筛选出符合任务特征的数据集图像;挑选的图像特征应包括,有效保留的喘息行为细节;
11、s1.3、对于从s1.2中筛选出的数据集图像,基于yolo的segment掩膜的标注规范,采用开源工具labelme对其进行关键特征标注;定义了喙部喘息行为的核心标签,将具有视频上下文行为中具有长时间喙部张开行为特征的目标进行标注,标记为喘息,生成初始标注文件;
12、s1.4、对于从s1.3中筛选出的数据集图像,通过基于扩散模型的超分辨率算法对数据集图像进行优化,能增强边缘与纹理清晰度,并放大还原小目标的轮廓,从而帮助卷积神经网络和transformer提取更具判别性的深层特征,显著提升对微小目标的识别率;采用开源工具labelme2yolo进行归一化的处理,将其转换为符合yolo标注规范的归一化的txt标注文件;需进行两次不同设置的归一化处理,分别获得用于第一阶段训练的矩形框的detect格式标注框标注文件,用于第二阶段训练的掩膜的segment格式掩膜标注文件;经过此步骤,得到了数据增强后,目标框和掩膜分割的不同roi区域的数据集。
13、作为本发明的进一步改进,s1.4中归一化处理的归一化算法公式如下,设图像的原始宽度为w,高度为h,目标框中心点在图像中的像素横坐标和纵坐标为和,则写入txt标注文件中的归一化数值和由下式给出:
14、;
15、将segment掩膜格式标注文件转换为detect矩形框格式的公式如下,
16、设掩膜区域为m,其中包含所有属于该目标的像素点或归一化坐标点,则对应的矩形框由下式给出:
17、。
18、作为本发明的进一步改进,s2具体内容如下,
19、s2.1、将yolov11模型的backbone部分进行新的结构设计,添加biformer动态路由功能的双层注意力模块,biformer通过粗粒度区域路由和细粒度令牌注意力的两层机制,实现内容感知的动态稀疏注意力,在保持长距离依赖的同时大幅降低计算量;
20、s2.2、在s2.1修改的新结构的基础上,将原网络结构第8层的c3k2模块替换为c3k2_biformer注意力模块,得到优化后的网络结构;从网络结构第7层传入的输入尺寸,是原始图像首先经过等比例缩放与填充的预处理,得到高为h、宽为w且均为32整数倍的输入图像,经前7层网络后,尺寸下采样至预处理图像的1/32,通道数受网络最大通道数策略限制,固定为512,记为[c,h,w],c为通道数,h为经过预处理后的高,w为经过预处理后的宽,此处输入的特征图为[512,h/32,w/32]。
21、作为本发明的进一步改进,s2.1中动态路由功能的双层注意力biformer模块的数学表达式如下,先粗粒度路由筛选区域,再细粒度计算注意力输出;
22、第一层粗粒度区域路由:将特征图划分为个非重叠区域,先在区域级别计算语义相似度,动态筛选出每个查询区域最相关的个候选区域,过滤掉大量无关区域,实现查询自适应的动态稀疏;
23、第二层细粒度注意力:仅在筛选出的候选区域的并集上,进行精细的token级注意力计算,同时引入局部上下文增强来补充局部信息;
24、假设输入特征图为,其中c为通道数,h和w为图像的高和宽;首先,通过线性变换得到查询(q)、键(k)和值(v)张量:
25、;
26、然后,将这些张量在空间维度上划分为个非重叠区域,每个区域包含个token;
27、为了在宏观上评估区域之间的相关性,需要提取每个区域的全局特征;通过对每个区域内的token取平均值来生成区域级的查询和键:
28、;
29、计算个区域两两之间的相关性得分,得到亲和力矩阵,其中的元素表示第i个区域对第j个区域的关注程度:
30、;
31、对于每一个查询区域i,通过查找的第i行,找出得分最高的k个区域,其中是包含了第i个区域需要关注的k个目标区域的索引:
32、;
33、对于第i个区域,根据索引,收集对应的k个区域的键和值,拼接成新的键和值矩阵:
34、;
35、最后,在token级别上执行标准的多头自注意力计算;第i个区域内 只与聚合后的和发生作用:
36、。
37、作为本发明的进一步改进,s2.2中c3k2_biformer是一个结合了卷积神经网络和视觉注意力机制的混合模块;将yolo原本的c3k2特征提取模块与biformer的核心注意力机制相结合;
38、整体模块为典型的残差结构,假设输入特征图为x,通过基于矩阵乘法和卷积核滑动的父类 c3k2 提取局部特征的“高频细节”得到中间特征y,
39、;
40、再用基于动态稀疏图路由的bra,bra模块采用与操作,提取全局的“低频上下文”,最后通过加法实现特征在同一向量空间中的叠加:
41、。
42、作为本发明的进一步改进,s3的具体内容如下,
43、s3.1、实验环境准备;硬件设备是采用能够提供高效的计算性能的计算机;软件环境方面,使用了pytorch深度学习框架;
44、s3.2、在s2.2得到的网络结构基础上,在步骤3.2的实验环境上,将s2.2构建的网络模型结构在s1.2构建的数据增强后的标注框标注数据集的训练集和验证集上进行模型训练,引入yolov11模型官方预训练权重,并修改原本yolov11模型的优化器,替换为sgd优化器,冻结前十层全部骨干网络。
45、作为本发明的进一步改进,s4中的具体内容如下,
46、s4.1、当s3.2中的第一阶段训练达到预设的收敛阈值或完成预设的训练周期后,自动保存最佳的模型训练权重;经过s3.2训练出来的模型,这是在保护主干网络预训练权重的前提下,让模型快速适应新数据集和自定义网络结构的预训练模型;
47、s4.2、触发数据加载接口的重定向,将数据集的标注读取逻辑从掩膜roi切换至标注框roi,以实现从基础特征学习到精细化目标感知的任务迁移。
48、作为本发明的进一步改进,s5的具体内容如下,
49、s5.1、在s3.3得到的最佳的模型训练权重的基础上,将s2.2构建的网络模型结构,使用在s1.4构建的数据增强后的掩膜标注数据集的训练集和验证集上进行模型训练,调低学习率,并解冻全部骨干网络;
50、s5.2、当第二阶段训练已在100训练周期内无提升或完成预设的训练周期后;保存对应的实验结果,计算最优轮次对应的训练性能指标,保存最佳的模型训练权重;
51、s5.3、使用s5.2中最佳的模型训练权重,将s4.3构建的网络模型结构和s2.2构建的网络模型结构,使用在s1.4构建的数据增强后的掩膜标注数据集的训练集和验证集上进行模型性能测试,计算在测试集上的性能指标,保存相关实验结果;同时编写python脚本实现可视化,将每一张测试集图像真实的目标框和模型产生的预测框合并在一张图像上,以供后续分析对比使用。
52、与现有技术相比,本发明的有益效果在于:使用超分辨率增强小目标细粒度特征,使用transformer模块提高模型精度,使用分阶段迁移学习训练策略提高模型的稳定性。区别于传统的体温计测温,本发明无需捕捉鸡只,消除了因人为接触带来的应激干扰,结果更能反映真实的生理状态。利用机器视觉算法,精准定位异常行为人的的个体,避免漏检,尤其适合平养模式下大群管理的需求。因为是非侵入式部署,改造成本低,无需大规模改造现有鸡舍结构,易于在老旧平养鸡舍中推广。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com