
一种基于明度通道潜在扩散的零样本低光照图像增强方法
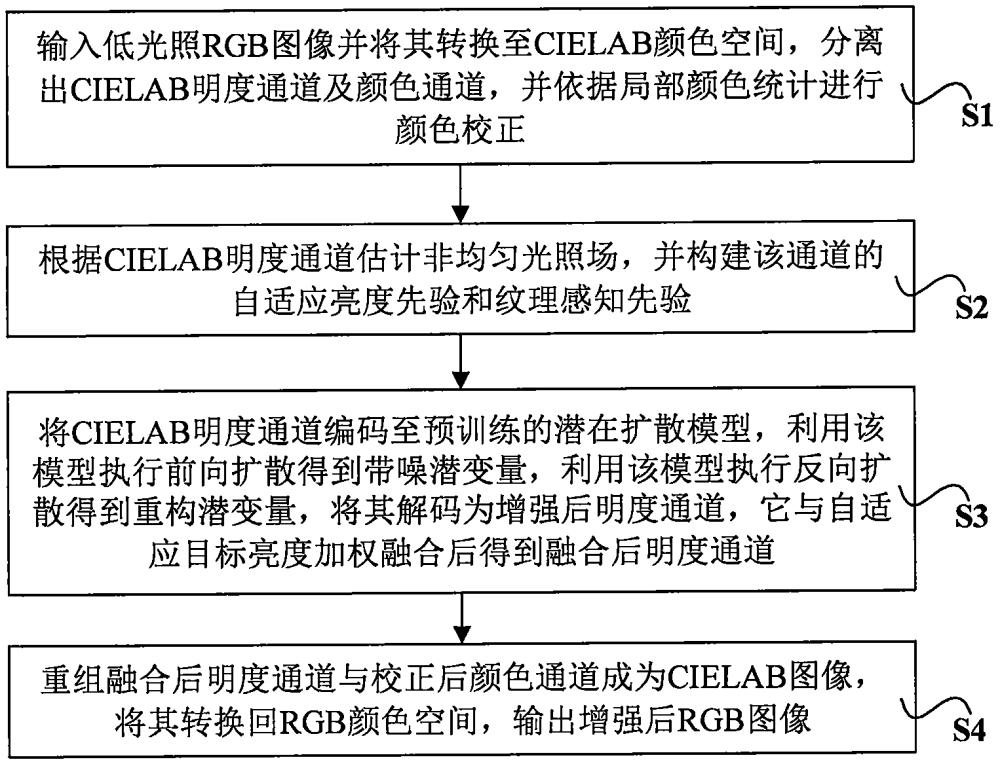
本发明属于计算机视觉与数字图像处理,涉及基于亮度-色彩空间解耦与潜在扩散模型的低光照图像增强方法,尤其是一种基于明度通道潜在扩散的零样本低光照图像增强方法。
背景技术:
1、低光照图像增强(low-light image enhancement,llie),又称低照度图像增强、弱光图像增强,是指对在环境照度不足、曝光受限或光照分布不均等条件下采集的退化图像进行亮度恢复、颜色校正、噪声抑制和细节增强,以提高图像视觉质量以及后续或下游视觉任务可靠性的一种图像处理技术。随着数字化技术的快速发展,低光照图像广泛产生于夜间监控、自动驾驶、机器人导航、移动终端摄影、工业检测、医学影像及水下探测等场景。
2、在低光照成像过程中,受环境照度不足、曝光时间受限、光子散粒噪声以及空间非均匀照明等因素影响,采集图像通常存在整体亮度不足、局部曝光欠缺、颜色偏移、色度衰减、噪声增强和纹理细节丢失等问题。这些问题不仅会降低图像的主观视觉质量,而且会影响目标检测、目标跟踪和图像分割等下游视觉任务的准确性与稳定性。因此,研究一种能够兼顾非均匀光照增强、颜色矫正和纹理保持的llie方法具有重要的理论意义和工程应用价值。
3、目前存在许多llie方法,主要分为三类:传统图像增强方法、基于物理模型的方法和基于深度学习的方法。值得强调的是,在本技术领域中,具体的llie方法通常也称llie模型,方法与模型往往是同义词。本说明书中将不加区分地交替使用这两个同义术语。
4、传统图像增强方法主要包括直方图均衡化、gamma校正、自适应直方图均衡化和对比度拉伸等。该类方法主要依据图像灰度分布或局部像素统计特性调整图像亮度和对比度,具有算法简单、计算效率较高等优点。然而,此类方法通常采用全局或分块灰度映射,缺乏对低光照成像退化过程及空间非均匀照明的有效描述,容易造成暗区域噪声同步放大、正常曝光区域过增强、高亮区域过曝光、局部对比度失衡以及颜色不自然等问题。
5、基于物理模型的方法通常依据retinex理论或低光照成像模型,将观测图像分解为反射分量和光照分量,并通过估计、校正或优化光照分量实现图像增强。该类方法引入低光照图像形成机理,具有一定的物理意义和可解释性。但当光照场估计不准确时,增强结果容易出现光晕、边缘伪影、局部亮度不连续和颜色漂移。此外,该类方法中的正则化参数、增益系数及迭代条件通常依赖人工经验设定,在复杂非均匀照明和多噪声耦合场景中的适用性有限。
6、例如,lime方法(参见:xiaojie guo,yu li,haibin ling:lime:low-light imageenhancement via illumination map estimation.ieee transactions on imageprocessing 26(2):982-993(2017).https://doi.org/10.1109/tip.2016.2639450)是一种典型的基于物理模型的llie方法,它通过选取输入图像各像素在r、g、b通道中的最大值估计初始光照图,并引入结构先验对其进行细化,进而依据优化后的光照图实现低光照图像增强。该方法结构简单,计算效率较高,但其光照估计依赖max-rgb假设,在极暗区域和复杂噪声条件下容易放大隐藏噪声,采用后处理方式去除噪声可能会造成局部细节平滑。
7、基于深度学习的方法能够利用大量样本学习低光照图像与正常曝光图像之间复杂的非线性映射关系,并在特定数据集上取得较好的增强效果。常用的深度学习技术包括卷积神经网络(cnn)、生成对抗网络(gan)、transformer网络等。与传统方法相比,基于深度学习的方法具有更强的特征表示与非线性拟合能力,能够在特定数据集上获得较好的亮度恢复和细节增强效果。然而,这类方法通常围绕特定退化分布建立确定性映射,容易受到训练数据覆盖范围的限制;当测试图像的照明条件、噪声水平、成像设备或颜色退化与训练数据存在差异时,往往会出现泛化性能下降、纹理过度平滑或非真实细节等问题。
8、深度学习有不同的范式(paradigm),典型的范式包括:监督学习(supervisedlearning,sl)、无监督学习(unsupervised learning,ul)、零样本学习(zero-shotlearning,zsl)。
9、监督学习(参见:vladimir vapnik:an overview of statistical learningtheory.ieee transactions on neural networks 10(5):988-999(1999).https://doi.org/10.1109/72.788640与yann lecun,yoshua bengio,geoffrey e.himon:deeplearning.nature 521(7553):436-444(2015).https://doi.org/10.1038/nature14539)是一种以带标签训练样本为基础的机器学习范式,其核心目标是使模型学习输入数据与对应目标输出之间的映射关系。监督学习模型使用由输入样本及其类别标签、数值标签或参考结果组成的训练数据,通过度量模型预测结果与真实目标之间的误差,不断优化模型参数,并在测试阶段对新的输入样本进行分类、回归或预测。监督学习依赖明确的监督信息确定模型的学习方向,通常具有训练目标明确、预测结果稳定和任务适配性较强等优势,但也存在高度依赖大规模高质量标注数据、数据采集与标注成本较高、容易受到训练与测试数据分布差异影响等缺陷或局限性。目前,监督学习已广泛应用于计算机视觉、自然语言处理、语音识别、医学诊断、工业检测和自动驾驶等领域,是传统机器学习与深度学习中最主要的学习范式之一。
10、无监督学习(参见:yoshua bengio,aaron c.courville,pascal vincent:representation learning:a review and new perspectives.ieee transactions onpattern analysis and machine intelligence 35(8):1798-1828(2013).https://doi.org/10.1109/tpami.2013.50)是一种不依赖人工标签或明确目标输出的机器学习范式,其核心目标是从无标签数据中自主发现潜在的数据分布、内部结构及特征表示。无监督学习模型仅利用输入样本进行训练,通过样本间相似性、概率分布、数据重建、流形结构或生成约束等方式构建学习目标,实现数据聚类、降维、密度估计、异常检测和特征表示学习。无监督学习可以有效降低大规模数据标注成本,并充分利用现实场景中数量丰富的无标签数据,但由于缺少明确的监督目标,其学习结果可能存在语义不确定、优化方向不稳定以及任务可控性较弱等缺陷或局限性。目前,无监督学习已广泛应用于数据挖掘、计算机视觉、自然语言处理、异常检测、推荐系统及生物信息分析等领域,是挖掘未知数据规律和学习通用特征表示的重要技术手段。
11、零样本学习(参见:mark palatucci,dean pomerleau,geoffrey e.hinton,tomm.mitchell:zero-shot learning with semantic output codes.23rd annualconference on neural information processing systems 2009,nips2009:1410-1418.http://papers.nips.cc/paper/3650-zero-shot-learning-with-semantic-output-codes以及yongqin xian,christoph h.lampert,bemt schiele,zeynep akata:zero-shot learning-a comprehensive evaluation of the good,the bad and theugly.ieee transactions on pattern analysis and machine intelligence 41(9):2251-2265(2019).https://doi.org/10.1109/tpami.2018.2857768)是一种面向开放集的机器学习范式,其核心目标是让模型能够识别训练过程中未出现任何标注样本的全新类别。零样本学习模型仅使用可见类(seen classes)标注样本完成训练,在测试阶段对无任何训练样本的未见类(unseen classes)进行识别分类。零样本学习必须依赖外部语义先验信息搭建跨类别知识桥梁,实现从已知类别到未知类别的推理迁移。零样本学习可以有效解决(或缓解)传统监督深度学习模型的固有缺陷:高度依赖大规模标注样本,仅能针对封闭固定的类别集合完成训练与推理,无法适配真实场景中类别动态新增、长尾样本稀缺、稀有类别难以标注的现实问题。目前零样本学习已广泛应用于计算机视觉、工业检测、自动驾驶、遥感解译、自然语言处理等领域,成为开放世界智能感知的关键技术之一。
12、扩散模型(diffusion model,dm)近年来被逐渐引入图像生成、图像复原和低光照图像增强任务,以提高图像自然分布建模及纹理细节恢复能力。扩散模型(参见:jonathanho,ajay jain,pieter abbeel:denoising diffusion probabilistic models.neurips2020.https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-abstract.html)通过执行逐步正向扩散(forward diffusion)加噪和反向去噪(reverse denoising)过程,能够学习自然图像的高维分布,并有效恢复图像纹理、结构和视觉细节。
13、例如,中国专利申请公布号cn122222889a,申请公布日2026-06-16,发明创造的名称为“一种基于双通道扩散模型的低照度图像增强方法”,该申请公开的技术方案包括如下步骤:“以低照度rgb图像作为输入图像;将低照度图像映射至hvi颜色空间,解耦出色相强度与亮度分量;采用双通道并行卷积网络对两分量进行初级细化粗增强,输出对应的中间分量;利用基于扩散模型的双通道交叉联合细化网络frdam对中间分量进行扩散条件生成与跨通道交互,重构出精细化分量;将精细化分量逆变换至rgb空间得到增强图像。”(摘自该专利申请的《说明书摘要》)。该技术方案的核心技术包括监督学习、卷积网络、扩散模型、rgb-hvi颜色空间转换等,其不足之处在于:虽在hvi颜色空间中实现了色相强度与亮度分量的解耦,但仍需构建并训练双通道并行卷积网络及扩散交叉联合细化网络,存在模型结构复杂、任务训练数据和计算资源依赖较大、无法实现零样本低光照图像增强等的缺陷与局限性。
14、需指出的是,采用监督学习(sl)的低光照图像增强方法依赖成对的低光照图像和正常曝光图像进行训练。然而,受光照变化、物体运动和传感器响应差异等因素影响,真实场景中难以采集严格配准且曝光差异可控的成对图像;人工采集和配准成本高昂,所构建的数据集也难以充分覆盖不同成像设备、照明条件和噪声水平。因此,模型性能容易受到训练数据分布的限制,当测试图像具有未参与训练的照明条件、噪声水平或颜色退化时,往往使得泛化性能下降。因此,监督学习的低光照图像增强方法训练成本高昂,难以在实际应用中推广。
15、为减少对成对训练数据的依赖,当前低光照图像增强的研究主要集中在无监督(ul)和零样本学习(zsl)两类方法。二者的区别在于:无监督方法强调训练过程中不使用人工标注或严格配准的成对真实值(ground truth),但通常仍需利用一定规模的目标域无标签图像或非成对的低光照、正常曝光图像进行训练,以学习不同照明域之间的映射关系;零样本学习方法则强调不利用成对或非成对数据集进行训练,而是借助预训练模型所包含的通用图像先验,并结合当前待增强图像自身的光照、亮度及纹理信息实现增强。由此可见,零样本学习方法相比于无监督方法在训练成本和实际推广应用方面具有明显优势。
16、无监督低光照图像增强方法的典型例子是无监督生成对抗网络enlightengan(参见:yifan jiang,xinyu gong,ding liu,yu cheng,chen fang,xiaohui shen,jianchaoyang,pan zhou,zhangyang wang:enlightengan:deep light enhancement withoutpaired supervision.ieee transactions on image processing 30:2340-2349(2021).https://doi.org/10.1109/tip.2021.3051462)。该方法采用生成对抗网络(gan)学习非成对低光照图像域与正常曝光图像域之间的映射关系,以注意力引导的u-net作为生成器,并通过全局-局部判别器分别约束整体曝光效果和局部区域的亮度分布;同时,根据输入图像的照明信息构建自正则注意力图,并利用自特征保持损失约束增强前后的内容与结构一致性,从而无需严格配准的低光照-正常曝光图像对。然而,该方法仍依赖一定规模的非成对低光照与正常曝光图像进行预训练,其增强结果易受到训练数据分布及对抗学习稳定性的影响。该方法主要通过域间分布匹配实现视觉增强,未显式建模低光照成像过程中的噪声、颜色偏移与非均匀照明退化,在极暗或强噪声场景下会出现噪声放大、颜色失真及局部曝光不均等缺陷。
17、零样本(zsl)低光照图像增强方法无需利用目标低光照数据集对图像增强模型进行重新训练或微调,而是针对当前待增强图像的特定先验信息(如:光照、结构和纹理等)实现低光照图像增强。这种方法可以减少对成对低光照图像和正常曝光图像的依赖,并降低针对新场景进行任务适配的训练成本,大大提高模型的泛化能力。
18、零样本低光照图像增强方法的典型和最新方法如下:
19、零参考深度曲线估计方法zero-dce(参见:chunle guo,chongyi li,jichangguo,chen change loy,junhui hou,sam kwong,runmin cong:zero-reference deepcurve estimaion for low-light image enhancement.2020 ieee/cvf conference oncomputer vision and pattern recognition.cvpr 2020:1777-1786.https://doi.org/10.1109/cvpr42600.2020.00185)将低光照图像增强建模为图像特定的曲线估计任务,利用dce-net预测逐像素高阶亮度调整曲线,在八次迭代中分别预测rgb三通道对应的24张曲线参数图,并通过迭代曲线映射调节输入图像的动态范围;同时,采用空间一致性、曝光控制、颜色恒常性和照明平滑等非参考损失训练网络,从而无需成对或非成对的正常曝光参考图像。然而,该方法依赖预设的曝光目标以及多个人工设计的损失项和权重,参数设置不当会出现曝光不足或局部过增强。该方法主要通过像素级曲线映射完成亮度调整,未显式建模低光照成像过程中的复杂噪声与颜色退化,也缺少专门的噪声抑制机制,因此在极暗或强噪声场景下往往会出现噪声放大、颜色失真及细节恢复不足等问题。
20、轻量化零参考深度曲线估计方法zero-dce++(参见:chongyi li,chunle guo,chen change loy:learning to enhance low-light image via zero-reference deepcurve estimation.ieee transactions on pattern analysis and machineintelligence 44(8):4225-4238(2022).https://doi.org/10.1109/tpami.2021.3063604)在zero-dce的曲线估计框架基础上对网络结构、曲线参数预测方式和输入尺度进行轻量化改进,通过深度可分离卷积替代普通卷积,仅预测3张rgb曲线参数图并在不同迭代阶段重复使用,同时采用下采样图像估计曲线参数,再将参数图上采样至原始分辨率完成增强;该方法沿用空间一致性、曝光控制、颜色恒常性和照明平滑等非参考损失,无需正常曝光参考图像即可完成训练。然而,zero-dce++仍依赖预设曝光目标以及人工设计的损失权重,并且不同迭代阶段共享相同曲线参数、基于低分辨率图像估计局部亮度变化,在光照分布复杂或局部明暗变化剧烈的场景下可能降低精细区域的自适应调节能力。此外,该方法仍未显式建模噪声与颜色退化,在极暗或强噪声场景下往往出现噪声显现、颜色偏移及细节恢复不足等问题。
21、生成式扩散先验gdp(参见:ben fei,zhaoyang lyu,liang pan,junzhe zhang,weidong yang,tianyue luo,bo zhang,bo dai:generative diffusion prior forunified image restoration and enhancement.2023 ieee/cvf conference oncomputer vision and pattern recognition,cvpr 2023:9935-9946.https://doi.org/10.1109/cvpr52729.2023.00958)利用在imagenet上预训练的无条件去噪扩散概率模型作为通用图像先验,并以退化图像引导反向扩散过程,从而统一处理超分辨率、去模糊、图像修复、图像着色和低光照增强等任务。对于低光照增强,该方法采用光照因子和光照掩膜描述未知退化,并在反向扩散过程中同步优化退化参数,结合曝光控制、颜色恒常性和光照平滑约束恢复图像亮度与颜色。然而,该方法需要执行多步反向扩散,并针对每幅输入图像同步估计退化参数,推理开销较大;此外,其采用相对简化的退化模型描述复杂低光照成像过程,未对曝光、颜色和噪声等耦合退化进行充分建模,也未在感知均匀颜色空间中显式分离亮度与色度信息,增强亮度时仍可能对颜色分量产生干扰。
22、上下文感知的零样本低光照增强方法colie(参见:tomás chobola,yu liu,hanyizhang,julia a.schnabel,tingying peng:fast context-based low-light imageenhancement via neural implicit representations.18th european conference oncomputer vision,eccv 2024:413-430.https://doi.org/10.1007/978-3-031-73016-0_24)利用神经隐式表示,将低光照图像的坐标及其局部上下文信息映射为光照分量,并依据retinex理论在hsv颜色空间中增强亮度通道;同时结合引导滤波恢复原始分辨率,从而在无需预先训练和成对数据的条件下完成单幅图像增强。然而,该方法主要对hsv空间中的亮度分量进行处理,未能充分抑制色调和饱和度分量中存在的噪声干扰;此外,其增强效果依赖曝光控制参数及多个损失权重,参数设置不当会出现曝光不足、局部过曝光、噪声显现或视觉效果不自然等问题。
23、傅里叶先验引导的零样本扩散方法fourierdiff(参见:xiaoqian lv,shengpingzhang,chenyang wang,yichen zheng,bineng zhong,chongyi li,liqiang nie:fourierpriors-guided diffusion for zero-shot joint low-light enhancement anddeblurring.2024 ieee/cvf conference on computer vision and patternrecognition,cvpr 2024:25378-25388.https://doi.org/10.1109/cvpr52733.2024.02398)将傅里叶先验引入预训练扩散模型,利用图像幅度主要承载亮度信息、相位主要关联结构和内容信息的特点,在反向扩散过程中对幅度与相位进行分解和重组,并通过空域一频域交替优化逐步恢复图像结构,从而在无需成对训练数据和预设退化模型的条件下实现低光照增强与去模糊。然而,该方法在极暗环境下容易因输入图像内容信息严重缺失而难以提供有效的相位引导,导致增强和结构恢复性能下降。
24、上述零样本低光照图像增强方法中有一些方法属于基于扩散模型(dm)的零样本低光照图像增强方法,该类方法借助预训练扩散模型所蕴含的通用图像先验信息,并结合当前低光照图像自身的观测信息引导反向扩散(reverse diffusion),可以在不使用低光照任务专用数据集训练或微调模型的情况下实现图像增强。然而,该类方法需要直接对高维图像进行多步迭代,计算和存储开销很大;同时,当输入图像在极暗区域存在严重的信息缺失时,仅依赖其像素、频率或结构信息构建引导,往往难以充分恢复图像的自然纹理和视觉细节。
25、作为一类特殊的扩散模型,潜在扩散模型(latent diffusion model,ldm)也称潜扩散模型、隐空间扩散模型(参见:robin rombach,andreas blattmann,dominik lorenz,patrick esser,ommer:high-resolution image synthesis with latentdiffusion models.2022 ieee/cvf conference on computer vision and pattemrecognition,cvpr 2022:10674-10685.https://doi.org/10.1109/cvpr52688.2022.01042),该类模型通常包括预训练变分自编码器(pretrainedvariational autoencoder,pre-trained vae)、潜空间噪声预测网络(latent spacenoise prediction network)及相应的扩散调度器(diffusion scheduler),其中,pre-trained vae用于将图像映射为低维潜变量(latent variable),噪声预测网络用于预测不同扩散时刻潜变量中的噪声,变分自编码器的解码器(decoder)用于将去噪后的潜变量恢复为图像。时间步、时刻是与潜在扩散模型的前向加噪过程、反向去噪迭代过程密切相关的概念,时间步、时刻这两个术语从不同侧面表示同一个概念;时间步为扩散过程的离散索引,取值范围为0至最大时间步(总扩散步数);时刻指某一特定时间步对应的潜变量状态节点。本技术领域的英文文献中并不区分“时间步”与“时刻”两个术语(两者被视为同义词),统一使用“time step”或“timestep”,通过介词短语“at timestep t”或“at time step t”表达“在时间步t”、“在t时刻”的含义。去噪网络将当前时间步作为条件输入,控制不同时刻下的噪声预测;反向扩散按照降序的时间步序列,由高噪声时刻逐步迭代至t=0时刻,得到重构潜变量。预训练的(pretrained)潜在扩散模型是指已经在大规模数据集上完成完整训练、权重参数已经收敛的潜在扩散模型实例。“预训练”的含义是:(1)vae编码器-解码器已经预先训练好;(2)扩散去噪网络也在海量数据上完成扩散任务训练;(3)整套模型权重保存完毕,可以直接拿来推理、微调、做反演、做下游任务(如低光照增强、图像修复等)。理论上讲,预训练的ldm可以在降低像素空间扩散计算负担的同时,利用从大规模自然图像数据中学习到的生成先验恢复图像纹理和视觉细节。
26、与本发明的技术方案最接近的现有技术是基于零样本潜在扩散的llie框架lliediff(参见:yan huang,xiaoshan liao,jinxiu liang,yuhui quan,boxin shi,yongxu:zero-shot low-light image enhancement via latent diffusion models.thirty-ninth aaai conference on artificial intelligence,aaai 2025:3815-3823.https://doi.org/10.1609/aaai.v39i4.32398)将低光图像增强问题转化为一种零样本推理问题,通过预训练的潜在扩散模型来实现这一目标,从而无需专门的任务训练数据。lliediff的最大不足在于,该方法直接在rgb空间中进行潜扩散增强,因此在较强亮度调整时容易破坏通道间的关系,导致局部颜色偏移和饱和度异常。
27、总之,现有的基于(潜在)扩散模型的零样本低光照图像增强方法(模型)总体上存在以下几个方面的不足:(1)方法(模型)大多依据输入图像的简单退化信息(如:亮度、结构、纹理等)引导反向扩散,当图像处于极暗、强噪声或非均匀照明条件时,有效观测信息不足,难以同时保证亮暗区域协同恢复、纹理保持和观测一致性,严重影响了低光照图像增强的效果;(2)方法(模型)往往需要在高维空间中执行多步反向扩散,并在推理过程中迭代优化潜变量、退化参数或引导信息等,模型的计算和存储开销大,难以兼顾图像增强质量与处理效率;(3)部分方法(模型)直接在彩色潜变量上调整亮度与颜色,缺少亮度-色度解耦以及针对色度偏移的独立校正,亮度过度增强时容易引起颜色漂移、饱和度异常和色度噪声放大,影响了低光照图像增强的效果。
28、为了克服所属技术领域中现有技术的上述不足,本发明创造性地组合利用零样本学习、潜在扩散模型、rgb-cielab颜色空间转换等技术实现低光照图像增强,尤其是采用自适应亮度、纹理感知以及预训练的潜在扩散模型中包含的通用图像先验信息来引导反向扩散,并依据a*、b*颜色通道的局部颜色统计来进行颜色校正,最终形成一种基于明度通道潜在扩散的零样本低光照图像增强方法。
29、下面简要说明本发明的技术方案中采用的若干现有技术,这些现有技术只是本发明技术方案中的几个单项技术特征,它们与本发明的其他技术特征进行非显而易见的有机组合后才构成本发明的技术方案。
30、rgb图像采用rgb颜色模型(rgb color model)(参见:cie,colorimetry,4thedition,cie 015:2018;rafael c.gonzalez and richard e.woods,digital imageprocessing,4th edition,pearson,2018),该模型是一种基于红色、绿色和蓝色三种基色光进行颜色表示的加色模型。该模型将颜色表示为三个数值分量,即红色分量r、绿色分量g和蓝色分量b,通过改变三个分量的相对强度合成不同颜色。以常用的每通道8位数字图像为例,r、g、b分量的取值范围通常为0~255,其中,三个分量均为0时表示黑色,三个分量均为255时表示白色;当三个分量取值不同时,可以表示相应的彩色信息。
31、cielab颜色空间,也被称为l*a*b*(cielab color space,also referred toas l*a*b*)(参见:国际标准:iso/cie 11664-4:2019.colorimetry-part 4:cie 1976 l*a*b*colour space.international organization for standardization,2019.https://www.iso.org/standard/74166.html;国内等效标准-中华人民共和国国家标准:gb/t20147.4-2023色度学第4部分:cie 1976 l*a*b*颜色空间.国家市场监督管理总局、国家标准化管理委员会,2023-08-06发布,2024-03-01实施)是由国际照明委员会(internationalcommission on illumination,cie)在1976年定义的颜色空间。该空间将颜色表示为三个数值:l*表示感知亮度(明度)(perceptual lightness),而a*和b*均是颜色通道,用来表示人类视觉的四种独特颜色:红色、绿色、蓝色和黄色。cielab被设计为一种感知上均匀的颜色空间,即某种数值的变化会对应类似的颜色变化。cielab空间是三维的,能够涵盖人类所有颜色感知的范围,它基于人类视觉的对比模型,其中,红色和绿色构成一对对比色,蓝色和黄色也构成一对对比色。亮度/明度值l*中,黑色对应0,白色对应100。a*轴是相对于绿色-红色的对比色,负值表示向绿色方向,正值表示向红色方向。b*轴则代表蓝色-黄色的对比色,负值表示向蓝色方向,正值表示向黄色方向。
32、颜色空间转换(color space conversion)(参见:international commission onillumination(cie),colorimetry,4th edition,cie 015:2018.vienna,austria,2018.https://doi.org/10.25039/tr.015.2018)是一种不同颜色空间之间的数学映射,将图像中各像素的颜色分量由一种表示形式转换为另一种表示形式的图像处理技术。颜色空间本质上是一个三维坐标系统,每个点都表示图像中的某种颜色。颜色空间的转换通常依赖于对颜色分量的加权和计算,具体的实现过程会依赖于原颜色空间和目标颜色空间的定义。颜色空间转换广泛应用于图像处理、计算机视觉、图像压缩、视频编码等领域。本发明的技术方案涉及从rgb颜色空间到cielab颜色空间的转换。
33、颜色校正(color correction)(参见:mahmoud afifi,brian l.price,scottcohen,michael s.brown:when color constancy goes wrong:correcting improperlywhite-balanced images.2019 ieee/cvf conference on computer vision and patternrecognition,cvpr 2019:1535-1544.https://doi.org/10.1109/cvpr.2019.00163)是一种用于恢复图像真实颜色分布的图像处理技术,通过对白平衡、颜色偏移及颜色增益进行调整,使图像颜色更加符合自然场景的视觉感知效果。颜色校正能够有效抑制低光照环境下由于光谱衰减、曝光不足及传感器响应差异所导致的颜色失真,提高图像颜色真实性和视觉一致性。
34、局部颜色统计(local color statistics)(参考:yu-wing tai,jiaya jia,chi-keung tang:local color transfer via probabilistic segmentation byexpectation-maximization.2005 ieee computer society conference on computervision and pattern recognition,cvpr 2005:747-754.htms://doi.org/10.1109/cvpr.2005.215)指在图像的局部邻域、图像块或分割区域内,对颜色通道像素值计算均值、标准差、直方图等分布统计量,用于刻画颜色的空间分布特性,区别于对整幅图像计算的全局颜色统计。
35、非均匀光照场(non-uniform illumination field)(参考:guanyu xing,yanliliu,haibin ling,xavier granier,yanci zhang:automatic spatially varyingillumination recovery of indoor scenes based on a single rgb-d image.ieeetransactions on visualization and computer graphics 26(4):1672-1685(2020).https://doi.org/10.1109/tvcg.2018.2876541)指场景入射光照的亮度(明度)与光谱分布随空间位置发生改变,不同位置接收的光照强度、色温存在明显差异;当光照场不是空间常数时即为非均匀光照场。
36、本发明评价低光照图像增强效果时采用图像增强领域常用的客观评价指标(参见:sergey kastryulin,jamil zakirov,denis prokopenko,dmitry v.dylov:pytorchimage quality:metrics for image quality assessment.corr abs/2208.14818(2022).https://doi.org/10.48550/arxiv.2208.14818),包括峰值信噪比(peak signal-to-noise ratio,psnr)、结构相似性指数(structural similarity index,ssim)、学习感知图像块相似度(learned perceptual image patch similarity,lpips)、深度图像结构与纹理相似性(deep image stmcture and texture similarity,dists)、梯度幅值相似性偏差(gradient magnitude similarity deviation,gmsd)以及自然图像质量评价指标(natural image quality evaluator,niqe)。其中,psnr用于衡量增强图像与参考图像之间的像素保真度,ssim用于衡量二者的结构相似程度,lpips用于衡量深层特征空间中的感知差异,dists用于综合衡量图像结构与纹理的感知差异,gmsd用于衡量局部梯度结构失真的离散程度,niqe用于在无参考图像条件下评价图像的自然程度。psnr和ssim的数值越高,表示增强结果越好;lpips、dists、gmsd和niqe的数值越低,表示增强结果越好。
37、综上所述,为了克服现有技术中存在的上述不足(即:现有基于(潜在)扩散模型的零样本低光照图像增强方法因依据输入图像的简单退化信息引导反向扩散所导致的难以同时保证亮暗区域协同恢复、纹理保持和观测一致性,严重影响低光照图像增强的效果;在高维空间中执行多步反向扩散导致计算和存储开销大,难以兼顾图像增强质量与处理效率;部分方法直接在彩色潜变量上调整亮度与颜色,缺少亮度-色度解耦以及针对色度偏移的独立校正引起颜色漂移、饱和度异常和色度噪声放大),本发明提供一种基于明度通道潜在扩散的零样本低光照图像增强方法(zero-shot low-light image enhancement methodbased on lightness-channel latent diffusion,简称zsllie-lld)。
技术实现思路
1、本发明所要解决的技术问题是提供克服现有技术的不足后能够获得有益的技术效果的一种基于明度通道潜在扩散的零样本低光照图像增强方法。
2、为解决上述技术问题,本发明是通过以下技术方案实现的:
3、本发明提供一种基于明度通道潜在扩散的零样本低光照图像增强方法,包括下列步骤:
4、步骤s1:输入低光照rgb图像并将其转换至cielab颜色空间,分离出cielab明度通道及颜色通道,并依据局部颜色统计进行颜色校正;
5、步骤s2:根据cielab明度通道估计非均匀光照场,并构建该通道的自适应亮度先验和纹理感知先验;
6、步骤s3:将cielab明度通道编码至预训练的潜在扩散模型,利用该模型执行前向扩散得到带噪潜变量,利用该模型执行反向扩散得到重构潜变量,将其解码为增强后明度通道,它与自适应目标亮度加权融合后得到融合后明度通道;
7、步骤s4:重组融合后明度通道与校正后颜色通道成为cielab图像,将其转换回rgb颜色空间,输出增强后rgb图像。
8、在该方法中,所述步骤s1中的依据局部颜色统计进行颜色校正进一步包括:
9、步骤s11:依据局部颜色统计来计算a*、b*颜色通道的自适应色偏权重,具体包括:
10、首先,针对cielab颜色空间中的a*、b*颜色通道,以像素位置(i,j)为中心构建一个局部窗口ωi,j,并据此计算a*、b*颜色通道的局部平均值以及当前像素与对应局部颜色中心之间的绝对偏差
11、
12、
13、式中,|ωi,j|表示局部窗口内的像素数量,a*(m,n)、b*(m,n)分别表示a*、b*颜色通道中局部窗口ωi,j内像素位置(m,n)上的像素值,a*(i,j)、b*(i,j)分别表示a*、b*颜色通道中像素位置(i,j)上的像素值;
14、然后,计算a*、b*颜色通道的自适应色偏权重
15、
16、式中,为颜色偏差尺度超参数且在闭区间[0,128]内取值,ε为防止分母为零的微小常数;
17、步骤s12:根据所述自适应色偏权重构建颜色补偿量,并对颜色补偿量进行约束,具体包括:
18、首先,利用步骤s11计算得到的a*、b*颜色通道的自适应色偏权重与对应通道的局部平均值来计算a*、b*颜色通道的颜色补偿量δa*(i,j)、δb*(i,j):
19、
20、然后,对所述颜色补偿量进行高斯平滑以减少颜色块效应,并对高斯平滑后的颜色补偿量进行约束,形成高斯平滑与约束后的颜色补偿量
21、
22、式中,函数clip(x,-δ,δ)表示将x限制在闭区间[-δ,δ]内,δ表示颜色校正量的最大允许幅值,gσ表示标准差为σ的二维高斯核,*表示卷积运算;
23、步骤s13:利用所述颜色补偿量分别对a*、b*颜色通道进行校正,得到校正后颜色通道,具体如下:
24、设表示颜色补偿量,校正后颜色通道由下列公式计算:
25、
26、
27、在该方法中,所述步骤s2进一步包括:
28、步骤s21:利用cielab明度通道的空间光照分布来构建各个像素位置的非均匀光照场,并根据所述非均匀光照场构建各个像素位置的暗区权重,具体包括:
29、首先,以归一化的明度通道中的像素位置(i,j)为中心建立一个局部窗口ωi,j,根据像素之间的空间距离和亮度差异为ωi,j内像素位置(i,j)的像素值pi,j分配一个边缘保持权重;
30、然后,利用所述边缘保持权重对局部窗口ωi,j内像素位置(i,j)的像素值pi,j进行归一化加权局部求和,获得像素位置(i,j)上的非均匀光照场e(i,j);
31、最后,基于非均匀光照场e(i,j)构建像素位置(i,j)上的暗区权重:
32、w(i,j)=[1-e(i,j)]η,
33、式中,η表示暗区响应指数且大于0,像素值pi,j的值越小,w(i,j)越大,对应像素位置(i,j)的增强程度越高;像素值pi,j的值越大,w(i,j)越小,对应像素位置(i,j)的增强程度越低;
34、步骤s22:根据所述暗区权重调节像素位置的增强程度,并构建归一化的明度通道的自适应亮度先验,具体包括:
35、首先,根据非均匀光照场e(i,j)计算像素值pi,j的自适应gamma指数γ(i,j),并据此采用gamma校正构建归一化的明度通道的自适应目标亮度
36、然后,利用归一化的明度通道与非均匀光照场e(i,j)之间的差值计算局部窗口ωi,j内的像素位置(i,j)的亮度细节d(i,j),并根据e(i,j)与d(i,j)构建高光区域掩码h0(i,j);
37、最后,根据所述自适应目标亮度亮度细节d(i,j)、暗区权重w(i,j)和高光区域掩码h0(i,j)计算得到自适应亮度先验pbri(i,j):
38、
39、式中,函数clip(x,0,1)表示将x限制在闭区间[0,1]内,λb为亮度细节恢复系数,λd为暗区权重增强系数,λh为高光区域抑制系数,这三个系数均是可学习参数;
40、步骤s23:根据所述自适应目标亮度的梯度信息以及归一化的明度通道在像素位置(i,j)上的明度值与非均匀光照场e(i,j)之间的差值,构建纹理感知先验ptex(i,j):
41、
42、式中,表示二维空间梯度算子,πt表示纹理感知超参数且取值大于或等于0。
43、在该方法中,所述步骤s3中所述将cielab明度通道编码至预训练的潜在扩散模型,利用该模型执行前向扩散得到带噪潜变量,进一步包括:
44、步骤s31:首先将所述归一化明度通道编码至预训练的潜在扩散模型,得到该归一化明度通道的初始干净潜变量z0;然后通过重参数化公式直接得到任意t时刻的带噪潜变量zt,其中,时刻即时间步t=1,2,...,t,t为最大时间步,其取值范围是从1至1000之间的整数,所述重参数公式定义如下:
45、
46、式中,可学习参数表示预训练的扩散调度器在t时刻的累计信号保持系数。
47、在该方法中,所述步骤s3中所述利用该模型执行反向扩散得到重构潜变量,将其解码为增强后明度通道,它与自适应目标亮度加权融合后得到融合后明度通道,进一步包括:
48、步骤s32:利用预训练的潜在扩散模型包含的通用图像先验以及所述自适应亮度先验、所述纹理感知先验,以t时刻的带噪潜变量作为初始输入,执行反向扩散迭代,将还原为重构潜变量并将解码为增强后明度通道最终将与自适应目标亮度进行加权融合后得到融合后明度通道
49、在该方法中,所述步骤s32进一步包括:
50、步骤s321:首先构建一个稀疏时间步序列τ=[τ0,τ1,τ2,...,τn],满足τ0=t,τn=0,且τ0>τ1>τ2>…>τn,其中,n为采样总步数且1≤n≤t;定义特别地,i=0时τ0=t,i=n时τn=0;然后,令时间步t在稀疏时间步序列τ=[τ0,τ1,τ2,...,τn]中依次取值,即在τ=τ0、τ=τ1、τ=τ2、...、τ=τn的情形下,依次迭代执行下列步骤(1)和(2):
51、(1)利用噪声预测网络估计反向扩散t时刻的预测噪声∈t,根据t时刻带噪潜变量和预测噪声∈t估计t时刻去噪潜估计并将解码为t时刻增强后明度通道
52、(2)首先,联合低光照观测一致性损失自适应亮度损失纹理一致性损失与潜空间保真损失来构建总引导损失这些损失的计算方法如下:
53、依据归一化的明度通道和t时刻增强后明度通道构建低光照观测一致性损失
54、
55、式中,⊙表示逐元素乘法,eβ表示光照退化过程,β表示光照退化指数;
56、利用步骤s21构建的暗区权重w(i,j)、t时刻增强后明度通道与步骤s22计算得到的自适应亮度先验pbri(i,j)之间的差值来构建自适应亮度损失
57、
58、式中,h和w分别表示明度通道的高度和宽度,超参数d表示暗区增强系数且大于0;
59、利用步骤s23构建的纹理感知先验ptex(i,j)、归一化的明度通道与t时刻增强后明度通道之间的梯度差值来构建纹理一致性损失
60、
61、式中,表示水平方向的梯度算子,表示垂直方向的梯度算子;
62、利用初始干净潜变量z0、t时刻去噪潜估计来构建潜空间保真损失
63、
64、对上述四项损失加权组合,得到总引导损失
65、
66、式中,超参数λmea、λbri、λtex和λlat表示相应损失项的权重且大于0;
67、利用上述总引导损失更新t时刻带噪潜变量得到时刻带噪潜变量
68、最后,上述反向扩散迭代结束后,得到重构潜变量
69、步骤s322:采用解码器将所述重构潜变量解码为增强后明度通道随后,将所述与步骤s22构建的自适应目标亮度进行加权融合,得到融合后明度通道
70、
71、式中,超参数ω表示增强后明度通道的占比,其在闭区间[0,1]中取值。
72、本发明的有益技术效果主要包括以下几个方面:
73、(1)本发明的方法计算和存储开销小,且能够兼顾图像增强质量与处理效率,其原因是本发明的方法组合利用零样本学习、预训练的潜在扩散模型等技术实现低光照图像增强,一方面零样本学习无需利用低光照图像来训练模型,降低了计算和存储开销;另一方面预训练的潜在扩散模型在低维潜空间中执行多步反向扩散,高效率地实现了低光照图像增强。
74、(2)本发明的方法在实现低光照图像增强的同时确保图像亮暗区域协同恢复,保持图像纹理,其原因是本发明的方法采用自适应亮度、纹理感知以及预训练的潜在扩散模型中包含的通用图像先验信息来引导反向扩散去噪过程。
75、(3)本发明的方法解决了颜色偏移、饱和度异常问题,其原因是本发明的技术方案利用rgb-cielab颜色空间转换、亮度-色度解耦并依据a*、b*颜色通道的局部颜色统计来进行颜色校正。
76、(4)本发明提供了一种增强效果好的零样本低光照图像增强方法,在智能监控、夜间驾驶、移动终端摄影、机器人视觉、水下探测及目标检测等领域具有广阔的应用前景。
77、下面结合附图对本发明的具体实施方式作进一步的描述。本发明附加的方面和优点将在下面的描述中部分给出,这些将从下面的描述中变得明显,或通过本发明的实践了解到。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com