
用于时序3D目标检测的特征融合的制作方法
本公开涉及计算机程序和系统领域,更具体地,涉及一种用于机器学习函数的方法、系统和程序,函数配置为将真实场景的3d点云帧作为输入,并输出各自对应于真实场景中相应物体的局部化表示。
背景技术:
1、室内3d场景理解领域的当前最先进方法,例如fcaf3d(d. rukhovich、a.vorontsova和a. konushin,《fcaf3d:全卷积无锚点3d目标检测(
fcaf3d: fully
convolutional anchor-free 3d object detection)》,arxiv,2022年3月24日。访问时间:2022年10月11日。[在线]。可获取:http://arxiv.org/abs/2112.00322)或tr3d(d.rukhovich、a. vorontsova和a. konushin,《tr3d:面向实时室内3d目标检测(
tr3d:
towards real-time indoor 3d object detection)》,arxiv,2023年2月8日。doi:10.48550/arxiv.2302.02858),依赖于在带标注数据集上以监督方式训练的机器学习模型。这些模型在包含室内场景(即带家具的房间)的数据集上进行训练。这些场景根据用于对其进行数字化的模态来表示,通常为3d点云、相机馈送或其3d重建。当前使用的公共数据集包括sun rgb-d(s. song、s. p. lichtenberg和j. xiao,《sun rgb-d:面向rgb-d场景理解的基准数据集(
sun rgb-d: a rgb-d scene understanding benchmark suite)》,发表于《ieee计算机视觉与模式识别会议论文集》,2015年,第567至576页。访问时间:2022年11月16日。[在线]。可获取:https://openaccess.thecvf.com/content_cvpr_2015/html/song_sun_rgb-d_a_2015_cvpr_paper.html)、scannet(a. dai、a. x. chang、m. savva、m.halber、t. funkhouser和m. nießner,《scannet:富含精细标注的室内场景3d重建数据集(
scannet: richly-annotated 3d reconstructions of indoor scenes)》,arxiv,2017年4月11日。doi:10.48550/arxiv.1702.04405)以及arkitscenes(g. baruch等人,《arkitscenes:面向移动rgb-d数据的多样化真实世界3d室内场景理解数据集(
arkitscenes: a diverse real-world dataset for 3d indoor scene understanding
using mobile rgb-d data)》,载于《第三十五届神经信息处理系统数据集与基准赛道(第一轮)》,2021年。[在线]。可获取:https://openreview.net/forum?id=tjzjv_qh_ce)。
2、具体而言,fcaf3d和tr3d属于卷积神经网络(cnn)类3d目标检测方法,其具有以下流程:
3、1. 将3d点云作为输入。
4、2. 将点云转换为体素网格,即3d图像表示。这通过对空间进行网格离散化来实现;如果在3d空间中的给定体元内存在至少一个点,则对应的3d体素将被视为被占据。可以将其视为像素化2d图像表示向3d域的推广。该体素化的一个重要参数是网格尺寸,通常在0.5厘米至30厘米之间。网格尺寸越大,3d表示的分辨率越低,因此模型后续预测的潜在质量越低。然而,增大网格尺寸能够降低后续流程的计算和内存成本。
5、3. 应用由多个3d卷积层组成的神经网络。这可以使用minkowski 引擎(c. choy、j. gwak和s. savarese,《4d时空卷积网络:minkowski卷积神经网络(
4d spatio-temporal
convnets: minkowski convolutional neural networks)》,arxiv,2019年6月13日。doi:10.48550/arxiv.1904.08755)来实现,该引擎允许在稀疏(大部分为空)的体素网格上高效计算3d卷积。
6、4. 目标检测方法输出多个预测,这些预测可能a)数量众多(超过一千个)的检测到的物体,并且b)彼此之间存在显著重叠。对此的一种直观理解是,检测模型将正确识别例如给定椅子的多个部分以及椅子本身,但将它们作为不同的检测结果输出。r-cnn(r.girshick、j. donahue、t. darrell和j. malik,《用于精准目标检测与语义分割的丰富特征层级结构(
rich feature hierarchies for accurate object detection and
semantic segmentation)》,arxiv,2014年10月22日。doi: 10.48550/arxiv.1311.2524)中引入的一种常见后处理算法是非极大值抑制(nms),该算法通过在相同语义类别(例如“椅子”)的较小预测与较大预测的重叠达到或超过设定阈值时移除该较小预测来解决这些问题。该后处理算法没有经过学习或以其它方式训练的参数。当将预测视为边界框时,该重叠通过交并比()来度量。对于3d边界框,这些并集和交集值被计算为体积;为清楚起见,其2d等效形式在图7中被可视化为面积。nms的示例性iou阈值为0.25和0.5。
7、利用室内场景的静态特性,当前最先进的室内3d目标检测方法通过移除与采集方法相关联的任何时间数据并简单地将所有输入分组在一起来预处理表示给定场景的数据。因此,它们可以被称为“离线”方法。离线方法强制对数据采集的顺序保持不变性,并迫使深度学习模型关注空间关系并考虑房间中的其它物体。然而,这也引入了一种偏差,即输入场景已被完整扫描,使得检测模型依赖于房间中的其它物体来引导预测,从而限制了其在在线检测场景中预测的质量。当考虑使用此类模型时,一个合理的要求是能够在采集期间向用户提供检测反馈,即对用户刚刚扫描的内容给出预测,这被称为在线检测。该要求的目的是建议是否需要对场景的给定部分进行进一步扫描,或者用户是否可以继续到场景的其它部分。
8、此外,为了在采集期间提供用户反馈,此类模型必须在整个场景的连续子集上进行完整评估,包括用户已经采集的点。这种次优方案需要冗余计算,从而增加了计算机资源的消耗。
9、试图解决在线问题的此类离线方法的一个示例是苹果公司的roomplan(《基于roomplan的3d参数化房间表示(
3d parametric room representation with roomplan)》,苹果机器学习研究。访问时间:2022年10月13日。[在线]。可获取:https://machinelearning.apple.com/research/roomplan)。为了能够实时重复检测物体,他们采用了以下设计选择:
10、1. 他们选择了具有15厘米大体素尺寸的3d cnn架构,这使得很难识别小于该尺寸的物体,例如书籍。如fcaf3d论文所示,将当前最先进的3d cnn的分辨率从1厘米降低到3厘米已经会总体上降低检测质量。这似乎是roomplan仅旨在检测大型物体的原因:“储物柜、沙发、桌子、椅子、床、冰箱、烤箱、炉灶、洗碗机、洗衣机或烘干机、壁炉、水槽、浴缸、马桶、楼梯以及电视机”。
11、2. 他们在在线扫描期间使用局部检测器从输入点云的不相交子集直接预测边界框,然后使用未公开的算法聚合这些边界框。
12、有人可能会争辩说,在线3d目标检测已经由通常为机器人技术或自动驾驶设计的室外目标检测方法实现。事实上,它们需要考虑时空关系,以便准确检测动态场景中可能被遮挡的物体。
13、然而,室外模型的任务是检测潜在障碍物,即大型物体,而房间(室内场景)同时包含大型家具和小型物体,例如书籍。此外,室外检测旨在检测各自占据其自身垂直空间的物体,例如行人或汽车;事实上,当前最先进的3d室外检测模型,例如pointpillars(a. h.lang、s. vora、h. caesar、l. zhou、j. yang和o. beijbom,《pointpillars:面向点云目标检测的快速编码器(pointpillars: fast encoders for object detection from pointclouds)》,发表于《ieee/cvf计算机视觉与模式识别会议论文集》,2019年,第12697至12705页。访问时间:2022年10月14日。[在线]。可获取:https://openaccess.thecvf.com/content_cvpr_2019/html/lang_pointpillars_fast_encoders_for_object_detection_from_point_clouds_cvpr_2019_paper.html)、bevfusion(z. liu等人,《bevfusion:基于统一鸟瞰图表示的多任务多传感器融合(
bevfusion: multi-task multi-sensor fusion
with unified bird’s-eye view representation)》,arxiv,2022年6月16日。doi:10.48550/arxiv.2205.13542)或ea-lss(h. hu等人,《ea-lss:面向3d bev目标检测的边缘感知升维-投影-聚合框架(
ea-lss: edge-aware lift-splat-shot framework for 3d
bev object detection)》arxiv,2023年8月29日。doi:10.48550/arxiv.2303.17895),通过将多传感器输入嵌入到统一的2d鸟瞰(即俯视)视图中来明确整合该先验知识。这种将3d问题简化为2d问题的方法不适用于室内场景,因为室内场景包含以真正3d方式布置的物体,例如悬挂的植物或桌子上的书籍。
14、此外,现有的离线和在线3d目标检测解决方案都仅考虑空间信息(通常是无纹理的点云),因此一些歧义通常难以解决。例如,小而扁平的物体只有在足够高的分辨率下才能在这种3d数据表示中可见。此外,一些物体之间的边界也可能无法区分(例如在厨房中一系列尺寸相同的长方体橱柜和电器),导致检测和/或标记它们的困难。
15、图1说明了这些困难。这些图显示了3d房间点云中物体的真实边界框。从点云的空间信息中无法捕捉到一些物体的边界和性质。
16、因此,需要改进的解决方案,用于在表示真实3d场景的3d点云中输出物体的局部化表示(例如用于目标检测或场景分割)。
技术实现思路
1、因此,本公开提供了一种用于机器学习函数的计算机实现的方法。函数配置为将真实场景的3d点云帧作为输入,并输出局部化表示。每个输出表示各自对应于真实场景中的相应物体。该方法包括获取3d点云帧序列的数据集。每个帧与序列中的时间相关联。每个帧包括各自对应于相应物体的局部化表示。一个或多个帧各自与表示由帧所表示的场景的至少一部分的相应图像相关联。该方法还包括基于所获取的数据集训练函数。训练包括针对数据集中的每个序列以及序列中的每个给定帧,训练函数,以基于以下各项输出给定帧中物体的局部化表示:给定帧;至少序列中具有前一时间的帧;以及如果可用,表示由给定帧所表示的场景的至少一部分的图像和/或表示由至少具有前一时间的帧所表示的场景的至少一部分的图像。
2、该方法可以包括以下一项或多项:
3、- 函数包括:
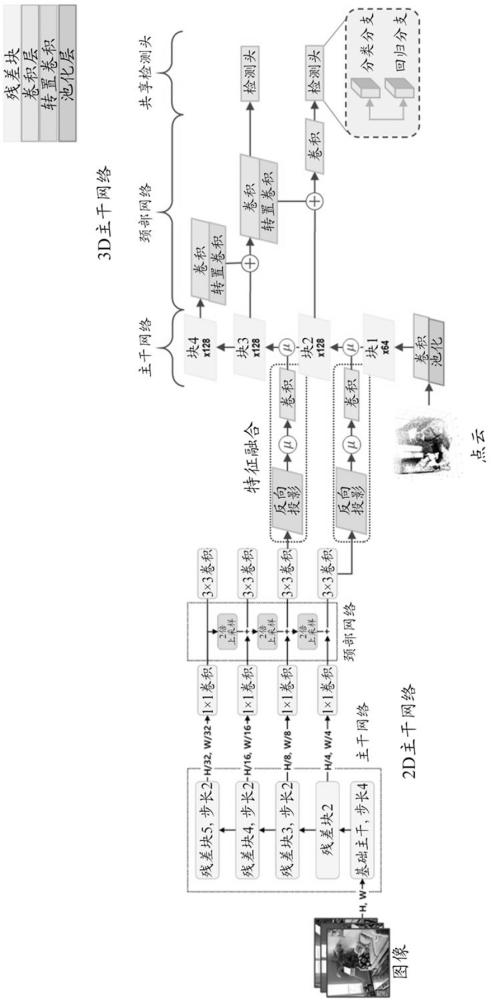
4、○ 第一局部神经网络,配置为将帧作为输入,并输出至少一个特征向量,特征向量对应于帧中各自对应于相应物体的局部化表示;
5、○ 第二局部神经网络,配置为将帧和表示由帧所表示的场景的至少一部分的图像作为输入,并输出至少一个特征向量,特征向量对应于帧中各自对应于相应物体的局部化表示;以及
6、○- 聚合神经网络,配置为聚合由第一局部神经网络和/或第二局部神经网络,针对给定帧以及至少具有前一时间的帧输出的特征向量;
7、- 第二局部神经网络包括:
8、○ 图像神经网络,配置为将表示由帧所表示的场景的至少一部分的图像作为输入,并输出至少一个图像的特征向量;
9、○ 帧神经网络,配置为将帧作为输入,并输出至少一个特征向量,特征向量对应于帧中各自对应于相应物体的局部化表示;
10、○ 特征融合模块,配置为将由图像神经网络输出的特征向量与由帧神经网络确定的中间特征向量进行融合,
11、帧神经网络配置为基于特征融合模块的结果输出至少一个特征向量,特征向量对应于帧中各自对应于相应物体的局部化表示,第二局部神经网络的输出是帧神经网络的输出;
12、- 第一局部神经网络配置为将帧作为输入,并输出两个或更多个特征向量,每个特征向量对应于不同的分辨率级别;
13、- 第二局部神经网络配置为将帧作为输入,并输出两个或更多个特征向量,每个特征向量对应于不同的分辨率级别,融合模块配置为至少在一个分辨率级别执行融合;
14、- 聚合神经网络配置为执行两个或更多个聚合,每个聚合对应于相同分辨率级别的特征向量;
15、- 融合保留特征维度;
16、- 第一局部神经网络是与特征金字塔网络(fpn)相关联的卷积神经网络(cnn);
17、- 图像神经网络是与fpn相关联的cnn,并且帧神经网络是与fpn相关联的cnn;
18、- 聚合神经网络是transformer神经网络和卷积的组合;
19、- 每个相应图像与用于采集图像的相机的参数相关联,融合基于相机参数;
20、- 训练包括批训练,其中,每个批次遵循帧时间顺序,使得在批训练期间,函数不基于与未来时间相关联的帧,为批次输出局部化表示;
21、- 在所获取的数据集中,每个点云帧序列由以下规则定义,其中,是时间
t处的点云帧并且包含个点:
22、
23、其中,
ceil是向上取整函数,并且是所述场景的深度图像序列,并且其中,是将深度图像的像素投影到3d点的反投影算子;和/或
24、- 场景是室内场景。
25、本公开还提供了一种可根据该方法获得的函数。
26、本公开还提供了一种使用该函数的计算机实现的方法。该使用方法包括提供真实场景的3d点云帧序列。一个或多个帧各自与表示由帧所表示的场景的至少一部分的相应图像相关联。该使用方法还包括针对序列中的每个帧,通过将函数应用于帧来确定帧中真实场景的各自对应于相应物体的局部化表示。如果可用,函数还应用于表示由帧所表示的场景的至少一部分的图像。函数的应用至少基于对应于前一帧中各自对应于相应物体的局部化表示的特征向量。如果可用,函数的应用还基于表示由前一帧所表示的场景的至少一部分的图像。
27、本公开还提供了一种包括用于执行方法和/或使用方法的指令的计算机程序。
28、本公开还提供了一种设备,该设备包括其上记录有计算机程序和/或函数的数据存储介质。
29、设备可以形成或用作非暂时性计算机可读介质,例如在saas(软件即服务)或其它服务器上,或者基于云的平台等。设备可替代地包括联接到数据存储介质的处理器。因此,设备可以整体或部分地形成计算机系统(例如,该设备是整个系统的子系统)。系统还可以包括联接到处理器的图形用户界面。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com