
一种用于卷积输入特征图的特征融合方法与流程
本发明属于智能视频处理,特别涉及一种用于卷积输入特征图的特征融合方法。
背景技术:
1、随着人工智能技术的迅速发展,神经网络的学习与应用日益广泛。神经网络的concat操作是一种常见的特征融合方法,它能够将不同层次或来源的特征信息结合起来,从而提高模型的性能和表现。
2、concat操作能够实现特征融合的一个重要原因是它可以增加特征的维度和多样性。通过将不同来源的特征拼接在一起,可以扩展特征的空间,使得模型能够看到更多的信息和变化。例如,在图像识别任务中,将卷积层和全连接层产生的特征分别拼接起来,这样就可以让模型同时关注图像的局部和整体信息,从而提高识别准确率。
3、concat操作还能够促进特征之间的交互和整合。由于不同层次或来源的特征具有不同的语义和表示方式,它们相互之间存在着互补和补充的关系。通过将它们拼接在一起,可以促进它们之间的交流和整合,进一步提高模型的表现。例如,在自然语言处理任务中,将不同的语言模型产生的特征拼接起来,这样就可以让模型学习到更广泛和深入的语言知识,从而提高其理解能力和生成能力。
4、concat操作用于将两个或多个张量在某个维度上连接在一起,生成一个更大的张量。这可以用于在深度学习模型中增加通道数或特征维度,以便在后续层中更好地捕获不同特征之间的关系。concat操作适用于张量的各个维度,但本专利只考虑通道维度。
5、示例:在卷积神经网络中,特征图通常具有形状为(batch_size,channels,height,width),如果要在通道维度上连接两个特征图,可以使用concat操作,结果是形状为(batch_size,channels1+channels2,height,width)的特征图。注意:在连接时,两个张量的维度(除了连接维度)必须保持一致。例如,在通道维度上连接时,其他维度的尺寸必须相同。
6、然而,现有技术中存在的缺陷在于:
7、在卷积神经网络中,通过concat操作实现特征融合增加了特征的维度和多样性,需要继续使用卷积层来进一步提取特征,因此许多神经网络中有concat+卷积的结构,比如在北京君正t40芯片上需要调用两个c语言函数接口来实现,例如:第一步使用concat函数concat_output_feature=concat(input_feature1,input_feature2),将两个输入特征图input_feature1和input_feature2经过融合后的得到特征图concat_output_feature;第二步使用卷积函数output_feature=convolution(concat_output_feature),将融合后的特征图经过卷积计算后得到结果output_feature。而这两步操作涉及到concat_output_feature保存到内存中和从内存加载到卷积函数中,数据频繁与内存交互占用带宽,影响了其他进程使用带宽,从而导致其他进程速度变慢。保存和加载这两个操作本身也需要时间,从而导致concat+卷积整体时间增加。
8、此外,本领域的技术术语包括:
9、1.simd全称single instruction multiple data,单指令多数据流,能够一次处理多个操作数,并把它们打包在大型寄存器的一组指令集。
10、2.神经网络中特征的概念:神经网络通过对输入数据的层次化处理,逐步提取出越来越抽象、更加含义丰富的特征表示。其中,每个层次的特征都有其独特的意义和贡献,但相互之间也存在着关联和依赖。因此,将不同层次或来源的特征信息有机地结合起来,能够增强模型的鲁棒性、泛化能力和准确性。
11、3.在深度学习中,特征融合(feature fusion)是一种将不同特征图或不同层的输出进行组合的技术,旨在提升模型的表现。特征融合主要用于增强特征表示能力,特别是在处理多尺度特征、跨模态任务、以及需要融合多个来源的信息时尤为重要。
12、4.卷积是卷积神经网络中较为核心的网络层,主要进行卷积操作,抽取图像局部特称,通过这些局部特征进行连接,可以形成整体特征。一个卷积核就相当于一个滤波器,用来提取感兴趣的信息。
技术实现思路
1、为了解决上述问题,本技术的目的在于:本方法适用于图像识别,语音识别等领域,本方法省去单独调用concat函数接口这一步,将两个输入特征图input_feature1和input_feature2传入一个函数接口可以直接得到输出特征图output_feature,中间融合特征图concat_output_feature不需要保存出来,本发明的函数接口为concat_convolution,该函数只需要对输入特征图进行特殊加载,就可以完成与concat相同的操作,减少了函数调用次数,从而减少了数据占用带宽时间,让出带宽供其他进程使用,如果同时进行多个进程,则总体的效率可以提高。去除中间保存concat结果数据和加载数据的simd操作,可以减少concat+卷积整体时间。
2、具体地,本发明提供一种用于卷积输入特征图的特征融合方法,所述方法用卷积输入特征图的特征融合代替concat与卷积分开计算,只需在concat_convolution函数中先加载input_feature1数据放到fram的低半部分,再加载input_feature2数据放到fram高半部分,就完成了concat函数中相同的通道拼接操作,再经过卷积计算可以直接得到输出特征图output_feature,避免了额外的concat函数计算,减少了一次concat函数的计算时间,中间结果不需要保存出来,从而减少数据占用带宽次数,让出带宽供其他进程使用,减少总体计算时间;所述方法在硬件资源有限的芯片上运行,通过使用ingenic_simd512指令集,提高缓存利用率和计算效率。
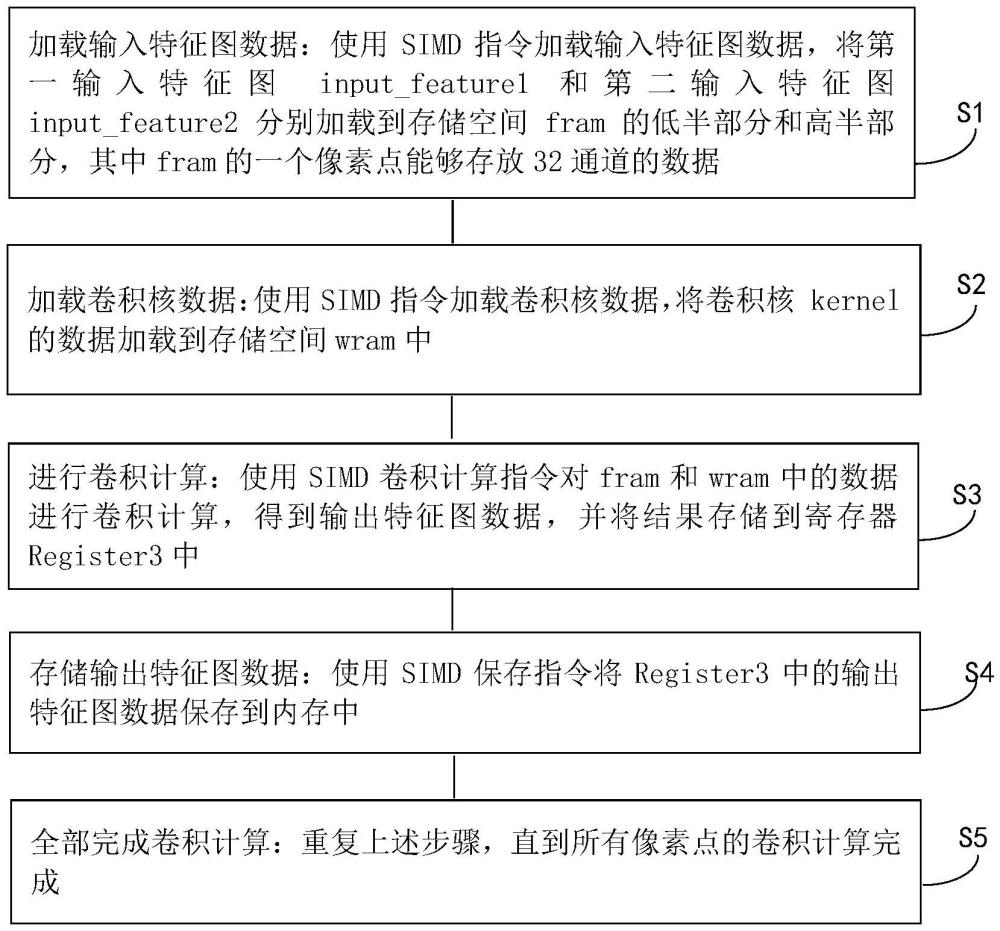
3、所述方法包括以下步骤:
4、s1,加载输入特征图数据:使用simd指令加载输入特征图数据,将第一输入特征图input_feature1和第二输入特征图input_feature2分别加载到存储空间fram的低半部分和高半部分,其中fram的一个像素点能够存放32通道的数据;
5、s2,加载卷积核数据:使用simd指令加载卷积核数据,将卷积核kernel的数据加载到存储空间wram中;
6、s3,进行卷积计算:使用simd卷积计算指令对fram和wram中的数据进行卷积计算,得到输出特征图数据,并将结果存储到寄存器register3中;
7、s4,存储输出特征图数据:使用simd保存指令将register3中的输出特征图数据保存到内存中;
8、s5,全部完成卷积计算:重复上述步骤,直到所有像素点的卷积计算完成。
9、所述方法中,设定第一输入特征图input_feature1和第二输入特征图input_feature2input_feature1和input_feature2像素值是8bit整数,第一输入特征图input_feature1的宽input1_w=3,高input1_h=3,通道input1_c=16,第二输入特征图input_feature2的宽input2_w=3,高input2_h=3,通道input2_c=16,卷积计算的卷积核kernel的宽kernel_w=3,高kernel_h=3,输入通道input_c=32,输出通道output_c=1,输出特征图output_feature的宽output_w=1,高output_h=1,通道output_c=1。
10、所述步骤s1中,特征图的第一个像素点索引input_h=0,input_w=0开始加载,先使用ingenic_simd512_nndwrf将input_feature1第一个像素点的16个通道数据加载到fram第一个像素点的低半部分,再使用ingenic_simd512_nndwrf将input_feature2第一个像素点的16个通道数据加载到fram第一个像素点的高半部分,表示为:
11、fram=ingenic_simd512_nndwrf(input_feature1);
12、fram=ingenic_simd512_nndwrf(input_feature2)。
13、所述步骤s2中,simd加载卷积核数据的指令为ingenic_simd512_nndwrw,用于将卷积核kernel的数据加载到存储空间wram中;将卷积核kernel的第一个像素点索引kernel_h=0,kernel_w=0的数据加载到存放卷积核的存储空间wram中,表示为:wram=ingenic_simd512_nndwrw(kernel)。
14、所述步骤s3中,simd卷积计算指令为ingenic_simd512_nnamac,用于对fram和wram中的数据进行卷积计算,并将结果存储到寄存器register3中;使用simd卷积计算指令ingenic_simd512_nnamac将存储空间fram和wram中的数据进行卷积计算得到输出特征图数据,将输出特征图数据放到寄存器registe3中,表示为:
15、registe3=ingenic_simd512_nnamac(fram,wram)。
16、所述步骤s4中,simd保存指令为ingenic_simd512_store,用于将寄存器register3中的输出特征图数据保存到内存中;
17、使用simd保存指令ingenic_simd512_store将register3中的值保存到内存中,表示为:
18、output_feature=ingenic_simd512_store(register3)。
19、所述步骤s5中,对输入特征图的每一个像素点的数据重复s1~s4的步骤,直到特征图宽input1_w=3,高input1_h=3一共9个像素点全部完成卷积计算。
20、所述方法适用于多进程并行计算场景,通过减少数据带宽占用和计算时间,提高总体计算效率。
21、所述方法通过去除了一次concat函数的计算时间,中间结果的保存和加载操作,进一步优化了卷积计算的性能,适用于实时计算和高性能计算场景。
22、由此,本技术的优势在于:
23、1.所述方法通过将input_feature1和input_feature2的数据直接加载到fram的低半部分和高半部分,完成通道拼接操作,避免了额外的concat函数计算,减少了中间结果的存储和加载操作,从而降低了数据带宽占用和总体计算时间;所述方法在硬件资源有限的芯片上高效运行,通过使用ingenic_simd512指令集,提高了缓存利用率和计算效率。
24、2.所述方法适用于多进程并行计算场景,通过减少数据带宽占用和计算时间,提高总体计算效率。
25、3.所述方法通过去除中间结果的保存和加载操作,进一步优化了卷积计算的性能,适用于实时计算和高性能计算场景。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com